 AI-Papers
- 画像を固定の視覚エンコーダで圧縮せず、軽量な畳み込みパッチ埋め込みで直接トークン化する2BパラメータのネイティブVLAを提案
- LIBERO平均97.4%、LIBERO-Plus 89.7、RoboTwin 2.0のClean 75.78を記録し、実機タスクでもπ0.5を上回る成功率を示した
- 層別プロービングにより、行動制御に効く視覚信号が最終視覚層より手前の浅い層でピークに達することを実証
研究の背景
ロボットにカメラ画像と言語指示を与えて動作を出力させるモデルを、Vision-Language-Action(VLA)モデルと呼びます。近年のVLAはほぼ例外なく、CLIPやSigLIPのような学習済みの視覚エンコーダ(画像を特徴ベクトルに圧縮する専用ネットワーク)を前段に置き、その出力を言語モデルに渡す構成を採ってきました。
この構成には落とし穴があります。視覚エンコーダは画像分類や画像テキスト対応の学習で鍛えられているため、「何が写っているか」を要約するのは得意ですが、物体の奥行き、わずかな姿勢の違い、接触の有無といった操作に不可欠な細部を捨ててしまいがちです。言語で説明しやすい情報だけが残り、手先を数ミリ動かすために必要な幾何情報が失われるわけです。
Nanyang Technological UniversityやSenseTimeなどの研究チームが発表した「From Pixels to Actions」は、この前段を丸ごと取り払うという選択をしました。提案モデルNEO-VLAは、視覚エンコーダもオートエンコーダもベクトル量子化のコードブックも持たず、生のピクセルから連続的な行動を出力します。
提案手法
NEO-VLAの視覚経路は、ストライド32の2段構成の畳み込みによるパッチ埋め込みだけです。これが画像を直接バックボーンのトークン空間に写し、以降は視覚トークンと言語トークンが同じ40層のモデル内で一緒に更新されていきます。視覚表現が言語理解や行動生成と共進化する点が、従来の「凍結した視覚エンコーダ+言語モデル」との決定的な違いになります。
バックボーンは2Bパラメータのエンコーダ不要な視覚言語モデルで、テキストは因果的注意、画像ブロック内の視覚トークンは双方向注意という使い分けをしています。位置情報は時間・縦・横の3次元回転位置埋め込みで表現し、1時刻あたり最大3視点、1視点あたり最大88トークンを扱います。カメラの内部パラメータと回転、ロボットの現在状態と直前状態もそれぞれMLPで埋め込み、制御周波数や身体構成、座標系の基準、タスク指示を記した構造化プロンプトと結合されます。
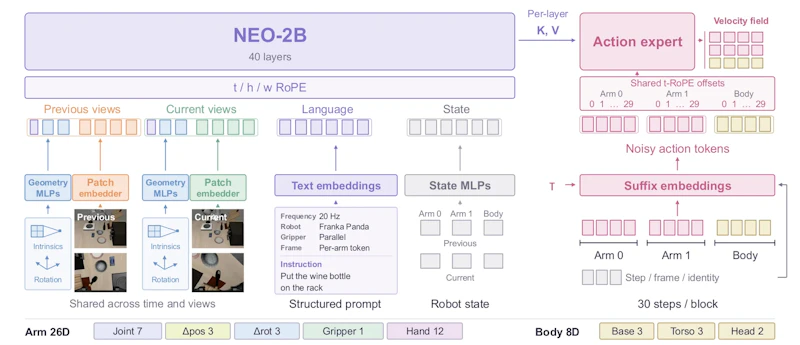
図1に示すように、行動生成は本体とは別の細い行動エキスパートが担います。これはランダム初期化された小さなモジュールで、バックボーンの選択した層にキャッシュされたキーとバリュー、そして自身の行動トークンのキーとバリューの両方に注意を向けます。学習はFlow Matching(ノイズから目標へ向かう速度場を学ぶ生成手法)で行い、腕と胴体それぞれ30ステップ分の行動チャンクを一度に予測します。推論時は10回のオイラー法ステップで、分類器フリーガイダンスは使いません。
事前学習は9つの公開データセット群から集めた約223万エピソード(9,927時間)を使い、バックボーンを凍結した段階、理解データを併用した全体微調整、自前の行動データでの全体微調整という3段階で進められました。
行動に効くのは浅い層
この論文で実装の指針として有用なのが、行動エキスパートがどの層を参照すべきかを調べた層別の分析です。参照する層の組み合わせを変えて比較すると、バックボーンを凍結した条件ではlayers 0から27を使うfirst-28がLIBERO平均94.9%で最も高く、後半のlayers 12から39を使うend-28は86.7%まで落ちました。全体微調整を行うと差は縮まりますが、順序は大きく変わりません。
介入実験でも同じ傾向が見えます。layers 0から10のキーとバリューを入れ替えたときに並進誤差が最も大きくなり、手首カメラ画像への感度はおおむねlayers 6から10でピークに達しました。つまり行動に効く視覚信号は最終視覚層より手前で最も強く、最後まで通すと薄まるということです。従来のVLAが視覚エンコーダの最終層出力だけを行動側に渡していたのは、設計として損をしていた可能性があります。
バックボーンの比較も興味深い結果でした。LIBERO平均で、Qwen3-VL-2Bは凍結79.5%、全体微調整90.8%、Gemma-3-4Bは84.5%と91.0%でしたが、NEO-VLA-2Bは90.9%と95.3%に達しました。Qwen3-VLの行動エキスパートに視覚タワーの中間特徴へ直接アクセスさせても凍結時は64.9%に下がり、中間層を覗かせるだけでは不十分で、視覚表現そのものが言語と共に学ばれている必要があることを示しています。
実験結果
主要なシミュレーションベンチマークの結果をまとめます。LIBERO-Plusは視点や照明、背景、言語表現などを変えた頑健性の評価、RoboTwin 2.0は両腕マニピュレーションの評価です。
ベンチマーク | スコア |
|---|---|
LIBERO 平均 | 97.4(Spatial 98.4 / Object 99.4 / Goal 95.6 / Long 96.2) |
LIBERO-Plus 合計 | 89.7(コードと重みが公開されたモデル中で最高) |
LIBERO-Pro 平均 | 47.9(Semantic 98.0 だが Position 3.0) |
RoboTwin 2.0 Clean | 75.78(Clean-to-Randomized 69.40) |
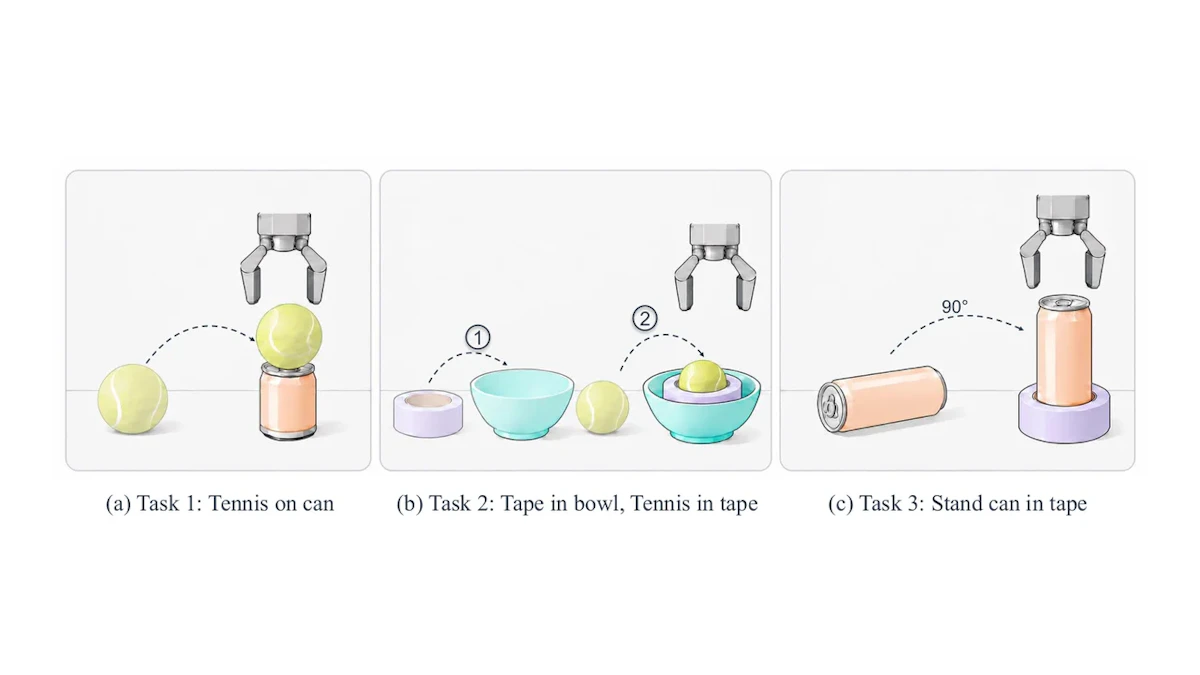
実機検証は、缶の上にテニスボールを置く、テープロールをボウルに入れてからボールをロールの中に置く、横倒しの缶を起こしてテープロールに差し込むという3タスクで行われました。各シーン50エピソードで微調整し20試行で評価した結果、NEO-VLA(2B)は12/20、17/20、13/20で、より大きなπ0.5(3B)の10/20、14/20、13/20を上回っています。
図2の3タスクは単純に見えますが、缶を起こして差し込む動作などは姿勢推定の精度が直接成否に効くため、エンコーダで失われがちな幾何情報の扱いを測る設計になっています。理解データの併用学習も効いており、RoboTwinのClean-to-Randomizedは行動データのみの微調整で10.7%だったものが、併用で69.4%まで改善しました。
速度面では、RTX 3090でbf16・10ステップの条件でコンパイル済み順伝播が282.5ms、ロボット側から見た要求から行動チャンク取得までが261.9msと報告されています。ステップ数を2に落とせば178.5msまで短縮できます。ロボット制御の文脈では、研究室のGPUで実用域に入る水準です。
まとめと今後の展望
NEO-VLAは、VLAの定石だった固定視覚エンコーダを外しても性能が落ちないどころか、同規模の比較条件では上回ることを示しました。視覚表現を行動学習と一緒に育てる方向性は、潜在アクション表現を動画モデルから引き出すDreamXのような研究とも補完的で、VLAの前段設計を見直す流れを後押しするはずです。
一方で課題も残っています。LIBERO-Plusではロボット本体の違い(72.6)やレイアウト変化(82.4)への耐性が相対的に弱く、LIBERO-Proでは物体位置が変わるPositionが3.0、タスク目標が変わるTaskが6.3と大きく崩れました。意味理解は保てても空間的な汎化は不十分で、訓練分布への依存が残っていることになります。RoboTwinのClean設定でも最上位のクローズドモデルには及びません。
著者ら自身も、事前学習データとモデル容量の違いがあるため、性能向上をエンコーダ廃止だけに帰属させることはできないと明記しています。コードはGitHubのEvolvingLMMs-Labで公開されているため、同条件での追試や他のバックボーンへの移植を通じて、どこまでが設計由来の効果なのかが今後明らかになるでしょう。
論文情報: "From Pixels to Actions - Towards Native Vision-Language-Action Policies"(Weichen Fan et al., 2026) arXiv:2611.06918, CC BY 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


