 AI-Papers
- シーンや視点が切り替わる長尺マルチショット動画を、一貫性を保ったまま編集する枠組みMoviEditが提案されました
- 多視点同期映像・実写・生成動画の3系統から、手作業の注釈なしで86,619組の編集ペアを自動構築しています
- 専用ベンチマークMoviEdit-Benchで編集成功率0.790を記録し、オープンソース勢を大きく上回りました
研究の背景
動画編集AIの研究は、ここ数年で大きく進みました。しかし対象のほとんどは、カメラが切り替わらない数秒の単一ショット映像に限られていました。
実際の映像作品は違います。同じ登場人物が別の角度から映り、場面が切り替わり、途中で被写体の見え方も変わります。「赤い上着の男性を青い上着に変えて」という1つの指示を、カットをまたいで同じ人物に対して矛盾なく適用しなければなりません。
これは単に扱う尺が長くなるという話ではありません。ショットをまたいで同じ対象を同一視する能力(クロスショットの対応付け)と、数百フレームにわたる長い視覚文脈の処理という、2つの新しい難しさが同時に生じます。Adobe Research とKAISTなどの研究チームが発表したMoviEditは、この課題にデータ・モデル・評価の3面から取り組んだ研究です。
87Kペアを自動で作る
最大の障壁は学習データでした。「編集前のマルチショット動画」と「編集後のマルチショット動画」のペアは、現実には存在しません。人手で作れば膨大なコストがかかります。
研究チームは、人間の注釈を一切使わない3種類の自動生成パイプラインを設計しました。1つ目のピクセル整合パイプラインでは、同じシーンに属する各ショットの先頭フレームをグリッド状に並べ、画像編集モデルで一括編集します。その後、先頭フレームを条件とする単一ショット動画編集モデルが、各ショット内部へ編集を伝播させます。グリッドで同時に編集することで、カット間で色や形が食い違うことを防ぐ仕組みです。
2つ目の被写体位置特定パイプラインは、セグメンテーションモデルで指定された被写体をショット横断で追跡し、そのマスクにハイライト・輪郭線・塗りつぶしといった効果を付けます。3つ目の半ピクセル整合パイプラインでは、事前学習済みのマルチショット動画生成モデルを使い、ショットごとの説明文と初期ノイズを共有させながら編集前後の動画を生成します。これにより、物体の形状が大きく変わるような編集も学習対象に含められます。
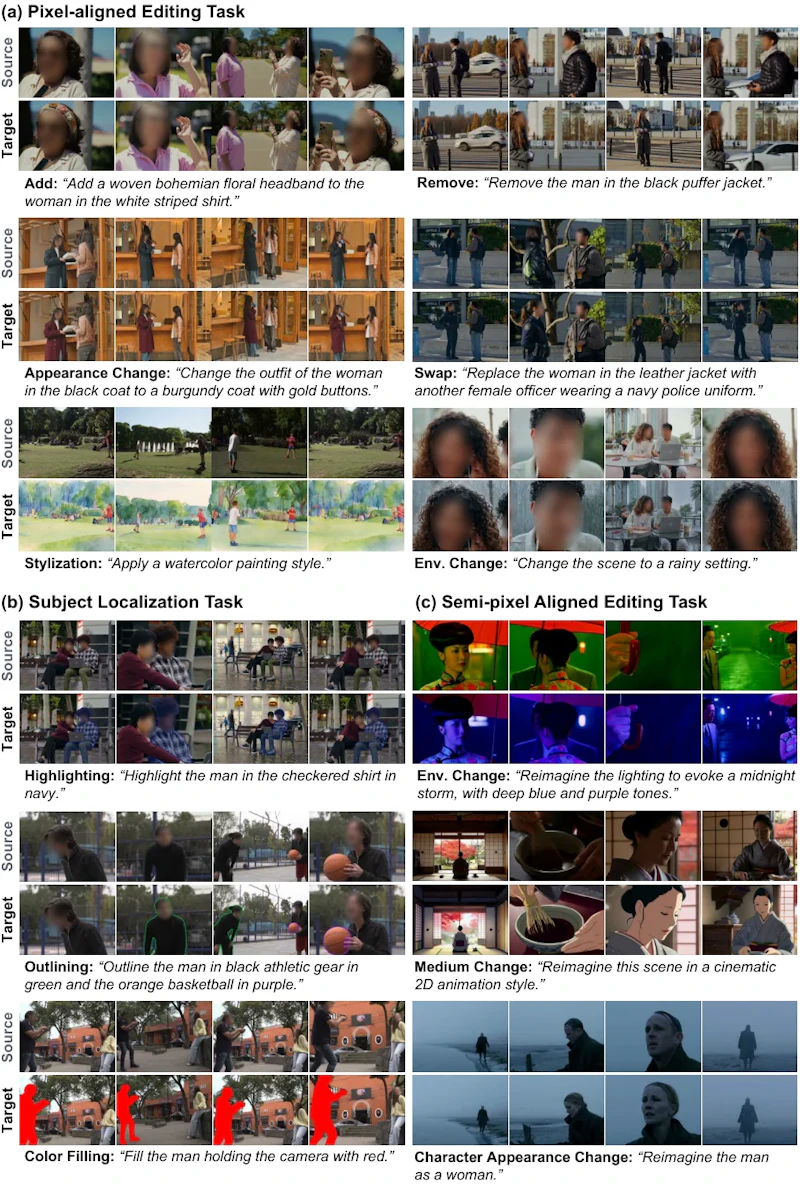
図1は、各パイプラインが生成した編集ペアの実例です。素材は、俳優の自然な演技を2〜4台のカメラで同時撮影した同期映像1,147本、映画的な実写クリップ32,474本、生成動画27,630本の合計61,251本です。ここから20万組超の候補を作り、画像品質や編集の妥当性を自動判定するフィルタを通して86,619組が採用されました。クリップは540p、約15秒、24fpsで、1本あたり4〜6ショットを含みます。
下書きと本番の2段構成
モデル側の課題は、長い動画を一度に処理できないことです。361フレームすべてにわたって双方向の注意機構(全フレームが互いを参照する仕組み)を使うと計算量が爆発します。一方、チャンクごとに前から順に生成する自己回帰方式では計算は収まりますが、誤差が蓄積して後半で色あせや彩度の異常が起きます。
MoviEditは両者をカスケード接続することで折衷します。まずDraft Editorが、フレームを間引いて解像度も落とした圧縮表現の上で双方向の拡散処理を行い、動画全体で整合した編集の「下書き」を作ります。次にRender Editorが、この下書きと元動画、直近の文脈を条件として、フル解像度の映像をチャンク単位で因果的に生成していきます。
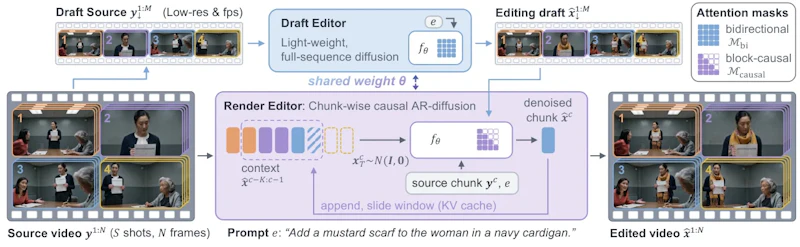
図2のとおり、2つの段は同じ重みを共有し、注意機構のパターンと解像度だけが異なります。基盤はMixture-of-Experts型のDiffusion Transformer(DiT)で、短尺の単一ショット編集モデルから初期化されています。テキストエンコーダと動画VAEは凍結したまま、64基のH200 GPUで全体を再学習しました。
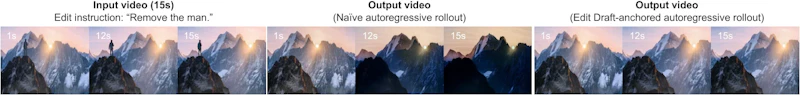
下書きを挟む効果は図3で明確です。素朴な自己回帰では編集後の見た目が徐々にずれて彩度が崩れていきますが、下書きを条件に加えると終盤まで安定します。推論の高速化も進められ、スライディングウィンドウ注意とKVキャッシュ、さらに蒸留を組み合わせることで、540p・361フレームの処理が364.1秒から11.8秒へ約31倍に短縮されました。自己回帰的な動画生成の高速化という点では、Wave Forcingのようなストリーミング生成の研究とも関心が重なります。
MoviEdit-Benchの中身
評価基盤も新しく整備されました。MoviEdit-Benchは生成されたマルチショット動画64本と編集シナリオ128件から成り、各動画は約15秒・361フレームです。被写体の指定difficultyに応じて8段階のカテゴリに分かれ、局所編集(追加・削除・見た目変更・置換)が75%、全体編集(環境変更・スタイル変換)が25%を占めます。
採点は7つの観点で行われます。
- 編集対象外の領域が保たれているか(マスク外のLPIPS)
- 編集が正しい対象に当たっているか(VLMによる適合率と再現率)
- 被写体の動きと属性が保たれているか
- ショットをまたいで編集が一貫しているか
- 指示文との整合(CLIP、ViCLIP、VLM)
- 映像品質(フレーム間類似度、NIQE、PickScore)
ここでVLMとはVision-Language Model(視覚と言語を同時に扱うモデル)で、人手評価の代わりに編集の成否を判定します。総合指標の「編集成功率」は、サンプリングしたフレームのうち該当する全基準を満たした割合として定義されます。
実験結果
テキスト指示による動画編集(V2V)での総合編集成功率は次のとおりです。
モデル | 編集成功率 |
|---|---|
SDEdit (HoloCine) | 0.193 |
Lucy Edit | 0.235 |
Wan-Edit | 0.378 |
Gemini Omni Flash | 0.586 |
HappyHorse-1.0 | 0.623 |
Aleph 2.0 | 0.764 |
MoviEdit | 0.790 |
オープンソースのモデル群が0.4を下回る中、MoviEditは0.790に達し、商用フロンティアモデルと肩を並べました。個別指標でも、編集対象外のLPIPSが0.0741で最小、位置特定の適合率0.904・再現率0.861、ショット間一貫性0.904という値が報告されています。
編集済みフレームを参照として与える画像ガイド編集(IV2V)では、先頭フレーム参照の条件でAleph 2.0が0.806、MoviEditが0.803とわずかに下回りました。一方、任意フレームを参照にする条件ではMoviEditが0.786で上回っています。学習は15秒までの動画で行われましたが、17ショットを含む25秒の映像にも破綻なく適用できたとされ、学習尺を超える一般化も確認されました。
課題と今後
限界も報告されています。見た目の似た被写体が複数いる場合、編集が意図しない対象に適用されることがあります。被写体が部分的にしか映っていないショットでは、ショット間の対応付け自体が失敗します。
また、この手法が扱うのは元映像との対応関係を保つ編集です。動きそのものを作り替えたり、物語構造を変えたりといった自由度の高い改変は対象外です。データ生成が既存の画像編集モデルや動画生成モデルに依存している点も、品質の上限を決める要因になります。
とはいえ、長尺マルチショットという実務に近い設定を正面から扱い、ベンチマークを公開した意義は小さくありません。プロジェクトページで結果が確認できるため、現状の到達点を自分の目で見極められます。
論文情報: "MoviEdit: Long-form Multi-Shot Video Editing Made Easy"(Suhyeon Lee et al., 2026) arXiv:2611.02737
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


