 AI-Papers
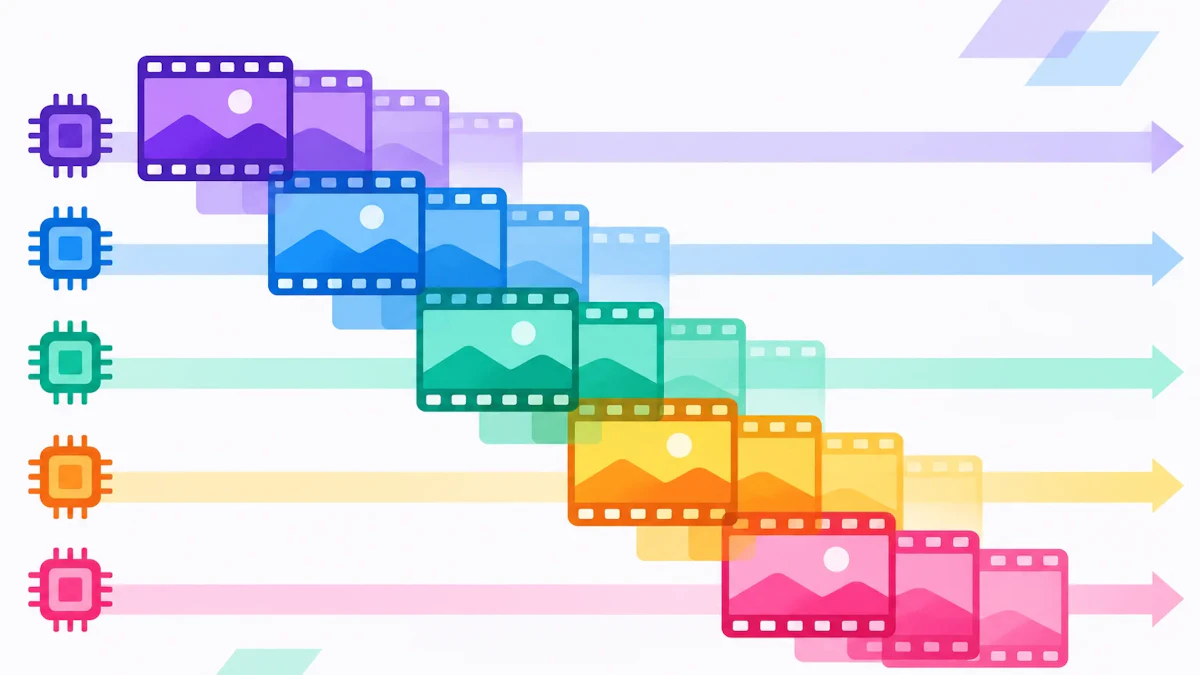
- チャンク単位の因果アテンションとずらし denoising により、1ラウンドで1チャンクを出力する波状スケジュールを実現
- Wan2.1-T2V-1.3B の4ステップ版が8GPUで端から端まで134.8 FPS、単一GPU比7.07倍のスループットを達成
- Rolling Forcing と同等の品質を保ちながら Dynamic Degree を大きく改善、一方で学習手順の複雑さが課題として残る
研究の背景
長尺の動画をリアルタイムに流し続ける生成、いわゆるストリーミング動画生成では、途切れずに出力を出しながら見た目の一貫性と自然な動きを保つ必要があります。現在主流のやり方は、動画を短いチャンク(数フレームのまとまり)に区切り、前のチャンクを条件として次を自己回帰的に作る方式です。
この方式には構造的な遅さがあります。1つのチャンクを仕上げるには denoising(ノイズを少しずつ取り除く処理)のステップごとにモデルの順伝播が必要で、さらに履歴キャッシュを更新するための順伝播も加わります。しかもチャンクを順番に作る限り、これらの計算は直列に並んでしまいます。
加えて、長時間の生成を続けると品質が劣化したり、カメラ視点がじわじわとずれていく「ドリフト」が起きやすくなります。Wave Forcing(WF)は、この速度と安定性の両方を、生成方式・学習手法・実行系の3つをまとめて設計し直すことで解こうとした研究です。上海交通大学などの研究者が2026年10月に arXiv で公開しました。
波状スケジュールの考え方
WF の中心にあるのは、チャンク単位の因果アテンションです。各チャンクの内部では通常の全結合アテンションを使いますが、チャンク間では「自分自身と、自分より綺麗な(ノイズの少ない)先行チャンク」だけを参照し、後続のよりノイズの多いチャンクは見ません。
重要なのは、参照先が「完成済みのチャンク」に限られない点です。まだ denoising の途中にある先行チャンクでも、自分より綺麗であれば条件として使えます。この一方向性があるおかげで、複数のチャンクの処理を時間的に重ねられるようになります。
そこで WF は denoising のタイミングをチャンクごとにずらします。新しいチャンクはノイズから始まり、古いチャンクはすでに後半のステップに進んでいる、という斜めの波面(wavefront)が並びます。各ラウンドで全ステージを1歩ずつ進め、全ステップを終えたチャンクについてはクリーンな K/V キャッシュを更新する処理を走らせます。
この結果、パイプラインが満たされた後は1回の同時順伝播ラウンドごとに1チャンクが完成します(1F1C)。1チャンクあたりの計算量そのものは変わらず(ステップ数 S に加えて保存用の1回)、速くなるのは並行実行によるという整理です。最初の出力までは充填分の遅延が残り、定常状態の出力間隔は最も遅いステージが決めます。
実行系 Wave Runtime
この波状スケジュールを実際のGPUで回すために、著者らは Wave Runtime(WaveRT)という実行系を用意しました。各 denoising ステージと保存ステージに、モデル全体を載せたGPUレプリカを1台ずつ割り当てる構成です。
注目点は、Ulysses や Ring のような文脈並列(1回の順伝播を複数GPUで分割する方式)とは発想が異なることです。WF の Wave Parallelism(WP)は、アテンション演算を割るのではなく、チャンクとステージの組み合わせというタスク単位で並列化します。
通信を隠すための工夫も入っています。各層の K/V を QKV 射影と RoPE の直後に即座に公開し、層の境界で待たせません。受け取る側は自分のローカル計算を進めながら K/V の到着を待ち、アテンション直前に層ごとの準備フラグを確認します。K/V はページ化した固定スロットに直接書き込むため、遠隔でのつなぎ合わせも不要になります。VAE デコーダも計測した処理時間に基づいて分割し、DiT の出力ペースに追従させています。
3段階の学習手順
ずらし denoising でモデルが見る入力は、通常の学習とは分布が違います。そのため WF は3段階の学習を組みます。まず RF と SF のロールアウトを等確率で混ぜた初期化、次に連続する教師チャンクをずらしたタイムステップで再ノイズ化し、DMD(分布マッチング蒸留)に LPIPS 項(重み0.25)を加えた動き監督、最後に自己生成履歴を使った因果適応です。
この3段階がどれも効いていることは ablation(部分を外した比較)で示されています。off-policy DMD を外すと VBench-Long の Quality が80.89から76.68、Dynamic Degree が74.97から15.73へ落ち、RF 分岐を外すとドリフトが0.36から6.24へ悪化します。WF 分岐を外すと動きが乏しくなり、SF 分岐を外すと品質と被写体の保持が下がりました。
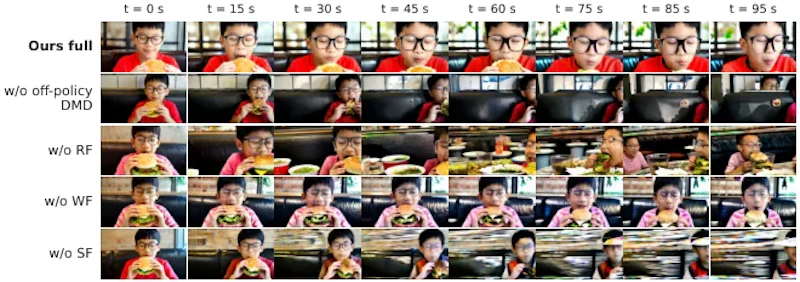
図1はその定性比較です。どの分岐を落としても、動きが止まる、構図が崩れる、被写体が入れ替わるといった形で欠陥が現れることが見て取れます。
実験結果
基盤モデルは Wan2.1-T2V-1.3B です。品質評価には VBench と VBench-Long に加えて、被写体の保持率とカメラドリフトという2つの安定性指標が使われています。
手法 | ステップ | VBench Total | Dynamic Degree | 被写体保持 | ドリフト |
|---|---|---|---|---|---|
Rolling Forcing | 5 | 81.15 | 51.39 | 92.75 | 0.17 |
Causal Forcing(全結合) | 4 | 79.61 | 100.00 | 71.11 | 11.14 |
Wave Forcing | 4 | 80.74 | 84.72 | 91.88 | 0.36 |
Wave Forcing | 5 | 81.64 | 94.44 | 97.10 | 0.37 |
5ステップ版は総合品質で Rolling Forcing と肩を並べつつ、Dynamic Degree が短尺で51.39から94.44、長尺で36.63から91.45へ伸びています。つまり、静止画のように動かない失敗を避けながら安定性を保てたということです。Causal Forcing は動きの指標は高いものの、被写体保持71.11・ドリフト11.14という値で、著者らは安定性の面で実用に耐えないと評価しています。
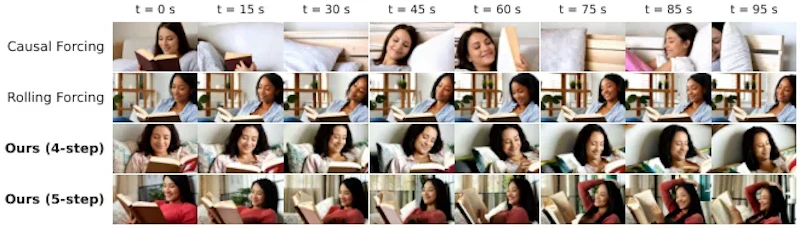
図2の定性比較でも、Causal Forcing では時間が進むにつれて場面が別物に変わっていく一方、Wave Forcing は被写体と構図を保ったまま動きを持たせています。
速度面では、H200 8枚で4ステップ版が DiT 単体147.6 FPS、VAE を含む端から端まで134.8 FPS に達しました。単一GPUの19.06 FPS に対して7.07倍です。14B 規模でも8GPUで最大33.50 FPS(単一GPU 5.51 FPS に対し6.08倍)を記録しています。WP と文脈並列の比較では、1.3B で WP 150.09 FPS に対し Ulysses 80.60 FPS、Ring 41.19 FPS でした。SageAttention と W8A8 を併用した条件では、1.3Bから14Bまでの6規模で速い側の文脈並列の1.025倍から2.530倍の範囲に収まっています。動画モデルの内部表現を他タスクへ転用するFrameForgeのような研究とは方向が違い、こちらは推論の実行効率そのものを詰めた仕事と言えます。
まとめと今後の展望
Wave Forcing は、チャンク間の参照方向を整えることで denoising を重ね合わせ可能にし、その構造を前提に学習と実行系まで設計したところに特徴があります。計算量を削るのではなく並行性を引き出すアプローチなので、GPU を増やせる環境では素直に効きます。
一方で課題も明記されています。ステージ並列の台数がステップ数と等しいためパイプラインの規模が制限され、モデルが大きくなるほど WP の文脈並列に対する優位は縮まります。9B 規模では Ulysses に1.53%ながら負けています。
評価指標についても、VBench が長時間ストリームの品質を十分に捉えきれていないこと、安定性診断が100プロンプトの部分集合と幾何的なヒューリスティックに依存しており人間の判断との一致が未検証であることが述べられています。学習手順の複雑さの簡略化、そしてスループットの高さが入力から出力までの低遅延を意味するわけではないという点、プロンプト切り替えやカメラ制御といった対話的な利用の評価が今後の論点として残されています。
論文情報: "Wave Forcing: Towards Speed-of-Light Streaming Video Generation"(Yijie Jin et al., 2026) arXiv:2611.00859
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


