 AI-Papers
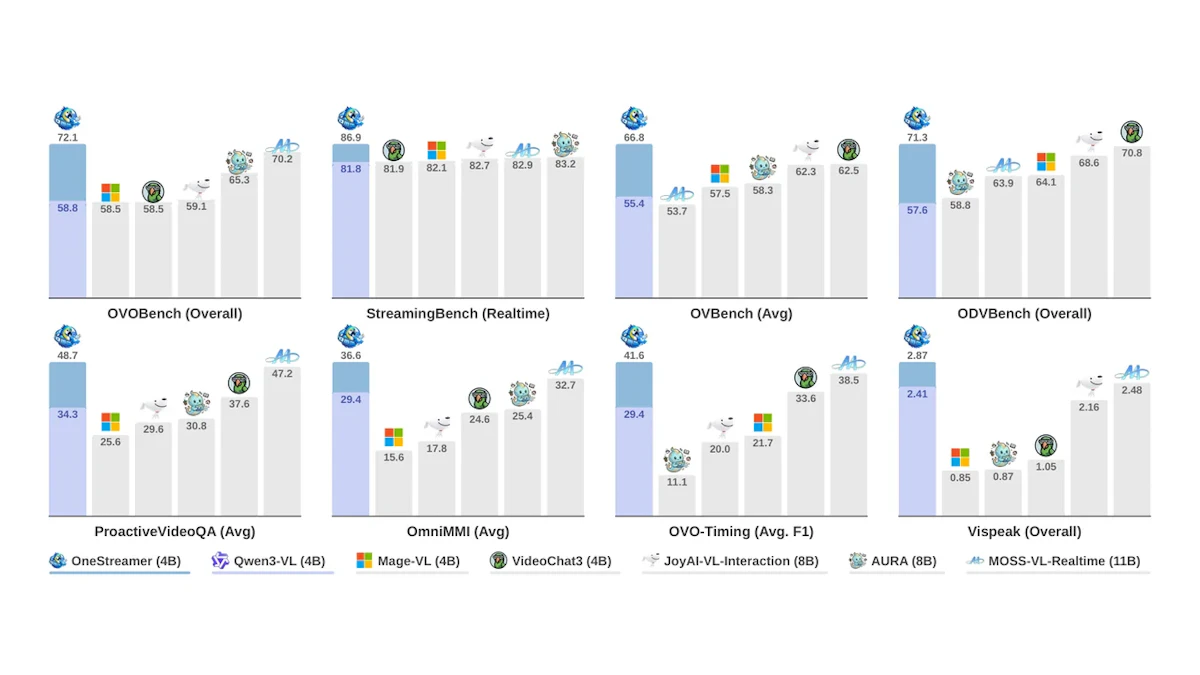
- 過去の映像を文字記録に変換して保持する Proactive Hierarchical Caption Memory により、全履歴保持と比べて文脈トークンを93.1%削減
- 「黙って見続ける」状態トークンの偏りを抑える Proactive State Transition Learning で、注釈の27.5%の教師信号でも密な教師付けを上回る性能
- 100万件規模のデータセット OneStreamer-1M を構築し、4Bモデルで8つのストリーミング動画ベンチマーク全てで最高性能、Qwen3-VL比で平均25.0%の相対改善
研究の背景
動画を扱う大規模言語モデル(Large Language Model、LLM)の多くは、再生が終わった動画をまとめて受け取り、質問に答えるという前提で作られています。しかし監視カメラやライブ配信、装着型カメラのように映像が流れ続ける状況では、事情が変わります。
流れてくる映像を扱うモデルは、どの情報が後で必要になるかわからないまま、証拠を保持し続けなければなりません。全フレームを文脈に積み上げれば過去は参照できますが、トークン数とメモリが膨らみ、1秒ごとに応答するリアルタイム性が崩れます。逆に直近の数十フレームだけを見る方式では、少し前に起きた出来事を問われた時点で答えられなくなります。
さらに、ストリーミング特有の難しさとして「いつ話すか」の判断があります。質問を先に受け取り、十分な証拠が集まった瞬間に初めて答えるという振る舞いは、従来の学習枠組みでは扱いにくい部分でした。南京大学などの研究チームが発表した OneStreamer は、知覚・記憶・能動応答という3つの要素を1つのモデルに統合する試みです。
3種類の問答設定
論文はストリーミング動画理解を3つの問答設定に整理しています。現在見えているものに答える Perception QA、記憶に残した過去の証拠から答える Memory QA、そして質問を先に受けて適切な時点で答える Proactive QA です。
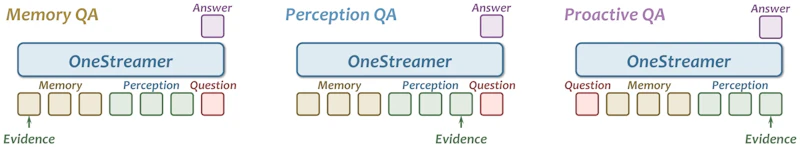
図2のように、この3つは必要な証拠の在りかも応答のタイミングも違います。これまでは別々の課題として扱われがちでしたが、OneStreamer はいずれも「次に何を出力するかを能動的に決める」という共通の形式に落とし込みました。
提案手法
基盤モデルには Qwen3-VL の4Bモデルを使い、2つの仕組みを追加しています。1つ目が Proactive Hierarchical Caption Memory(PHCM) です。映像を見ながら、細部を記述する時刻付きキャプションを </Observe>、区切りのついた出来事の意味的な要約を </Summary> として、モデル自身が先回りして生成します。
推論時はこの2階層のテキスト記録を、直近16フレーム(1fps)の視覚トークンと組み合わせて文脈に置きます。過去の映像そのものを持ち続ける必要がなくなるため、360秒の入力で文脈トークンを93.1%、GPUメモリを60.4%削減しながら、過去についての質問に答えられるようになりました。更新あたりの遅延増加は平均0.164秒にとどまり、毎秒1回の更新を維持できています。
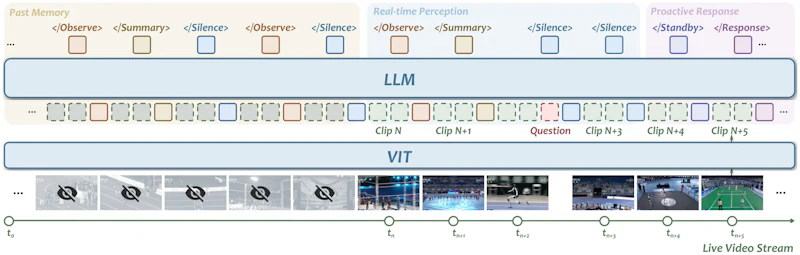
2つ目が Proactive State Transition Learning(PSTL) です。能動応答では、十分な証拠がない間は </Silence>(観察を続ける)、手がかりが出始めたが不足している段階では </Standby>、答えられる段階で </Response> を出します。
素直に学習させると、圧倒的に数の多い </Silence> が教師信号を占めてしまいます。PSTL は全ての出力位置で監督を保ちながら、状態が切り替わる代表的なトークンと継続を示すトークンを選んで学習させる方式です。図3に示した制御トークンの設計と合わせて、沈黙と応答の切り替えを学習対象として明示した点が特徴といえます。
データセットの構築
学習には新たに作った OneStreamer-1M を使います。100万件を超える記録が、出力内容と出力時刻の両方を利用可能な証拠に合わせる形で合成されています。内訳は次の4系統です。
- Proactive Caption Memory、6万件(階層的・平坦なキャプション)
- Proactive Interaction、27万1570件(継続的な実況、警告、計数など)
- Proactive QA、19万7584件
- Perception & Memory QA、63万850件
構築は6段階で、動画の選別、多粒度の注釈付け、検証、証拠の時刻特定、応答時刻の校正、系列形式への変換という流れです。クローズドソースのモデルに時刻付きの注釈を作らせ、検証を通したうえで学習系列に変換しています。応答すべき時刻を証拠の出現時刻から逆算して校正している点が、能動応答の学習を成立させる鍵になっています。
実験結果
評価は8つのストリーミング動画理解ベンチマークで行われ、4Bという比較的小さなモデルで全てにおいて最高性能を記録しました。Qwen3-VL ベースラインに対する平均の相対改善は25.0%、各ベンチマークで最も強い既存手法に対しても平均6.1%上回っています。
ベンチマーク | OneStreamer | Qwen3-VL比 |
|---|---|---|
OVOBench | 72.1 | +13.3 |
StreamingBench(Real-Time) | 86.9 | +5.1 |
OVBench | 66.8 | +11.4 |
ODVBench | 71.3 | +13.7 |
ProactiveVQA | 48.7 | +14.4 |
OmniMMI | 36.6 | +7.2 |
OVO-Timing | 41.6 | +12.2 |
ViSpeak | 2.87 | (別尺度) |
切り分け実験も結果を裏付けています。生成したキャプション記憶を加えると OVOBench の過去参照課題(Backward)が63.5から71.6へ上がり、リアルタイム知覚の精度は落ちませんでした。直近16フレームと記憶の組み合わせは、全履歴保持や直近窓のみの方式を両方の指標で上回っており、単なるトレードオフの調整ではないと論文は述べています。
PSTL についても、状態トークンの27.5%だけを監督する設定が、密な監督や無作為な間引きより良い結果を示しました。ProactiveVQA では focal loss を用いた場合の47.0に対し48.7でした。音声を1秒前後の遅延で文字化するMicrosoftのストリーミング文字起こしと同様、映像側でも「流れ続ける入力に即時に応じる」設計が実用の条件になりつつあります。
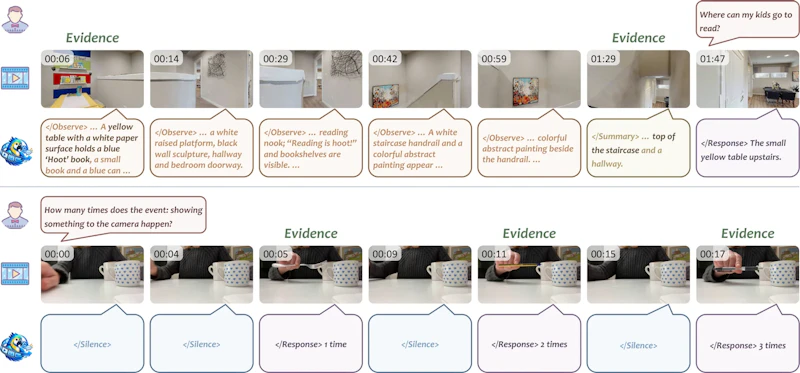
図6は定性的な挙動を示したものです。直近の視覚窓の外にある出来事をキャプション記憶が保っており、証拠が不足している間は出力を控え、条件が満たされた時点で応答しています。
まとめと今後の展望
OneStreamer は、過去の映像を文字記録に置き換えて保持するという素直な発想を、能動的な生成という1つの学習インタフェースにまとめた研究です。視覚履歴を捨てる代わりにモデル自身の記述を信じる設計なので、記述の質がそのまま記憶の質になります。
論文の付録でも課題が挙げられており、変化の速い場面では生成キャプションが細かな状態遷移を取りこぼすこと、動画をまたぐ時間推論が苦手なこと、能動応答の初期段階で根拠のない内容を出してしまう場合があることが報告されています。図12の失敗例では、プリンタが閉じられていないのに閉じたと報告する誤りが示されています。
とはいえ、知覚・記憶・応答タイミングを一体で扱う枠組みは、ロボットや画面操作エージェントなど、入力が止まらない用途にも素直に移せる構造をしています。4Bで到達した性能という点も、端末側での実行を考えるうえで意味を持つでしょう。
論文情報: "OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction"(Xiangyu Zeng et al., 2026) arXiv:2610.01762, CC BY 4.0
本記事の図(図2、図3、図6)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


