 AI-Papers
- 実在するAIコンパニオンとの10件の関係、最長120日・27,218メッセージを収めた実データベンチマークRealCompanionが公開されました
- 記憶参照が本当に必要な発言は全体の3.4%にとどまり、必要な場合は中央値で2,157メッセージも前まで遡る必要があります
- ペルソナ再構成では3つのエージェント構成がF1 0.69〜0.70で並び、処理トークン量には約31倍の開きがありました
記憶ベンチマークの弱点
数か月にわたって人と話し続けるAIコンパニオンには、過去の発言を覚え、相手がどんな人物かを推し量り、いま目の前のメッセージに過去が関係するかどうかを判断する力が求められます。この能力を測ろうとすると、本物の人間の長期的な会話記録が必要になります。ところがそうした記録は極めてプライベートなもので、公開されることはほとんどありません。
そのため既存のベンチマークは、架空の人物と架空の質問を生成し、「何が重要か」をあらかじめ設計者が決めてしまう形で作られてきました。RealCompanionの著者であるArman Behnam氏らは、この作り方そのものが長期記憶の難しさを歪めて見せていると指摘します。人工的に作られた質問は、どの発言が記憶参照を要するかという手がかりを質問文自体に漏らしてしまうという問題があるためです。
120日分の実ログを公開
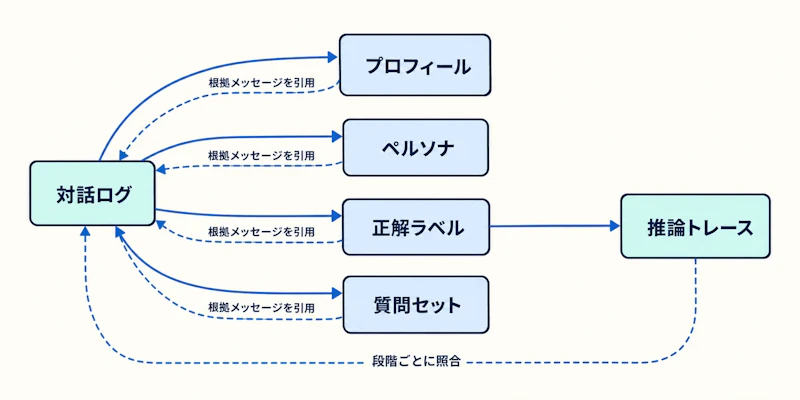
RealCompanionは、あるAIコンパニオンアプリの運用データから、最初のメッセージから最後のメッセージまでを丸ごと記録した10件の関係を収録しています。総量は27,218メッセージ、期間は最長120日です。会話ログそのものに加えて、そこから導出された4つのファイルが付属します。
プロフィール、ペルソナ、対話に対する正解ラベル、そして質問セットの4つで、いずれも根拠となったメッセージを引用する形で紐づけられています。さらに対話ラベルには、その判断に至った推論トレースが付けられ、会話履歴と段階ごとに照合されています。図1に示すように、すべての派生情報が元ログに遡って検証できる構造になっているため、評価の妥当性を後から監査できます。
記憶は滅多に必要ない
第1の発見は、過去の参照が「めったに必要ではないが、必要なときは遠い」という非対称性です。参加者が送ったメッセージのうち、記録に基づいて確かに記憶参照を要すると検証できたものは3.4%(信頼区間2.5〜4.6%)にすぎませんでした。一方で、記憶が必要なプローブ(評価用に抜き出した発言)が参照すべき最も遠いメッセージは、中央値で2,157メッセージ前に位置していました。
ここで注意が必要なのは、集計の仕方によって結論が逆転する点です。直近の数件だけを見る方式は、プローブ全体では95.9%で必要なメッセージを拾えます。ところが本当に記憶を必要とするプローブに絞ると、的中率はわずか2.2%まで落ちます。全体をまとめた数字が高く出るのは、大多数のメッセージがそもそも過去を必要としないからです。
同じ構図は、検索で証拠を補う効果にも現れます。自然な発生率のもとでは、記録済みの証拠を与えたことによる改善の96%が、実は記憶を必要としないメッセージから生じていました。記憶モジュールの有効性を全体平均で評価すると、肝心の難しいケースでの性能が見えなくなるわけです。
検出器は実発言で機能せず
第2の発見は、「いつ記憶を参照すべきか」を判定する仕組みの難しさです。著者らが試した検出器はいずれも、実際のメッセージに対して信頼できる判定ができませんでした。プローブとその直前3メッセージを読む検出器のAUROC(判別性能の指標で0.5が偶然並み)は0.530、キーワードによるスコアリングでも0.696どまりでした。
対照的に、同じ会話履歴に対して人手で作成した質問では判定が容易になります。質問文の作り方そのものが答えの手がかりを漏らしているためです。さらに、同じメッセージを「記憶である」とラベル付けして提示すると、モデルがそれを利用する割合が10〜14ポイント上昇しました。評価設計のわずかな違いが結果を大きく動かすことを示す結果です。
コスト31倍差でも同じF1
第3の発見は、エージェント構成の違いが精度に結びつかないことです。会話からユーザーのペルソナを再構成させる課題で、3つの構成はほぼ同じF1値を記録しました。
構成 | F1 | 処理トークン |
|---|---|---|
Claude Opus 5.5 | 0.686 | 546M |
Codex GPT-5.6-sol | 0.688 | 18M |
Antigravity Gemini 3.8 Flash | 0.701 | 36M |
F1は0.69前後に揃っている一方、処理したトークン量は約31倍の開きがあります。大量の履歴を読み込ませる構成が、必ずしも人物理解の精度を押し上げるわけではないという示唆であり、記憶設計のコスト最適化を考える際の実務的な指標になります。長期の文脈をどう圧縮して持つかという課題は、OneStreamerのようなストリーミング動画対話の研究とも共通する論点です。
限界と今後の展望
一方で、このベンチマークには明確な制約があります。収録されているのは10件の関係だけで、しかも単一のアプリケーションに由来します。コンパニオン用途特有の会話傾向が強く出ている可能性があり、業務アシスタントや検索エージェントにそのまま一般化できるとは限りません。
記憶必要性の判定も「記録された内容に基づく読み」という一つの基準に依存しており、別の基準を採れば3.4%という数字は動きうるでしょう。それでも、合成データでは見えなかった実世界の分布を提示し、プール集計の落とし穴と評価設計のリーク(手がかりの漏れ)を具体的に示した点に意味があります。長期記憶モジュールを積み増す前に、どの程度の割合でそれが本当に使われるのかを測り直す必要があると言えます。
論文情報: "RealCompanion: Benchmarking Human Understanding from Reasoning over Longitudinal Real-World Conversations"(Arman Behnam, Sunglyoung Kim, Liangwei Yang, 2026) arXiv:2610.01780


