 AI-Papers
- テキストや画像から5秒の映像と44kHzの同期音声を同時生成する拡散基盤モデル Kandinsky 6.0 Video が公開されました
- 事前学習済みの映像ストリームと新規の音声ストリームを双方向クロスアテンションで結ぶデュアルストリーム CrossDiT 構造を採用しています
- 強化学習による事後学習で Pro 版の単語誤り率が0.235から0.124へ下がり、約47%の相対削減を達成しました
研究の背景
テキストから動画を作る生成モデルはこの数年で急速に品質を上げてきましたが、出力は無音の映像にとどまるものが主流でした。音を付けるには、生成した映像に対して別の音声生成モデルを後段でつなぐ構成が一般的です。
この分離型の構成には弱点があります。足音や打撃音のタイミングが映像の動きとわずかにずれる、人物の口の動きとセリフが合わないといった問題が残りやすく、特にリップシンク(口の動きと発話音声の一致)は後処理では扱いにくい課題でした。
Kandinsky 6.0 Video は、映像と音声を1つの拡散モデルの中で同時に生成することでこの問題に取り組んでいます。パラメータ数3B(30億)の Lite 版と29B(290億)の Pro 版が用意され、重み・コード・diffusers 統合が MIT ライセンスで公開されている点も、研究再現の観点で扱いやすい構成です。
デュアルストリーム構造
モデルの中核は、映像用と音声用の2本の Transformer ストリームを並走させる CrossDiT と呼ばれる構造です。各ストリームは自己アテンション、テキスト埋め込みへのクロスアテンション、フィードフォワード層という標準的な構成に加えて、もう一方のモダリティを参照するクロスモーダルアテンション層を持ちます。
図1に示すように、V2A ブロックでは映像側のクエリが音声側のキーと値を参照し、A2V ブロックでは音声側のクエリが映像側を参照します。この双方向の参照によって、時間的な同期と意味的な対応づけが学習の中で自然に成立する設計です。
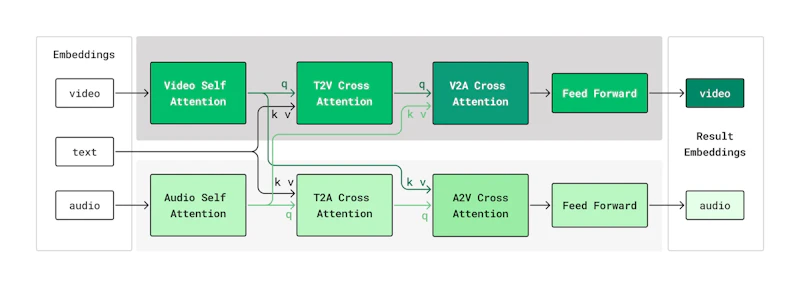
位置埋め込みの扱いも2つのストリームで分けられています。映像トークンは縦・横・時間の3次元 RoPE(回転位置埋め込み)を使い、音声トークンは時間方向のみの1次元 RoPE を使います。テキスト条件づけも T2V 用と T2A 用で別のブロックを持ち、タイムステップ埋め込みが各サブ層をスケール・シフト・ゲートで変調します。
生成されるのは512×768などの SD 解像度で121フレーム、約5秒のクリップです。Full HD が必要な場合は、専用の潜在アップスケーラと SR-DiT による超解像を経て1920×1080に引き上げられます。公開されている主な内容は次のとおりです。
- Lite(3B)と Pro(29B)の学習済み重み
- T2AV(テキストから映像と音声)と I2AV(画像から映像と音声)の両モード
- 超解像モデルと音声 VAE を含む推論パイプライン
- diffusers への統合と MIT ライセンスでのコード公開
学習パイプライン
学習は段階を踏んで進みます。映像ストリームは前世代の Kandinsky 5.0 Video から初期化し、音声ストリームは大規模な音声コーパスで単独に事前学習します。その後に両者を融合し、T2AV モードと T2AV/I2AV 混合モードで共同事前学習を行う流れです。
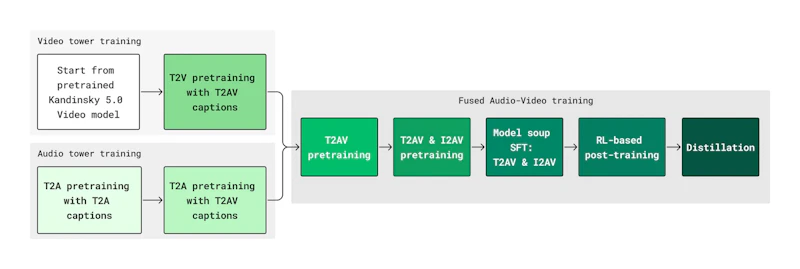
図5の後半にあたる事後学習では、モデルスープ(複数の学習済み重みの平均)を伴う教師ありファインチューニングのあとに、強化学習が入ります。報酬は8項目に分かれ、スコアはグループ内で中心化してからバッチ全体の標準偏差で正規化され、映像用と音声用のアドバンテージに振り分けられます。同期に関わる項目だけは両方に流す設計です。
報酬をトークン単位に落とし込む際には、A2V クロスアテンションから得た重みを使って映像内の領域ごとに配分します。音声と動画を同時に扱う拡散モデルで報酬の設計と配分を工夫する方向は、Adaptive Reward Routingでも議論されており、複数モダリティを1つのモデルで最適化する際の共通した論点になっています。
最後の蒸留では π-Flow で生成軌跡を圧縮し、Sim-LADD と呼ぶ敵対的学習で仕上げます。学生モデルは10回のネットワーク評価で動き、超解像側はさらに2回の評価まで削られます。
実験結果
評価には VABench が使われ、音声品質・映像品質・同期の各側面が測られています。主要な数値は次のとおりです。単語誤り率と非同期度(Desync)は小さいほど良く、それ以外は大きいほど良い指標です。
指標 | LTX 2.5 | K6.0 Lite | K6.0 Pro |
|---|---|---|---|
音声品質 | 1.427 | 1.477 | 1.496 |
音響的な美しさ | 3.307 | 3.323 | 3.345 |
テキスト・映像整合 | 0.185 | 0.227 | 0.229 |
音声・映像整合 | 0.258 | 0.245 | 0.268 |
リップシンク | 1.567 | 1.761 | 2.072 |
非同期度 | 0.521 | 0.474 | 0.396 |
単語誤り率 | 0.099 | 0.103 | 0.117 |
Pro 版はリップシンクで2.072、非同期度で0.396と、比較対象の LTX 2.5 を上回りました。一方で単語誤り率は0.117で、LTX 2.5 の0.099には届いていません。発話内容の明瞭さにはまだ改善の余地があるといえます。
強化学習の効果は発話品質にはっきり表れており、Pro 版の単語誤り率は事後学習前の0.235から0.124へ、約47%の相対削減(p<0.001)となりました。Lite 版でも0.179から0.127へと約29%の削減です。蒸留版と完全版の人手による比較では、画像起点の生成で51%対49%と差が統計的に有意ではなく、推論コストを大きく下げても品質がほぼ保たれたと報告されています。
ただし商用モデルとの比較は一様ではありません。前世代の Kandinsky 5.0 Pro には明確に勝っている一方、Kling 2.6 や Veo 3.1 Fast、Seedance 2.0 との比較では映像の美しさやプロンプト追従で相手が優位となる項目が残り、MiniMax H3 については「この評価では相手の方が強い」と論文自身が認めています。Pro 版が競争力を保っているのは、主に同期性と発話品質の領域です。
まとめと今後の展望
Kandinsky 6.0 Video は、映像と音声を別々のモデルでつなぐのではなく、1つの拡散 Transformer の内部で双方向に参照させるという設計を、基盤モデル規模で実証した研究です。強化学習と蒸留まで含めた構築レシピが具体的に記述されており、実装側にとっての参考価値も高いといえます。
制約は論文自身が整理しています。クリップは最大5秒、生成は SD 解像度で行い Full HD は超解像に依存する構成で、映像品質と総合的な音質では強力なプロプライエタリ製品との差が残ります。今後の方向として、より長いクリップ、ネイティブな高解像度生成、参照画像を使った条件づけが挙げられました。
3B の Lite 版が MIT ライセンスで利用できる点は、音声と映像の同時生成を自分の環境で検証したい開発者にとって現実的な入口になります。商用モデルに正面から並ぶ段階ではないものの、音と映像の同期という軸では公開モデルの到達点を押し上げた成果です。
論文情報: "Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation"(Team Kandinsky et al., 2026) arXiv:2610.05608, CC BY 4.0
本記事の図(図1、図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


