 AI-Papers
- Reflection AIが総パラメータ501B、アクティブ23BのMoE構成のオープンウェイトLLM「Beam」を公開
- 学習データは23.8兆トークン、文脈長は100万トークン。GLM-5.2と同等の推論性能を推論計算量3〜4分の1で達成と主張
- 重みは2026年10月中にハイパースケーラーやneocloud、OSSライブラリ経由で配布。企業・主権国家向け「AI factories」戦略の中核に位置づけ
Beamの概要
米Reflection AIは2026年10月、テキスト専用のオープンウェイト大規模言語モデル(Large Language Model、LLM)「Beam」を公開しました。重みと技術詳細を10月中に公開し、ハイパースケーラー、neocloud(GPU特化型のクラウド事業者)、オープンソースライブラリを通じて配布するとしています。
構成はMixture-of-Experts(MoE、入力ごとに一部の専門家ネットワークだけを使う方式)で、総パラメータ501Bに対して推論時に動くアクティブパラメータは23Bにとどまります。学習は23.8兆トークンで、仕上げに大規模な計算資源を投じた強化学習を適用したと説明されています。
項目 | Beamの仕様 |
|---|---|
総パラメータ | 501B |
アクティブパラメータ | 23B |
学習トークン数 | 23.8兆 |
文脈長 | 100万トークン |
モダリティ | テキストのみ |
推論コストという訴求点
同社の主張で中心にあるのは性能の絶対値ではなく、性能あたりの計算量です。高度な推論ベンチマークでZ.aiのGLM-5.2に匹敵しながら、競合より推論計算量が3〜4分の1で済むとしています。コーディング評価では、Thinking Machines Labが2026年7月に公開したマルチモーダルモデルInklingを上回ったとも述べています。
総パラメータの5%未満しか活性化しないMoE設計は、この主張と整合します。モデルを自前のインフラでホストする開発企業にとって、同等品質で推論コストが数分の1になれば、GPU調達量や同時処理数の設計が変わります。ただしTechCrunchは、これらの性能主張が第三者によって検証されていない点を明記しています。同社は取材に期限内の回答をしていません。
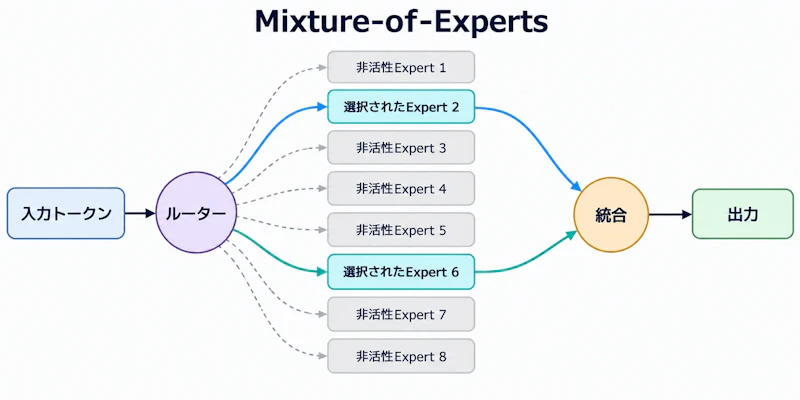
図1のように、MoEでは入力ごとにルーターが使用する専門家を選び、残りは計算されません。総パラメータが大きくても推論時の演算量を抑えられる仕組みで、Beamの501Bと23Bという数字の差はここから生まれます。
西側オープンモデルの構図
Beamが比較対象に挙げるのは、DeepSeek、Qwen、Z.aiといった中国勢のオープンモデルです。推論性能の高いオープンウェイトモデルが中国発に集まる状況に対し、Reflection AIは米国側の選択肢を提示する立ち位置を取ります。同社は、Mistral、Meta、Cohereといった現行の西側オープンモデルを上回るとしています。
オープンウェイトでの公開自体は広がりつつあり、研究用途ではAi2が引用付きレポート生成モデルAstaBriefを公開するなど、分野ごとに重み公開の事例が増えています。Beamはそこに汎用の大規模推論モデルとして加わる形です。
AI factories戦略と資金背景
Reflection AIは2024年にGoogle DeepMindの研究者2人が設立した企業で、累計調達額は約47億ドル、直近の評価額はプレマネーで250億ドルとされています。出資にはNvidia、Sequoia Capital、Lightspeed Venture Partnersが名を連ねます。
計算資源の確保も進めており、2026年6月に締結したSpaceXとの契約とNebiusとの合意を合わせて70億ドル超、NvidiaのGB300へのアクセスを2029年まで確保する内容です。事業面では、企業や主権国家の自社データでモデルを調整して現地運用する「AI factories」を掲げ、韓国のShinsegae Groupとは主権AI factoryで提携しています。ヘッジファンドやトレーディング企業からの関心も強いと報じられています。
重みを公開するモデルと、閉じたデータで個別構築する受託型の事業を組み合わせる構えです。公開された重みの実測値が主張に見合うかは、配布後の第三者評価を待つ段階にあります。


