 AI-Papers
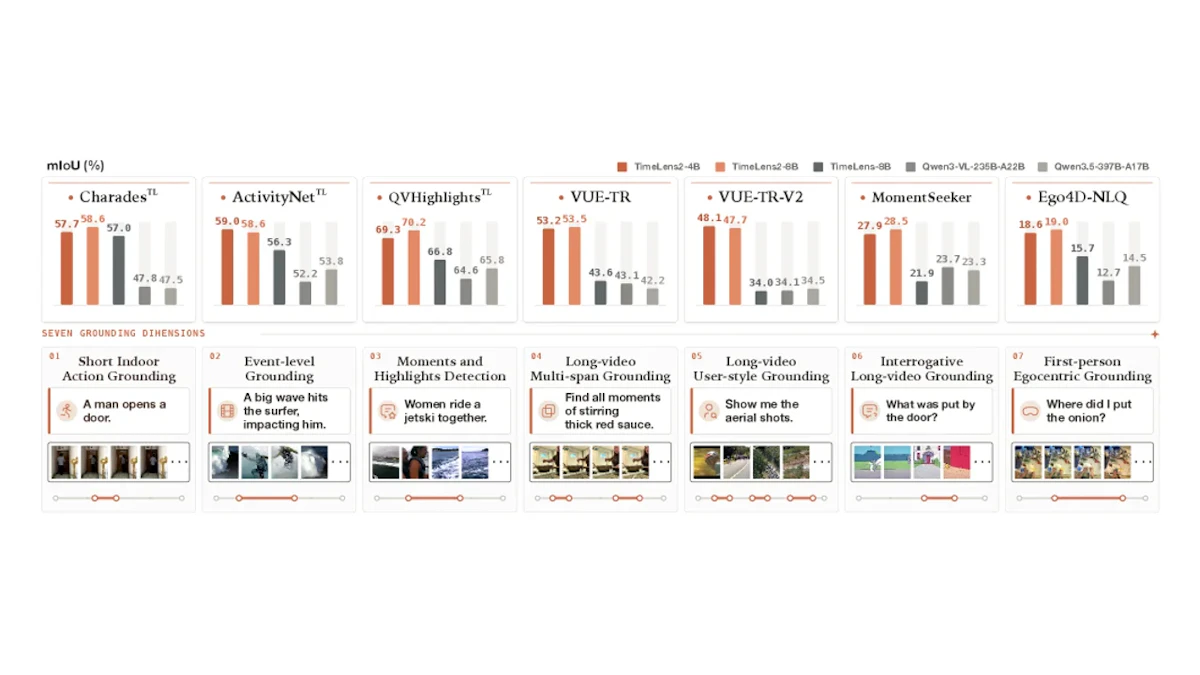
- 8Bパラメータのモデルが最大397Bの大規模モデルを7つのベンチマーク全てで上回る性能を達成
- 最適輸送理論に基づく「時間的Wasserstein報酬」を新たに考案し、従来手法の報酬計算の欠陥を解消
- 93,000件の高品質な多区間アノテーションデータセット「TimeLens2-93K」を構築・公開予定
研究の背景
動画AIの分野では、「映像の中で何が起きているか」を説明するマルチモーダルLLM(Large Language Model)の性能が急速に向上しています。しかし「それがいつ起きているか」という時間的な位置の特定、いわゆるビデオ時間グラウンディング(映像内の特定区間を特定するタスク)では、既存モデルはまだ大きな課題を抱えていました。
特に難しいのは、一つの質問に対して複数の時間区間が答えになりうるケースです。たとえば「動画中で車が映っている場面をすべて教えて」という問いに対して、モデルは一か所だけでなく、散在する複数の区間をまとめて出力しなければなりません。従来の手法はこのような「集合的な時間推定」に対応できていませんでした。
本論文「TimeLens2」では、このギャップを埋めるための新しいフレームワークを提案しています。マルチモーダルLLMを汎用的な時間グラウンディングエンジンとして機能させることを目指した研究です。
TimeLens2の3つの柱
TimeLens2の中核は、データセット・報酬設計・学習戦略という3つの要素の組み合わせにあります。
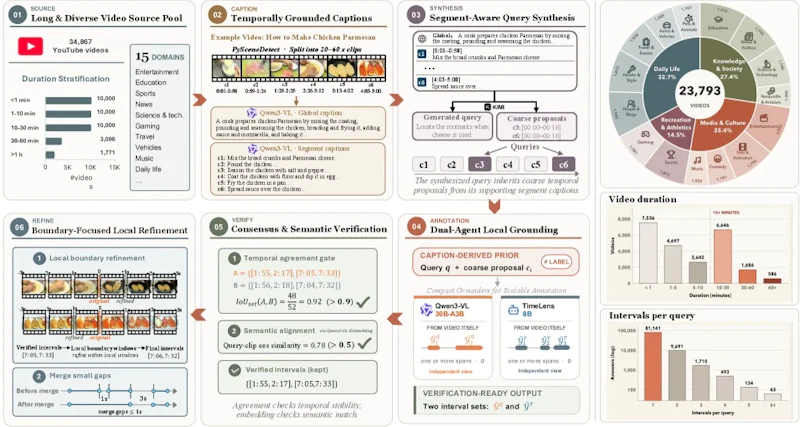
1. TimeLens2-93Kデータセットの構築は、研究の土台となります。93,000件の高品質な多区間アノテーションを含むこのデータセットは、単純にラベルを付けるだけでなく、複数の独立したエージェントが提案した区間を相互に検証・精緻化するパイプラインで作成されました。キャプションから自動生成したクエリに対して、区間の粗い提案から始まり、意味的整合性の確認と境界の微調整を経て、信頼性の高い教師データを生成します。
2. 時間的Wasserstein報酬(Temporal Wasserstein Reward)は、本論文最大の理論的貢献です。強化学習(RL)でモデルを訓練する際、予測した区間と正解区間をどう比較するかが報酬設計の核心になります。従来広く使われていた「tIoU」(区間の重複割合)には、重大な欠陥がありました。
正解区間とまったく重ならない予測は、近い位置であっても遠い位置であっても同じゼロ点になってしまうため、「惜しい予測」と「大外れの予測」を区別できなかったのです。
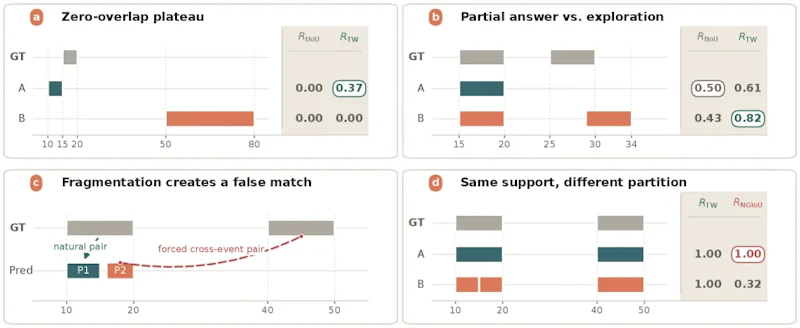
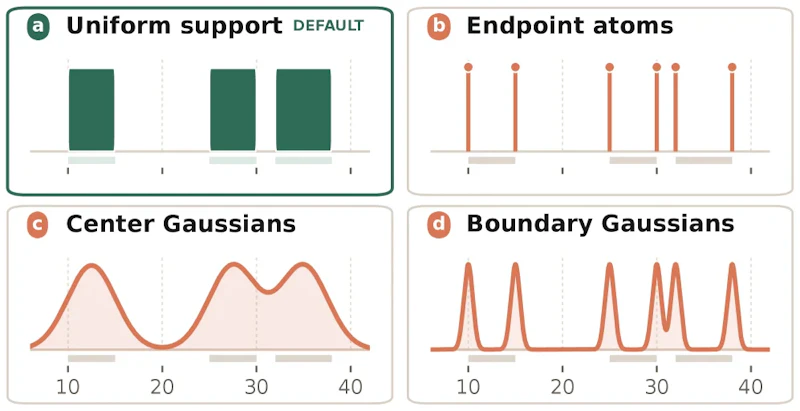
そこでTimeLens2では、最適輸送理論(Optimal Transport)を応用した報酬を導入しました。これは、予測区間と正解区間をそれぞれ確率分布として捉え、両者の分布を「動かすコスト」(Wasserstein距離)を報酬として計算するアイデアです。この方法ではマッチング(予測と正解を対応付ける処理)が不要となり、予測の数が変動しても安定した勾配を提供できます。
3. 集合値出力への対応として、モデルは任意の数の時間区間を一度に出力するよう訓練されます。「区間が0個の場合(該当なし)」から「多数の区間がある場合」まで柔軟に対応できる点が、単一区間しか出力できなかった従来モデルとの大きな違いです。
実験結果
TimeLens2は、7つの異なるベンチマーク(多様なクエリ形式・ドメイン・評価指標をカバー)で総合評価されました。結果は顕著で、Qwen3-VLをバックボーンとした2B、4B、8Bの各モデルが、ベースラインと比べてmIoU(平均Intersection over Union)を次の表のように改善しています。
モデルサイズ | ベースラインからの改善(mIoUポイント) |
|---|---|
2B | +14.2 |
4B | +13.0 |
8B | +18.1 |
モデルを大きくするほど改善幅が単調に伸びるわけではなく、最大の伸びは8Bで得られました。
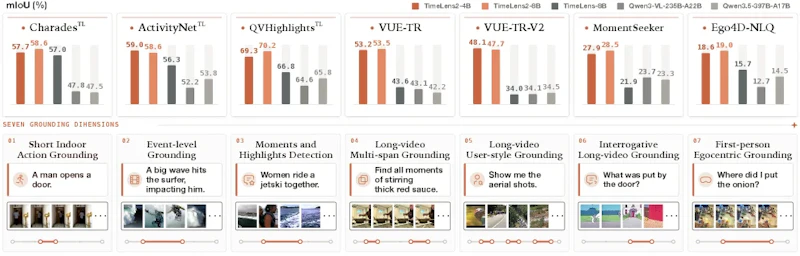
8Bという比較的コンパクトなサイズのモデルが、最大397Bパラメータを持つ大規模モデルを全ベンチマークで上回りました。パラメータ数の増加だけでは解決できない問題を、適切なデータと報酬設計によって解決できることを示す結果です。
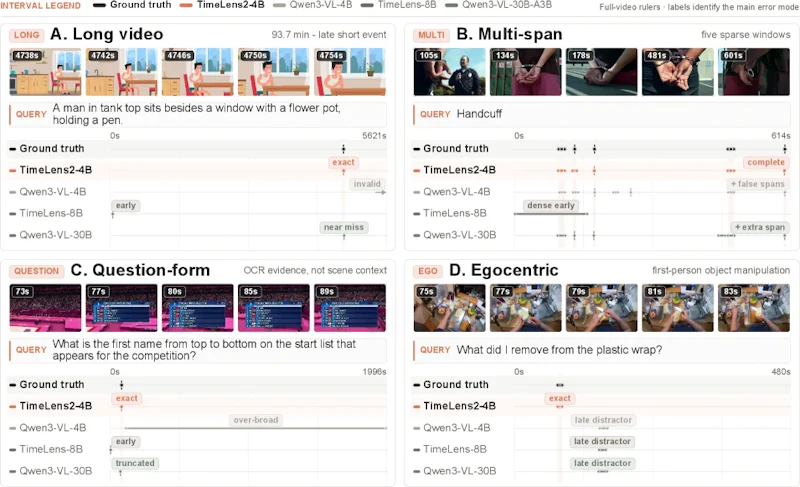
質的な比較でも、TimeLens2は複数の目標区間を正確に特定する能力が高く、既存の手法が見落としがちな短い区間や密集した区間を適切に扱えることが確認されています。一方、非常に短いクリップや高度に専門的なドメインでは精度低下が見られる場合もあり、今後の課題として挙げられています。
マルチモーダルLLMへの示唆
本研究は、動画理解AIの応用可能性を広げるものです。想定される実用ユースケースには、次のようなものがあります。
- 動画検索: 特定シーンの瞬時発見
- 動画要約: 重要区間の自動抽出
- 監視・セキュリティ: 異常行動の時間帯特定
- スポーツ解析: ハイライト区間の検出
いずれも、映像内のどこを見ればよいかを時間軸上で絞り込む作業が中心になる領域です。
また、SenseNova-Visionのような単一モデルで複数のビジョンタスクを解く研究と同様に、TimeLens2も汎用的なマルチモーダルLLMの枠組みの中で時間的推論を統合する方向性を示しており、「何を」「いつ」の両軸を単一モデルで扱う次世代アーキテクチャへの道を切り拓いています。
データセットとコードは論文公開に合わせて公開予定とされており、再現性の高さも研究コミュニティにとって大きな価値になるでしょう。
まとめ
TimeLens2は、ビデオ時間グラウンディングを「集合値予測問題」として再定義し、最適輸送理論に基づく新しい報酬関数と高品質なデータセットを組み合わせました。その結果、8Bモデルが397Bモデルを超える成果を出しています。
パラメータ規模ではなく、データの質と報酬設計の巧みさがモデル性能を左右することを示した好例といえます。動画AIが「何を見ているか」を理解するだけでなく「それがいつか」まで正確に把握できるよう進化していく流れの中で、本研究は重要な一歩を踏み出しました。
論文情報: "TimeLens2: Generalist Video Temporal Grounding with Multimodal LLMs"(Yuhan Zhu et al., 2026) arXiv:2607.17423, CC BY 4.0
本記事の図(図1〜図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


