 AI-Papers
- UAEのTechnology Innovation Institute(TII)が、エミラティ方言に特化した70億パラメータのチャットモデルFalcon-Emirati-7Bを公開した
- 方言ベンチマークAlyahで84.83%、UAE文化理解で85.57%を記録し、2倍以上の規模を持つ多言語モデルを上回った
- 方言忠実度は0.52で、競合モデルの0.05以下と大きく差が付き、方言能力は規模の副産物では得られないと結論づけている
方言に特化した7Bモデル
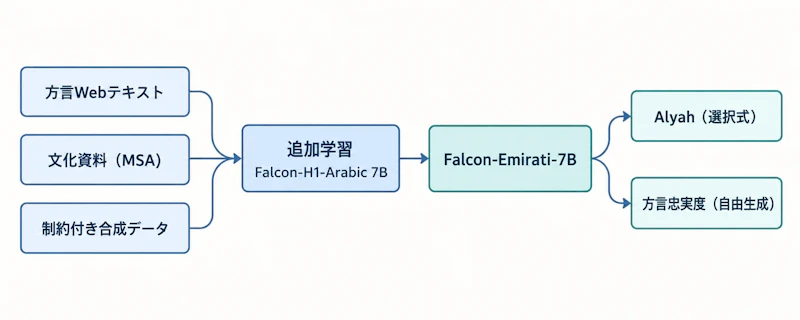
アラブ首長国連邦(UAE)の研究機関Technology Innovation Institute(TII)は2026年10月6日、エミラティ方言に特化した対話モデルFalcon-Emirati-7Bを公開しました。パラメータ数は70億で、同機関のアラビア語モデルFalcon-H1-Arabicの7B版を基盤に追加学習したものです。
アラビア語の大規模言語モデル(Large Language Model、LLM)は数多く存在しますが、その多くは書き言葉である現代標準アラビア語(Modern Standard Arabic、MSA)を中心に学習されています。話し言葉としての湾岸方言、とりわけエミラティ方言で自然に応答できるモデルは限られていました。
TIIが7Bという規模を選んだ理由は、方言適応に必要なニュアンスを保持できる程度に大きく、学習と推論の両方が現実的なコストに収まる程度に小さい、という折り合いの良さにあると説明されています。
Mamba併用の基盤構成
基盤となるFalcon-H1-Arabicは、状態空間モデル(State Space Model)のMambaとTransformerのアテンション機構を各ブロック内で並列に走らせるハイブリッド構成を採用しています。長い系列を効率的に扱えるMambaと、文脈内の任意の位置を参照できるアテンションを組み合わせた設計で、コンテキスト長は最大128Kトークンに対応します。
この基盤に対して、方言データでの継続学習を行ったのがFalcon-Emirati-7Bです。TIIは、方言データをどれだけ投入するか、学習のどの段階で投入するかについてアブレーション実験(構成要素を変えて効果を切り分ける検証)を重ねたとしています。
3系統の学習データ
学習データは性質の異なる3系統を組み合わせています。単純に方言テキストを集めるだけでは量が足りず、合成データだけでは話し方の自然さが失われるため、相互に補う構成が取られました。
- Webサイトやフォーラムから収集した、話者自身が書いた実際のエミラティ方言テキスト
- UAEの伝統、慣習、社会規範を扱うMSAの文化資料
- エミラティ語彙と文法のために作成した辞書と用語集で制約をかけた合成データ
3番目の合成データは、生成を自由に行わせるのではなく、方言固有の語彙や語形の規則に沿うよう束縛している点が特徴です。方言は正書法が揺れやすく、制約なしの生成ではMSA寄りの表現に引き戻されやすいという事情があります。
Alyahで84.83%
評価には、ネイティブ話者から手作業で収集した1,173件の選択式問題から成るベンチマークAlyahが使われました。日常の挨拶や礼儀作法から、比喩的な表現、伝統文化の知識、エミラティの詩までを範囲に含みます。Falcon-Emirati-7Bは84.83%を記録し、比較対象としたアラビア語モデルおよび多言語モデルのすべてを上回りました。
UAEの文化理解を測るArabCulture-Dialogueでは85.57%で、ALLaM-7B、Jais-2-8B、Fanar-2-27Bを上回っています。27Bクラスのモデルを7Bが上回った点が、規模と方言能力が直結しないことを示す結果になりました。
モデル | ArabCulture-Dialogue |
|---|---|
Falcon-Emirati-7B | 85.57% |
ALLaM-7B-Instruct-preview | 83.39% |
Jais-2-8B-Chat | 73.79% |
Fanar-2-27B-Instruct | 71.50% |
自由生成での評価では、Gemini 3.7 FlashをLLM審査員として用い、内容の正しさと「実際にエミラティ方言で答えているか、MSAに逃げていないか」を独立した2軸で採点しました。方言忠実度はFalcon-Emirati-7Bが0.52、競合は0.05以下にとどまっています。採点を別モデルに委ねる手法の長所と落とし穴についてはLLM評価の方法とは?ベンチマークとLLM-as-a-Judge、バイアス対策を解説でも整理しています。
モデル同士を1対1で比較した評価では、詩と創作表現、言語と方言、宗教的および社会的な配慮の各カテゴリで優位が大きく出たとされています。
規模では買えない能力
TIIはこの結果を「規模だけでは方言能力は買えない」とまとめ、エミラティ方言の運用能力は意図して訓練する対象であり、規模拡大の副作用として自然に身につくものではないと述べています。選択式のAlyahで既存モデルがある程度の点を取れても、自由生成では方言を保てずMSAに戻ってしまうという落差が、その主張を裏づける形になりました。
この知見は、特定の言語変種や業務ドメインに向けたモデルを検討する立場にも当てはまります。評価を選択式の正答率だけで行うと、出力の文体や言語変種が崩れている問題を見落とす可能性があるため、自由生成での忠実度を別軸で測る設計が有効だと読み取れます。
制約と提供形態
TIIは制約も明示しています。学習データに含まれるバイアスを反映する場合があり、まれな表現や土地に強く結びついた固有の参照では誤ることがあるとして、機密性の高い用途や公的な場面、影響の大きい意思決定での利用にあたっては個別の検証を推奨しています。
モデルはFalcon Chat上で試用でき、コミュニティからのフィードバックを改善に取り込む方針が示されています。公開記事の時点でライセンス条件についての記述はなく、利用条件は提供ページ側の表記を確認する必要があります。


