 AI-Papers
- OpenAIが生成テキストに不可視の透かしを埋め込む「textGrain」を導入し、EU AI Actの機械可読な識別義務に対応します
- APIは全世界で対象モデルに任意適用、ChatGPTとCodexはEU内の対象ユーザーに数週間かけて順次導入されます
- 検出器は研究者と専門機関に限定公開。400トークンで約95%検出だが、同義語で25%置換すると17%まで低下します
EU規則に応える透かし
OpenAIは、生成したテキストに人間には読み取れない透かしを埋め込む技術「textGrain」の導入を公開しました。EU AI Actは生成AIの提供者に対し、生成されたテキストを機械可読な形で識別できるようにすることを求めており、今回の措置はその透明性義務への対応です。
適用の経路は2つに分かれます。発表当日から、APIの利用者は世界中どこからでも、対象モデルについて透かし入りの出力を任意で選べるようになりました。一方、ChatGPTとCodexについては、EU内の対象ユーザーに限り、全プランで数週間かけて透かしが導入されます。
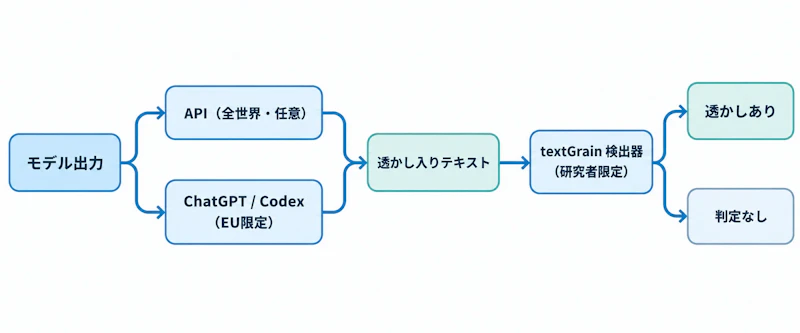
図1のように、透かしの付与経路は提供先ごとに分かれ、検出側のアクセスは別の制御下に置かれます。利用者が自分の出力に透かしを入れられても、検出器を誰でも使えるわけではないという構造です。
textGrainの仕組み
textGrainは、モデルが次に出力する語を選ぶ際の確率分布に統計的な偏りを与え、その偏りを語の選択パターンとして文章に残します。検出器はこのパターンを統計的に検定し、OpenAIの透かしが含まれているかどうかを判定する仕組みです。
検出器はユーザーを特定せず、プロンプトの内容も明らかにせず、透かしを検出したかどうかだけを返します。アクセスは当面、承認された研究者と専門機関に限定され、EUの行動規範(Code of Practice)に沿って個別審査で付与されます。OpenAIはその目的を、テキストの出所表示技術の評価と改善を支えることだと説明しています。
検出精度と編集耐性
公開された数値は、テキスト透かしの難しさをそのまま示しています。誤検出率を1%に設定した条件下での検出率は、文章の長さと編集の有無で大きく変わります。
条件(400トークン基準) | 検出率 |
|---|---|
200トークンの文章 | 約80% |
400トークンの文章 | 約95% |
同義語で10%を置換 | 約92%から約66%へ |
同義語で25%を置換 | 17% |
短い文章ほど信号が薄く、人手による書き換えで急速に弱まります。語の選び方に自由度が小さい数式中心の文章では、心理学のような記述的な文章に比べて検出率が大きく下がるとも報告されています。透かしの有無を根拠に断定的な判断を下す使い方には向きません。
透かしが示さないこと
OpenAIは、透かしで分からないことを明示しています。透かしは人間の寄与度を測るものではなく、文章の所有権を定めるものでもありません。利用者個人を特定せず、内容が正確かどうかも保証しません。
そして、透かしが検出されなかったことは人間が書いた証明にはなりません。モデルの出力を引用や要約の形で経由した場合や、別の提供者のモデルを使った場合には信号が残らないためです。教育や採用の現場で「AI生成かどうか」の判定に使う場合、この非対称性を理解していないと誤った運用につながります。評価の信頼性をどう設計するかという論点は、LLM評価の方法とは?ベンチマークとLLM-as-a-Judge、バイアス対策を解説でも扱っています。
出力品質への影響
語の選択に介入する手法であるため、回答の質が落ちないかが実務上の焦点になります。OpenAIは最新のフロンティアモデルであるAstraについて、透かしの有無で有意な性能差は見られないとして、次の比較を示しました。
ベンチマーク | 透かしなし | 透かしあり |
|---|---|---|
Artificial Analysis Intelligence Index | 49.57点 | 49.76点 |
AutomationBench | 34.09% | 34.86% |
DeepSWE v1.1 | 72.80% | 71.68% |
Terminal-Bench 4.0 | 53.90% | 56.06% |
Terminal-Bench Science 0.1 | 56.90% | 60.00% |
BrowseComp | 87.92% | 87.35% |
HealthBench Professional | 64.27% | 64.60% |
GPQA Diamond | 94.44% | 93.94% |
差は上下どちらにも振れ、おおむね測定誤差の範囲に収まっています。コーディング寄りのDeepSWE v1.1でわずかに低下した一方、Terminal-Bench系では上回っており、透かしが一方向に品質を押し下げる傾向は読み取れません。
画像や音声の仕組みとの併用
OpenAIは出所表示を複数の手法で組み合わせています。対応する画像出力にはContent Credentialsを付与し、C2PAに準拠するほか、画像と音声には不可視のSynthID透かしを埋め込みます。検証はopenai.com/verifyとContent Provenance APIを通じて提供されています。
画像や音声ではメタデータと信号の両方を使えますが、テキストはメタデータを剥がされやすく、コピー&ペーストの過程で付随情報が失われます。生成物そのものに信号を残すアプローチが選ばれた背景にはこの違いがあり、生体分子に透かしを入れるSynthID Bioのような取り組みと同様、対象の性質に応じた設計が求められます。
開発者と事業者への意味
EU向けのサービスを運用する事業者にとって、今回の発表は規制対応の手段が一次提供元から用意されたことを意味します。APIを使う場合は任意適用のため、EU内の利用者に提供するプロダクトでは自社で透かしを有効にするかどうかの判断が必要です。
一方、検出器が研究者と専門機関に限られる現状では、受け取った文章の出所を自社で検証する運用はまだ組めません。OpenAIは証拠と標準の整備に応じて方針を見直すとしており、精度や耐性の数値が改善されるまでは、透かしを補助的な手がかりとして扱う前提で設計するのが現実的です。


