 AI-Papers
- LLM評価は自動ベンチマーク、人間評価、LLM-as-a-Judge の3手法を目的別に組み合わせて使う
- プロンプト形式の違いだけで同一モデルの MMLU スコアが最大7ポイント動くなど、自動ベンチマークには再現性の落とし穴がある
- 位置バイアス、冗長性バイアス、自己優遇バイアスの定量的な影響と、順序入れ替えや合議による実務的な抑え方を解説
評価が開発のボトルネック
Large Language Model(LLM: 大規模言語モデル)を使ったアプリケーションを作るとき、最初に詰まるのはモデル選びではなく「良くなったかどうかを測る方法」です。プロンプトを書き換えた、検索対象の文書を増やした、モデルを乗り換えた。そのどれも、効果を数字で確認できなければ改善なのか改悪なのか判断できません。
Hugging Face が公開している Evaluation Guidebook は、Open LLM Leaderboard の運用で蓄積された実務知識をまとめたドキュメントです。自動ベンチマーク、人間評価、LLM-as-a-Judge(モデルに採点させる手法)の3本柱に加えて、再現性のトラブルシューティングという実務者が本当に困る章が用意されています。
この記事では、同ガイドブックと LLM-as-a-Judge の代表的な研究である MT-Bench の論文(Zheng et al., 2023)を軸に、評価手法の選び方からバイアス対策、自社 Evals(評価セット)の設計手順までを整理します。
評価手法の3つの選択肢
評価手法は大きく3種類に分かれます。どれが優れているかではなく、測りたいものと予算で選ぶものです。
項目 | 自動ベンチマーク | 人間評価 | LLM-as-a-Judge |
|---|---|---|---|
仕組み | 正解付きデータセットと指標で機械採点 | アノテーターが出力を採点・比較 | 別のLLMに採点基準を与えて採点させる |
コスト | 非常に低い | 高い | 低い(APIコストのみ) |
再現性 | 高い(設定を固定すれば) | 低い | 中程度(温度とプロンプトに依存) |
得意な対象 | 知識、分類、コード実行可否 | 有用性、文体、専門領域の妥当性 | 自由記述の相対比較、大量スクリーニング |
主な弱点 | データ汚染、形式依存 | 費用と時間、基準のばらつき | 隠れたバイアス、検証の手間 |
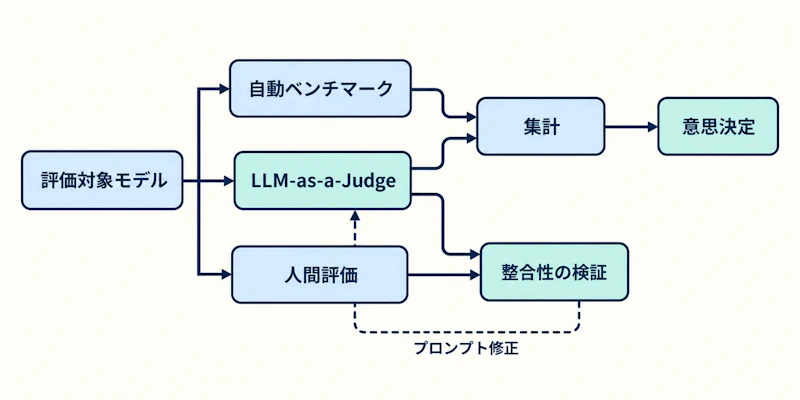
実務では3つを階層的に積みます。自動ベンチマークで候補を絞り、LLM-as-a-Judge で日々の回帰テストを回し、人間評価で判定器の妥当性を定期的に裏取りする、という流れです。
自動ベンチマークの仕組み
自動ベンチマークは、入力と正解(gold data)のペアを集めたデータセットに指標を組み合わせたものです。採点方式は2通りあります。選択肢の対数確率を比較する方式は高速で信頼度の情報も得られますが、実際の使い方とは乖離します。生成させて文字列照合する方式は実運用に近い一方、採点が難しくなります。
人間評価で気をつける点
ガイドブックが強調しているのは、ガイドラインの作り込みです。評価タスクの指示は「自分が思っているよりも曖昧」であり、複数ラウンドのアノテーションを回して認識を揃える必要があります。報酬をきちんと払うことも品質管理の一部で、安すぎる報酬は AI で生成した回答の混入を招きます。アノテーター間の一致率(inter-annotator agreement)の計測は必須です。
自動ベンチマークの落とし穴
「同じモデル、同じベンチマークなのにスコアが論文と合わない」という事態は日常的に起きます。ガイドブックは原因を具体的に列挙しています。
- 実装差。MMLU は lm_eval、HELM、原著実装で結果が有意に異なる
- プロンプト形式。選択肢の提示方法を変えるだけで同一モデルが最大7ポイント変動する
- few-shot 設定。例の個数や順序の違いで MMLU の一部サブセットが最大3ポイント動く
- チャットテンプレート。指示チューニング済みモデルに正しい前置きを与えないと、学習時の確率空間から外れた出力になる
- 実行環境。バッチサイズ、推論ライブラリ(transformers と vLLM)、数値精度、乱数シードでも差が出る
さらに根深いのがデータ汚染(contamination)です。ガイドブックは「公開データセットは、公開された時点で学習データに入ると仮定すべき」と断じています。高いスコアが本当の能力なのか、テスト問題の暗記なのかを外から区別できないわけです。対策としては、カナリア文字列の埋め込み、暗号化やアクセス制限によるクローラー対策、時間とともに更新される動的ベンチマーク、生成指標を使った事後的な汚染検出が挙げられています。
この汚染問題への実務的な回答は「自社のデータで自社の評価を作る」ことです。エージェント評価の分野でも、最終回答の文字列ではなくデータベースの状態変化で正しさを測る試みが出てきています(MicrosoftがエージェントEval「ThinkingBox」公開、DB状態で信頼性を測る)。
評価バイアスの正体
LLM-as-a-Judge は安く速く、人間の判断とある程度相関します。MT-Bench の論文では、GPT-4 を判定器にした場合の人間専門家との一致率が85%(引き分けを除く)で、人間同士の一致率81%を上回りました。Chatbot Arena のクラウドソース評価との一致率は87%でした。
ただし同じ論文は、判定器が抱える具体的なバイアスも測っています。以下は2023年当時のモデルでの数値ですが、現行モデルでも傾向自体は残ります。
バイアス | 測定内容 | GPT-4 | GPT-3.5 | Claude-v1 |
|---|---|---|---|---|
位置バイアス | 回答の順序を入れ替えても判定が一致する率 | 65.0% | 46.2% | 23.8% |
冗長性バイアス | 内容を繰り返して長くした回答に騙される率 | 8.7% | 91.3% | 91.3% |
自己優遇バイアス | 人間判定と比べた自モデルの勝率の上振れ | 約10ポイント | 未報告 | 約25ポイント |
位置バイアスの数字は深刻です。Claude-v1 を判定器にすると、順序を入れ替えた場合に判定が一致するのは4回に1回程度でした。順序をランダム化していないペアワイズ評価の結果は、提示順を測っているだけかもしれません。
ガイドブックはこれ以外のバイアスも整理しています。同じ問いを複数回投げると答えが揺れる内部一貫性の欠如、入力を意図的に劣化させても気づかない摂動への鈍感さ、学習時と異なるプロンプト形式で精度が落ちる形式バイアスです。人間のバイアスと違って検出しにくく、同系統のモデルで判定を重ねるとエコーチェンバーのように偏りが強化される点も指摘されています。
バイアスを抑える実務手順
対策はバイアスの種類ごとに決まっています。
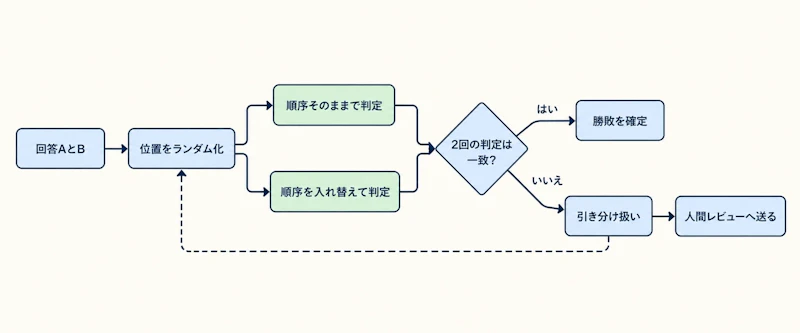
- 位置バイアス。回答位置をランダム化し、順序を入れ替えた2回の判定が一致したときだけ採用する
- 冗長性バイアス。回答長の差を採点時に明示して考慮させる、または長さを揃えて比較する
- 自己優遇バイアス。判定対象と同系統のモデルを判定器にしない、複数モデルの合議(jury)で平均をとる
- 内部一貫性。複数回サンプリングして多数決をとる(self-consistency)
- 摂動への鈍感さ。採点の前に理由を書かせ、各点数の意味を明記した採点基準をプロンプトに含める
判定の形式としては、絶対点数よりもペアワイズ比較のほうが人間の好みと相関が高く、頑健です。点数制を使うなら、整数スケールの各段階に意味を書き、「この条件を満たせば1点加算」という加点式に分解すると基準がぶれにくくなります。1つのプロンプトで有用性も安全性も文体もまとめて採点させるのは避け、評価軸ごとにプロンプトを分けるのが定石です。
あなたは回答品質の評価者です。以下の基準で加点してください。
+1: 質問に直接答えている
+1: 提示された文書の記述だけで答えている(推測を含まない)
+1: 文書に答えがない場合、答えられないと明示している
+1: 冗長な繰り返しがない

回答の長さは評価対象ではありません。長い回答を優遇しないでください。
まず各基準の判定理由を書き、最後に合計点を出してください。
出力は {"reasoning": "...", "score": 0-4} の JSON 形式で返してください。
判定器そのものを評価する
見落とされがちなのが、判定器の検証です。ガイドブックは判定器を1人の人間アノテーターと同じように扱い、人間のラベルとの一致率を計算することを勧めています。手順はシンプルです。
- 自社データから50〜100件を抽出し、人間が正解ラベルを付ける
- 同じデータを判定器にかけ、一致率を測る
- 食い違った事例を全件読み、原因が基準の曖昧さか判定器の限界かを切り分ける
- プロンプトを直して再計測し、一致率が実用水準に届くまで繰り返す
また、LLM-as-a-Judge を使うべきでないタスクも明示されています。ハルシネーション検出(とくに一部だけが誤っている場合)、要約の品質評価、根拠への忠実性の判定です。これらは人間の専門家によるレビューが推奨されています。非専門家を基準にするのも危険で、医療、法務、数学といった領域では一般のアノテーターが正解の基準になりません。
自社Evalsの作り方
最後に、自分のユースケース向け評価セットを作る手順を5段階でまとめます。
1. データセットを用意する
評価結果の質は評価データの質を超えません。既存データセットを使う場合は、作成者、アノテーター間一致率を確認し、ランダムな50件を自分の目で読んでください。自作する場合は、既存データの集約、人間アノテーターによる作成、LLM やルールベースによる合成を組み合わせます。実際の問い合わせログから始めるのがもっとも確実です。
2. タスクと推論方式を決める
選択式にして対数確率を比較するか、生成させて中身を見るかを決めます。知識の有無なら前者、実運用での振る舞いなら後者です。
3. プロンプト形式を固定する
意味が同じでも書き方が変わると結果が動きます。複数の形式で試して感度を把握し、採用した形式を設定ファイルに記録しておきます。few-shot 例に頼りすぎると形式への過適合が起きる点も注意が必要です。
4. 指標を選ぶ
選択式なら正規化済み正解率、生成タスクなら正規化方法を決めたうえで完全一致から ROUGE までを選びます。安全性が絡む用途では平均値ではなく最悪ケースを見るべきです。コードなら単体テストでの実行、指示追従なら IFEval 方式の形式検証のように、機械的に判定できる形へ落とし込めるかを考えます。
5. 検証して運用に組み込む
作った評価セットが実際の品質差を区別できるか、既知の良いモデルと悪いモデルで確かめます。そのうえで CI に組み込み、プロンプト変更やモデル更新のたびに自動実行する形にします。
評価セットは一度作って終わりではありません。本番で見つかった失敗事例を評価セットに追加し続けることで、自社の要件に合った、汚染されていない指標が育っていきます。地味な作業ですが、ここを整備したチームだけが改善のループを回せます。


