 AI-Papers
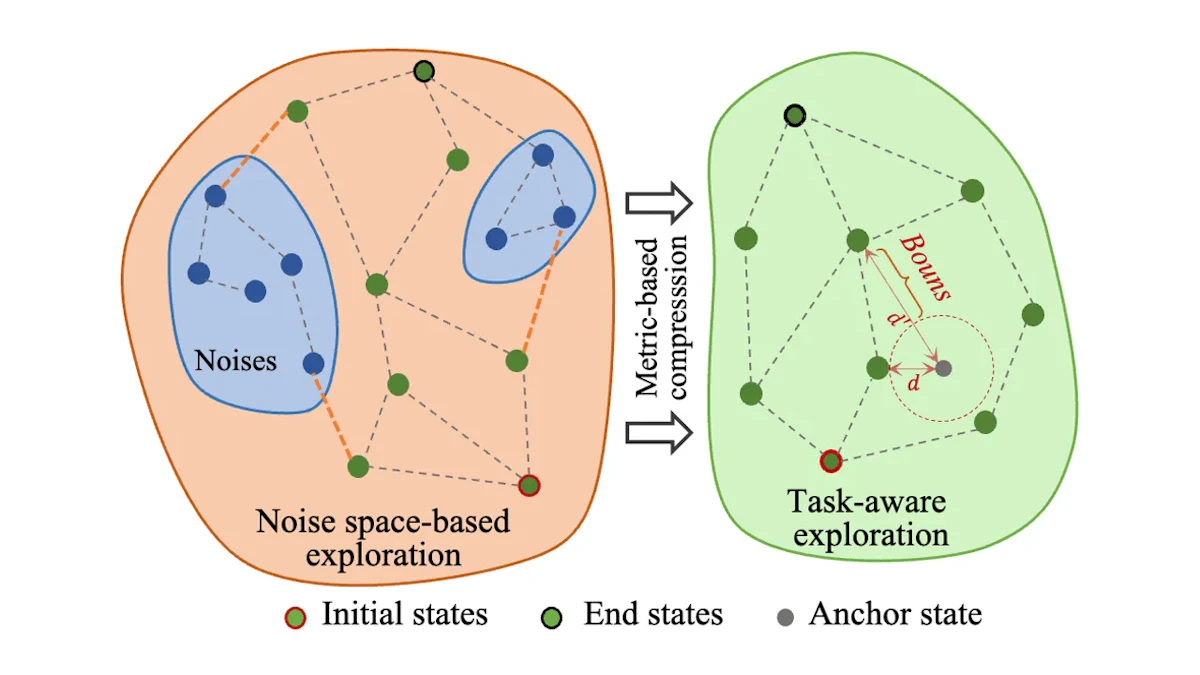
- ガウス報酬予測器で双シミュレーション指標の退化を防ぎ、疎報酬下でもタスク関連表現を安定して学習できる理論保証付きの仕組みを実現
- MetaWorldのStick-pull課題で成功率87.9%を達成し、DrMやRAP等の最先端ベースラインを大きく上回る探索効率を実証
- ポテンシャルベースの探索ボーナス設計により、最適方策を変えずにタスク認識型の内発的報酬を生成することを理論的に保証
研究の背景
視覚強化学習(Visual Reinforcement Learning)では、エージェントが生の画像を観測として行動を学習します。しかし多くの実世界タスクでは、報酬がほとんど得られない「疎報酬」環境での探索が求められ、学習が著しく困難になります。
この課題に対し、状態の新規性に基づく探索ボーナスを与える手法が広く研究されてきました。なかでも双シミュレーション(Bisimulation)指標は、タスクに関連する状態の類似性を測る枠組みとして注目されています。ところが疎報酬環境では報酬差がほぼゼロになるため、双シミュレーション指標が退化してしまい、あらゆる状態が同一距離に押しつぶされる問題が生じます。
既存の探索手法の多くは、背景の色変化や照明のゆらぎといったタスクと無関係な視覚的変動にも反応してしまい、本来のタスク達成に貢献しない非効率な探索を行いがちです。こうした問題を根本から解決するため、Dayang Liangらが提案したのがTEBです。
提案手法:TEBの仕組み
TEB(Task-aware Exploration via Bisimulation)は、双シミュレーション指標を予測的に拡張することで、疎報酬下でもタスク認識型探索を実現する手法です。
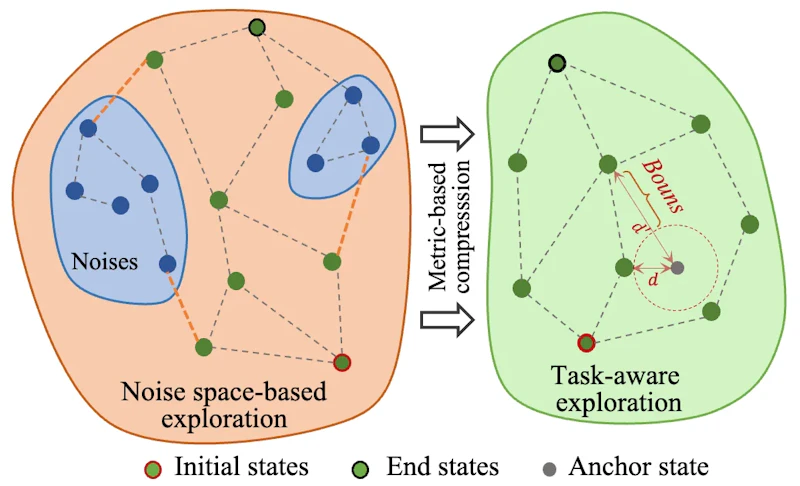
TEBの核心は「予測的双シミュレーション指標」です。通常の双シミュレーション指標は即時報酬の差を使って状態間の距離を定義しますが、疎報酬環境では即時報酬がほぼゼロのため指標が崩壊します。TEBはこれを解決するため、ガウス報酬予測器を導入しています。
ガウス報酬予測器は、平均μと分散σの組み合わせで報酬を確率的にサンプリングします。疎報酬領域でも分散項が「エネルギーの底」として機能するため、エンコーダへの勾配信号が途絶えません。疎報酬下でも「期待される指標の直径が厳密に正の値を保つ」ことが数学的に保証されており(論文定理3.3)、指標の退化を根本から防ぎます。
もう一つの柱が「ポテンシャルベース探索ボーナス」です。バッチ平均から計算される疑似アンカー状態との距離をポテンシャル関数として定義し、連続する状態間の相対的な新規性を内発的報酬として与えます。EMPO²などLLMエージェントにおける探索改善手法とは異なり、TEBは視覚観測から直接表現を学習しながら探索を行う点が特徴です。この設計は最適方策を変えない「報酬整形(Reward Shaping)」の理論に基づいており、探索を促進しながらタスク最適な行動を維持することが理論的に保証されています(論文定理3.5)。
実験結果
TEBの性能は、視覚的ロボット操作ベンチマーク「MetaWorld」と迷路探索タスク「Maze2D」の2つの環境で評価されました。
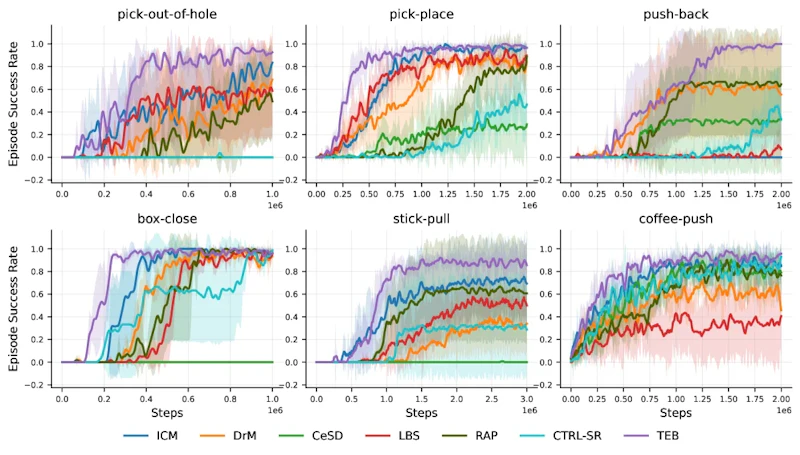
MetaWorldでは、スティック引き抜き「Stick-pull」など難度の高い6タスクで実験を実施。TEBはStick-pullで成功率87.9%、Push-backで98.4%を達成し、DrM・CTRL-SR・RAP・CeSDといった最先端ベースラインを大幅に上回りました。
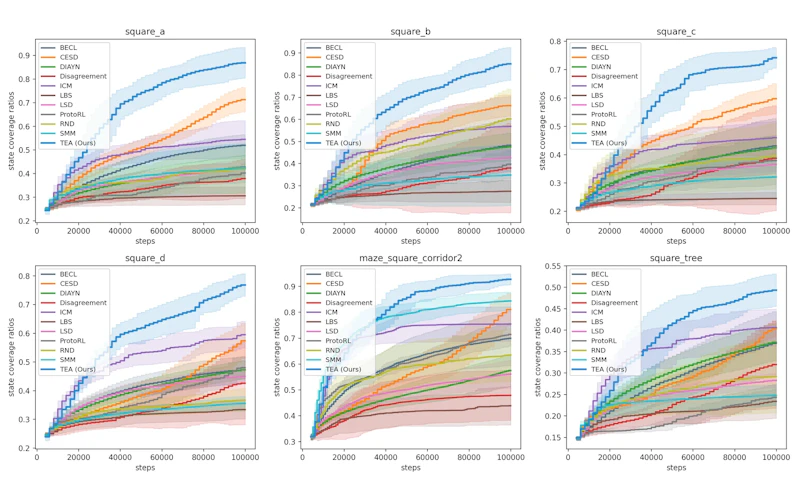
Maze2Dでの状態カバレッジ実験では、Square-a課題でカバレッジ0.87(CeSD比0.71)、Square-b課題で0.85(CeSD比0.66)を達成。RNDやICMなどの内発的動機付け手法やスキル発見手法を上回る広範な探索を示しました。
アブレーション研究では、表現学習の除去と内発的報酬の除去がともに性能低下を招くことを確認。疑似アンカー(バッチ平均)がランダムアンカーや固定アンカーを大幅に上回ることも明らかになりました。加えて、予測報酬を用いた双シミュレーション指標が環境からの実際の報酬を用いた版を一貫して上回ることが示されており、提案の核心的なアイデアの有効性が裏付けられています。
まとめ
TEBは、疎報酬下の視覚強化学習という難しい問題に対し、双シミュレーション指標の退化を防ぐ理論的な仕組みとタスク認識型の探索ボーナスを組み合わせた手法です。MetaWorldとMaze2Dの両環境で既存手法を上回る成果を示しており、視覚観測を扱うロボット制御や複雑な操作タスクへの応用が期待されます。
最適方策の理論保証を維持しながら探索効率を高める設計は、実用上の信頼性という面でも重要な貢献といえます。一方で、より高解像度の視覚入力や多様なロボット環境への汎化性能については、引き続き検証が必要な領域として残されています。
論文情報: "Task-Aware Exploration via a Predictive Bisimulation Metric"(Dayang Liang et al., 2026) arXiv:2602.18724, CC BY 4.0
本記事の図(図1、図2、図7)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


