 AI-Papers
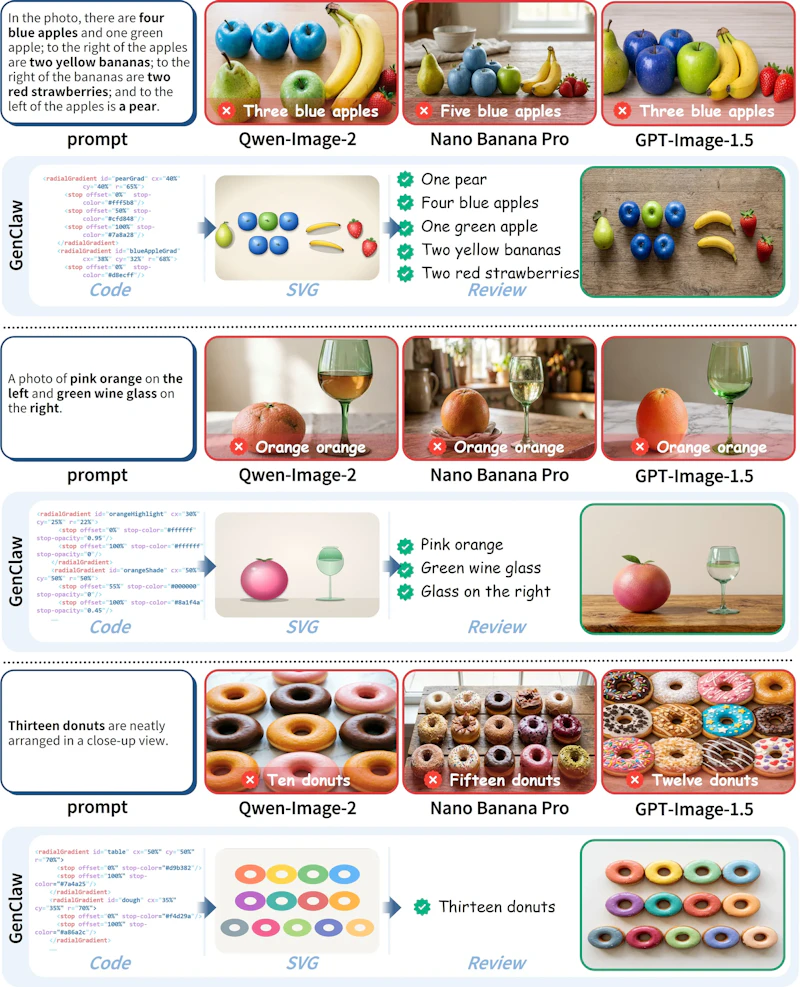
- SVG・HTMLコードを「視覚スケッチ」として活用する3段階パイプラインで、オブジェクトの位置・数・属性を明示的に制御できる
- GenEval++で複合スコア0.878を達成し、比較手法の最高値(0.782)を約10ポイント上回る性能を実証
- テキスト描画をコードで確定的に処理し、長文ポスター・物理シミュレーション・レイヤー編集まで幅広く対応
プロンプトだけに頼る限界
「左に赤い円、右に青い三角を3つ」といった空間的な構成を画像生成AIに指定しても、意図どおりの結果を得るには試行錯誤が避けられません。プロンプトを書き換えても出力は確率的に変わり、同じ構成を安定して再現することが難しいのが現状です。
この問題の根本には、テキストプロンプトが画像生成モデルのブラックボックス処理に直接渡されるという構造があります。意図を修正する手段がプロンプト変更しかないため、複雑な構成や物理的な正確さが求められる場面では限界が顕在化してきました。
3層に分離したパイプラインの構造
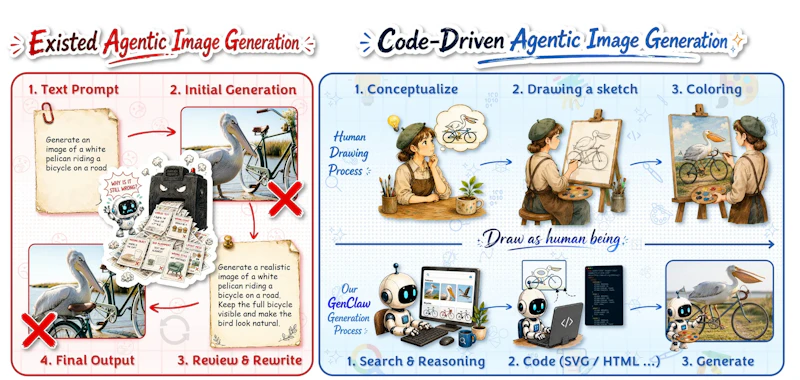
テンセントHunyuanのチームが提案したGenClawは、人間のアーティストが手順を踏んで作品を仕上げるように、AIも「構想→スケッチ→着色」の3段階で画像を生成するフレームワークです。各段階を独立した層として設計することで、意図の解釈と視覚表現の生成を明確に分離しています。
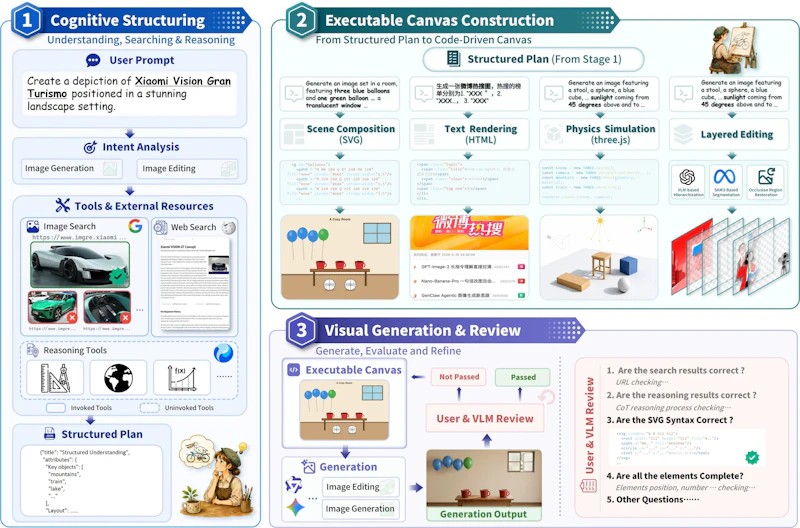
第1層の「認知構造化層(Think)」では、Large Language Model(LLM)がユーザーの意図を解析し、検索ツールで不足している知識を補完します。「オブジェクトを何個どこに配置するか」「物理的な数値はどの程度か」といった情報をJSON形式で整理し、次の層に渡す役割を担います。
第2層の「実行可能キャンバス層(Sketch)」が、このフレームワークの核心です。LLMが出力するのはピクセルではなく、SVG・HTML・Python・Three.jsなどのコードです。タスクの性質に応じて言語を使い分けており、SVGはオブジェクトの座標やサイズを数値で定義し、HTMLはテキスト集約タスクや多言語ポスターのレイアウトに対応し、Three.jsは物理シミュレーションを担当する設計です。このコードを実行して得られる出力が「視覚スケッチ」と呼ばれる下書きレイアウトになります。
第3層の「視覚生成・レビュー層(Color)」では、その視覚スケッチを受け取った画像生成モデルがテクスチャやフォトリアリズムを付与します。さらにVLM(視覚言語モデル)が生成結果を自動検証し、意図と一致しない場合はフィードバックを返してやり直す仕組みも組み込まれています。
コード駆動が活きる具体例
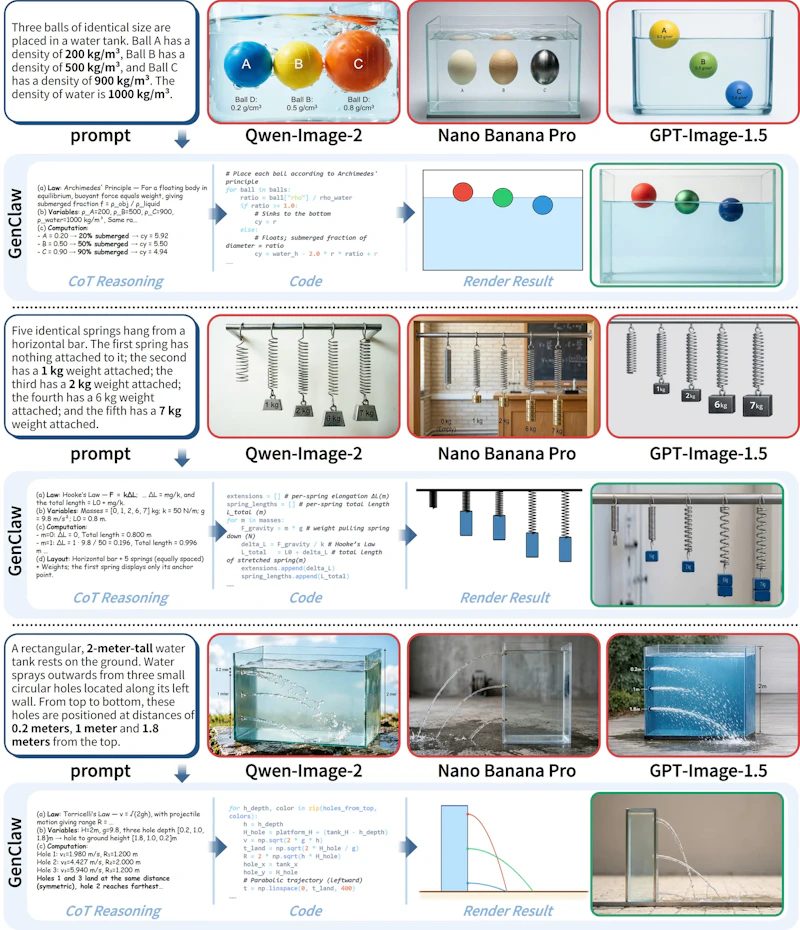
複数オブジェクトの正確な配置や属性バインディング(「赤い円3つと青い三角2つ」のような指定)では、SVGの座標定義によって数え間違いや属性の混同を防げます。テキストを含む長文ポスターでは、HTML・CSSレイアウトがフォントや行間を確定的にレンダリングするため、モデルがピクセルレベルで文字を「推測」する必要がなくなります。英語・中国語ともに98%以上の精度で文字を再現でき、MRTのような領域ごとに制御を分けるアプローチと同様の考え方を、テキスト描画にも応用した設計といえます。
物理現象の再現では、Three.jsでばねの変形量や水の噴射距離を先に計算し、得られた数値を画像生成モデルに渡す手順を踏みます。これにより、従来モデルが苦手としていた直感的物理(重力、弾性など)の表現精度が大幅に向上し、長い文章を含むポスターも高い再現性で仕上げることができます。
ベンチマークによる性能検証
複合的な画像生成能力を評価するGenEval++では、GenClawが総合スコア0.878を記録しました。比較手法の最高値はMind-Brushの0.782であり、約10ポイントの差をつけています。オブジェクトの数を正確に生成する「Count」指標では0.950に達し、空間的な正確さでも他の手法を上回りました。
知識と推論を組み合わせた画像生成を評価するMind-Benchでは、総合スコア0.57を達成しました。比較対象のMind-Brush(0.31)やNano-Banana Pro(0.38)と比べて顕著な差が確認されており、推論主体のサブカテゴリでは0.38対0.10と大きく引き離しています。
レイヤー編集の精度を測るImgEdit評価では、画質指標PSNR(Peak Signal-to-Noise Ratio)が27.87に達し、GPT-Image-1.5の16.36を上回りました。編集対象外の領域を保護する仕組みが安定して機能していることを示す結果です。
課題と今後の可能性
GenClawには制約もあります。最終的な画質は下層の画像生成モデルに依存するため、モデル側の品質限界がそのまま上限となります。3段階のパイプラインを経由する分、単純な1回推論と比べて処理時間の増加も避けられない点です。コード生成でエラーが発生した場合、スケッチが不完全になりレイアウトが崩れるリスクも残ります。
それでも「コードを中間表現として使う」という設計は、画像生成の解釈可能性と空間制御性を根本的に改善する可能性を持っています。LLMが推論・検索・コード生成を担い、画像生成モデルが仕上げに専念するという分業体制は、今後のマルチモーダルエージェント設計における一つの有力な方向性を示した研究といえるでしょう。
論文情報: "GenClaw: Code-Driven Agentic Image Generation"(Junyan Ye et al., 2026) arXiv:2605.30248
本記事の図(図1、図3、図4、図6)は解説のため上記論文より引用しています。


