 AI-Papers
- テキスト・リレーショナルテーブル・知識グラフなど異質な情報源を、各ソースのネイティブ形式を保持したまま自然言語で横断検索できる
- ソース選択・ネイティブクエリ生成・証拠統合の3段階パイプラインで、既存RAGの「テキスト均質化」問題を解決
- 13データセット・309の知識ベースで評価し、単一ソース特化のベースラインを上回るソース選択精度65.71%を達成
研究の背景
実際のビジネス現場では、情報は一箇所にまとまっていません。製品仕様書はテキスト文書として、売上データはリレーショナルデータベースのテーブルとして、組織間の関係性は知識グラフとして、それぞれ異なる形式で管理されています。
従来のRAG(Retrieval-Augmented Generation)は、こうした多様なデータをすべてテキストに変換してベクトル化する方式が主流でした。しかし、SQLのJOIN演算や知識グラフの多ホップ推論など、構造化データが本来持つ表現力が変換の過程で失われてしまいます。この「テキスト均質化」の問題を解決するために提案されたのがOmniRetrievalです。
企業のデータサイロ問題は深刻で、情報統合の難しさがAI活用の障壁になるケースは少なくありません。Gleanのような企業向けAI検索が急成長している背景にも、この課題があります。OmniRetrievalはそこに対して、ソース固有の構造を壊さないという別のアプローチで応えます。
3段階パイプラインの仕組み
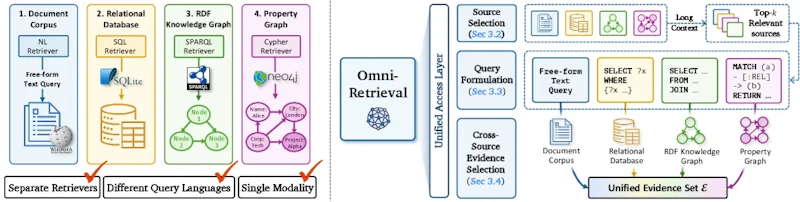
OmniRetrievalは自然言語のクエリを受け取り、以下の3段階で回答を導き出します。
第1段階: ソース選択(Source Selection) — 長いコンテキストを扱えるLLMが、登録されたすべての知識ベースの構造情報(スキーマやオントロジーの概要)を一度に読み込み、質問に適したソースをランク付けします。単一のソースに絞り込むのではなく、最大k個の候補を保持することで、曖昧な質問でも柔軟に対応できます。
第2段階: ネイティブクエリ生成(Query Formulation) — 選ばれた各ソースに対して、そのソース固有のクエリ言語でクエリを生成します。リレーショナルデータベースにはSQL、RDF形式の知識グラフにはSPARQL(グラフデータを扱う標準クエリ言語)、ラベル付きプロパティグラフにはCypher(Neo4jなどで使われるグラフ専用のクエリ言語)、テキストコーパスには自由形式の検索クエリを使います。こうして各ソースの表現力を最大限に引き出します。
第3段階: クロスソース証拠統合(Evidence Selection) — 複数ソースから得られた結果(SQL行、RDFトリプル、グラフパス、テキスト段落)をLLMが横断的に評価し、質問への回答に最も適した証拠を選別します。異なる形式の結果をそのまま扱えるため、変換による情報ロスが生じません。
実験結果と性能
評価は13のデータセット(文書検索7件、SQL系286件、SPARQL系1件、Cypher系15件)、計309の知識ベースを対象に実施されました。
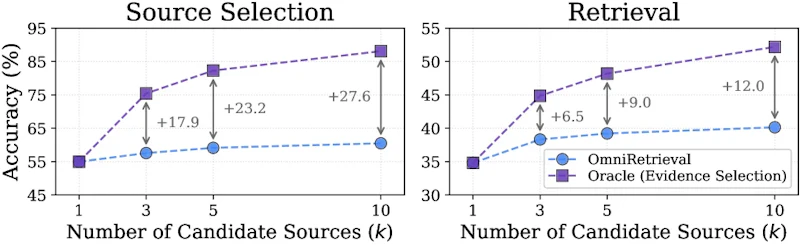
主な結果として、OmniRetrievalはすべてのカテゴリで単一ソースのベースラインを上回りました。ソース選択精度は65.71%(ベースライン61.65%)、LLMによる最終回答精度は65.88%(ベースライン57.99%)を記録しています。
候補数kは3が最適であることも判明しました。kを増やすと選択肢が広がる一方、LLMによる絞り込みが困難になりトータル精度が低下します。モデル規模の面では、2B程度の小型モデルでは複数パラダイムの候補を適切に生成できず、27B以上の規模で安定した効果が得られることが示されました。
まとめと今後の課題
OmniRetrievalは、異なる構造の知識ソースをネイティブ形式のまま扱える統一検索フレームワークです。テキストへの変換に頼る従来手法と異なり、SQLのJOINや知識グラフの多ホップ推論といった構造的操作を正確に実行できる点が強みです。
新しいソースの追加はインフラを再構築せず登録だけで済むため、拡張性も高く設計されています。一方で、ソース選択ステップがボトルネックになりやすく、大型モデルを必要とすることはコスト面での制約になります。今後は小規模モデルでの精度向上や、よりリアルタイムなソース追加への対応が課題となるでしょう。
論文情報: "OmniRetrieval: Unified Retrieval across Heterogeneous Knowledge Sources"(Jinheon Baek et al., 2026) arXiv:2605.29250
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


