 AI-Papers
- 単ターンで高性能な編集モデルでも、出力を入力に戻して編集を繰り返すと意図しない変化が蓄積し、15〜20ターンで画像が崩れる
- TailSteerはデノイジング軌道の前半を基盤モデルのまま保ち、保存のための補正を末尾付近に集中させる最終段階の学習手法
- FLUX.2 [klein] Base 9BではPSNRが13.85から19.96に改善し、単ターン編集のGEdit-ENは7.47から7.52とほぼ維持
研究の背景
画像編集モデルの評価は、1枚の入力に1つの指示を与える単ターン設定で行われることが多く、近年のモデルはこの設定で高い性能を示しています。しかし実際の制作現場では、生成された画像にさらに指示を重ねる対話的な使い方が一般的です。
このとき、1回あたりはごくわずかな色やテクスチャの変化でも、出力を次の入力として使い続けることで誤差が積み上がります。数ターン後には背景の色が変わり、人物の顔立ちが別人になり、以前に追加した要素が消えるといった累積ドリフトが起こります。
既存の対策は大きく2種類に分かれます。多ターンのデータを作り直して再学習する方法は、データ構築のコストが高く、事前学習で獲得した生成能力を損ないやすいという問題があります。推論時に外部の仕組みを差し込む方法は、巨大な基盤モデルへの適用が難しいうえ、サンプリング全体に介入することで出力の質そのものを変えてしまいます。
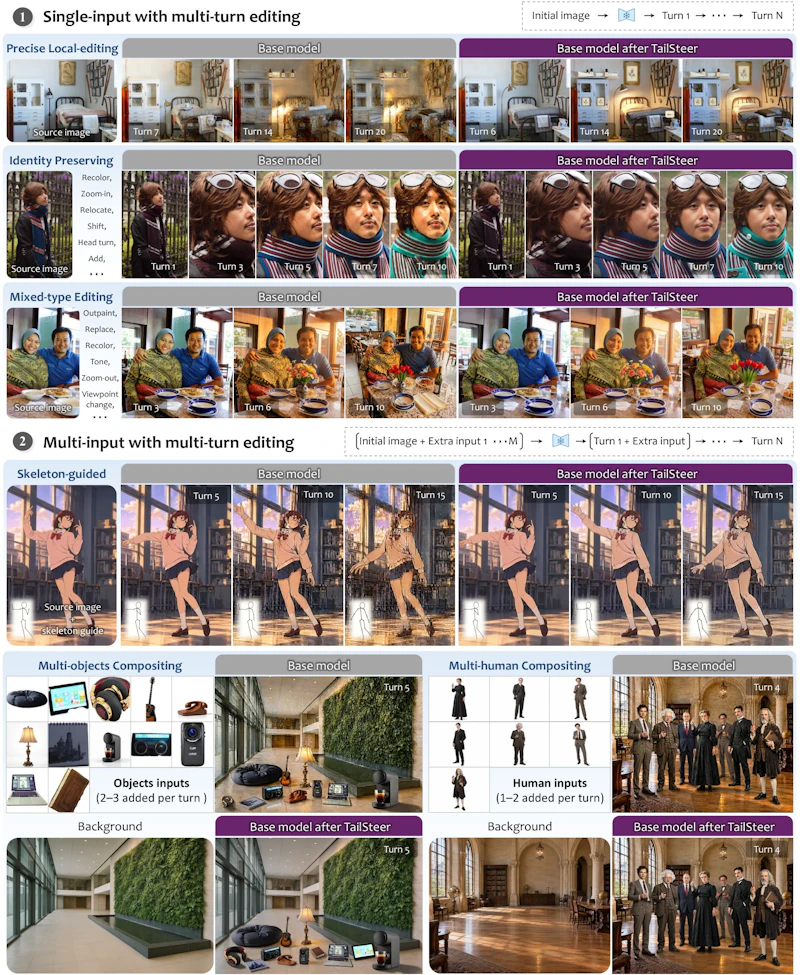
中国香港中文大学などの研究チームが提案したTailSteerは、この課題を最終段階の学習という形で扱います。すでに学習を終えたモデルに対し、介入する範囲を軌道の末尾に限定した追加学習を施すという設計です。図1のように、20ターン近くまで編集を重ねても元画像の要素が保たれています。
なぜ軌道の末尾なのか
提案手法の出発点は、拡散モデルのデノイジング過程を周波数の観点から分析した結果にあります。画像の大まかな構造にあたる低周波成分は軌道の早い段階で決まり、細かな質感にあたる高周波成分は終端近くでようやく定まっていきます。
一方で、編集しない領域の保存誤差はサンプリングが進むにつれて下がり続けますが、終端に到達してもゼロにはなりません。つまり軌道の末尾は、まだ修正の余地が残っている区間だということになります。
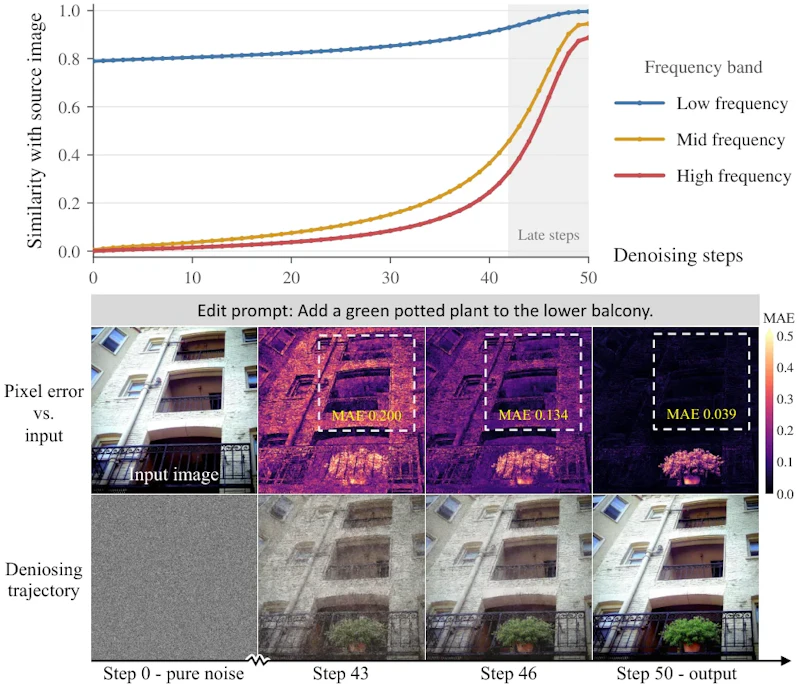
では最終ステップだけを学習すればよいのか、という単純な案も検証されています。実験では、最終1ステップで保存を狙った補正をかけると長期の保存性は確かに改善しますが、そのモデルをサンプリング全体に使うと彩度が落ち細部が失われました。早期のダイナミクスは基盤モデルのまま残す必要がある、という結論が導かれています。
TailSteerの仕組み
TailSteerは軌道をステアリング開始点で2つに分けます。開始点より前の先行区間では、学習対象のモデルの速度予測が凍結した基盤モデルの予測と一致するよう教師信号を与えます。ここでは挙動を変えないことが目的です。
開始点から終端までの遷移区間では、基盤モデルの速度と、保存目標へ向かう速度を混ぜた信号を目標にします。混合の重みは開始点で基盤側100%から始まり、終端に向かって保存側へ滑らかに移っていきます。急激な切り替えを避けることで、画質を保ちながら保存を強めるという設計です。
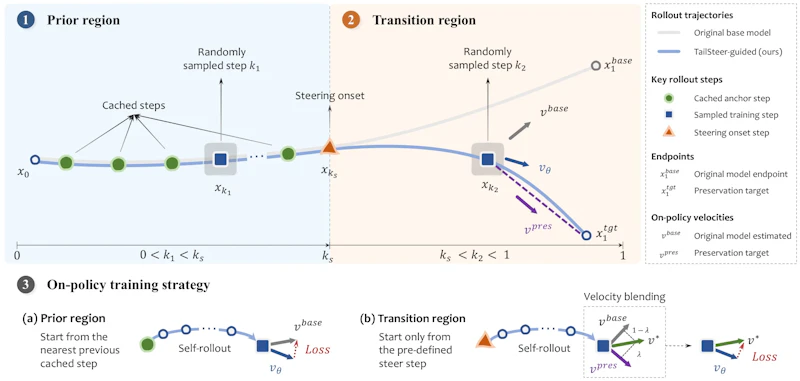
学習はon-policy、つまりモデル自身が実際に到達した状態で目標を再計算する形で行われます。先行区間では直前のキャッシュ済み状態から、遷移区間では固定したステアリング開始状態からロールアウトし、サンプリングした1ステップの予測にのみ勾配を流します。推論時はモデルの切り替えが不要で、通常どおり全ステップを1つのモデルで走らせられます。
学習データの作り方
保存の教師信号は、凍結した基盤モデル自身のロールアウトから作られます。キュレーション済みの編集ペアを人手で用意する必要がない点が、この手法の実用上の利点です。
使われるのは2種類の編集です。何も変えない恒等編集は画像全体の保存軌道を与え、局所編集は変更領域以外を保存する部分的な教師信号になります。局所編集のマスクは入力と生成結果の差分から取得し、整合性チェックを通った軌道だけをキャッシュします。Open ImagesとMONETから集めた11,947枚を元に、主要設定では38,540本の軌道が使われました。
実験結果
検証はFLUX.1 Kontext [dev]、FLUX.2 [klein] Base 9B、SenseNova-U1.5-8B-MoT、Qwen-Image-2.1の4モデルで行われています。評価は3つの観点に分けられました。
- テキストから画像生成の維持(Qwen-Image-Bench、BizGenEval)
- 単ターン編集の維持(GEdit-Bench、RISEBench、ImgEdit-Bench)
- 多ターンのドリフト耐性(MSE-Bench、EdiVal-Bench、独自のAdd & Preserve)
独自構築したAdd & Preserveは100枚の画像を10ターン編集する設定で、追加指示の達成と未変更領域の保存を同時に測ります。FLUX.2 [klein] Base 9Bでの主要な数値は次のとおりです。COAは指示した追加が反映されたかを測る指標で、PSNRとSSIMは高いほど、LPIPSは低いほど元画像が保たれていることを示します。
手法 | COA | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
FLUX.2 [klein] Base 9B | 31.02 | 13.85 | 0.289 | 0.524 |
TailSteer | 31.84 | 19.96 | 0.621 | 0.290 |
GPT-Image-2.5 Sunburst | 98.29 | 18.55 | 0.540 | 0.378 |
PSNRは13.85から19.96へ、LPIPSは0.524から0.290へ改善し、保存性の3指標ではAPI経由のGPT-Image-2.5 Sunburstを上回りました。ただしCOAでは98.29対31.84と大きな差があり、指示追従の面では商用モデルに届いていません。FLUX.1 Kontextでも、PSNRが18.64から21.02、LPIPSが0.388から0.257へと同様の傾向が確認されています。

単ターン性能の維持も確認されました。GEdit-ENは7.47から7.52、ImgEditは4.20から4.19、Qwen-Image-Bench英語版は49.27から49.42とほぼ横ばいです。一方でRISEBenchの正解率は14.17から13.61へ下がっており、空間推論を要する編集では若干の犠牲が生じています。
学習方法の比較実験では、最終ステップのみの学習が最も成績が悪く(COA 13.10、PSNR 14.93)、通常のSFTはドリフトを減らすものの指示追従が弱まりました。on-policy学習を外すと保存性は保てても空間推論が落ちる(RISE 11.39対13.61)という結果で、各要素が役割を分担していることが示されています。
まとめと今後の展望
TailSteerは、多ターン編集の崩れという実用上の問題に対し、学習の介入範囲を軌道末尾に絞るという切り口で応えた研究です。多ターンのロールアウトやキュレーション済み編集ペアを必要とせず、基盤モデル自身の出力から教師信号を作る点が、大規模モデルへの適用を現実的にしています。
課題も残ります。指示追従の絶対性能は商用モデルとの差が大きく、空間推論ベンチマークではわずかな低下が見られました。ステアリング開始点はモデルごとに手で設定されており、保存と編集の強さのバランス調整が自動化されていない点も実運用では気になるところです。動画領域での同種の課題を扱ったMoviEditとあわせて見ると、編集の連鎖における一貫性維持が画像と動画の双方で焦点になっていることがわかります。
プロジェクトページは https://lyricccco.github.io/tailsteer/ で公開されています。
論文情報: "TailSteer: Trajectory-Tail Steering for Drift-Resistant Multi-turn Image Editing"(Ruikang Li et al., 2026) arXiv:2611.06741
本記事の図(図1、図2、図5、図6)は解説のため上記論文より引用しています。


