 AI-Papers
- チャンク交互型の全二重音声言語モデルで、聴取中の空き計算を使って次チャンクの出力を先読みする学習不要の手法
- 「次の音声が来ても出力は95.3%変わらない」「変わる場合の88%は先頭トークンから」という計測が設計の土台
- 発話チャンク2.6〜2.8倍、ツール呼び出し最大23.41倍の高速化、応答開始の遅延は平均73%減の74〜241ms
研究の背景
人と自然に会話できる音声AIを作るうえで厄介なのが、聞きながら話すという同時進行の処理です。現在広く使われている方式のひとつがチャンク交互型の全二重音声言語モデルで、時間を一定長の区間(チャンク)に区切り、聴取する区間と発話する区間を交互に処理していきます。
この方式には計算負荷の偏りという問題があります。相手の声を聞いているだけの区間では、モデルはほとんど何も生成しないため計算資源が遊んでいます。一方で自分が話す区間やツール呼び出しのテキストを出す区間では、トークンを1つずつ順番に生成する逐次処理が必要になり、ここが応答の遅れとして表に出ます。
中国科学技術大学などの研究者らが発表した論文「Decode Before You Hear: Speculative Listening for Chunk-Interleaved Full-Duplex Speech Language Models」(arXiv:2611.06982)は、この遊んでいる計算を応答の先読みに充てるという発想で遅延を削る手法を提案しています。追加学習が不要で、出力も元のモデルと変わらない(ロスレス)点が特徴です。
2つの計測的な発見
手法の出発点は、著者らが4つのモデル(自前で学習したStreaming SLM、Gander、Realtime-Venus、LWS)の挙動を調べて得た2つの観察です。1つめは、次に届く音声チャンクをデジタル的な無音と仮定して先に生成しても、実際の音声を入れた場合の出力と95.3%のチャンクで一致したという結果です。相手が話している最中でも、モデルの次の一手は多くの場合すでに決まっているということになります。
2つめは、出力が食い違った残りのケースについてです。食い違いの約88%は、出力の先頭トークンの時点で既に分岐していました。言い換えれば、先頭さえ当たれば後続はほぼ付いてくる、という構造が見えてきます。この2点がそのまま、無音を仮定した先読みと、先頭トークンの第2候補を押さえるという設計につながっています。
Speculative Listeningの仕組み
提案手法のSpeculative Listeningは、投機的デコーディング(小さなモデルなどで下書きを作り、本体でまとめて検証して高速化する技術)を、別モデルではなく自分自身と「入力の先読み」に対して適用したものです。聴取チャンクの空き時間に、モデルは次チャンクの入力を無音だと仮定して出力の下書きを作ります。
さらに、先頭トークンで分岐するという発見に対応して、確率2位の先頭トークンから始まる第2の枝も並行して下書きします。作られた下書きはチャンクを越えて仮説プールに蓄積され、後の検証でも使い回されます。実際の音声が届いた時点で、1回の順伝播でその音声を取り込みつつ下書き全体を検証し、一致した部分をまとめて確定します。外れた分だけ通常の生成に戻るため、最終的な出力は元のモデルと同一です。
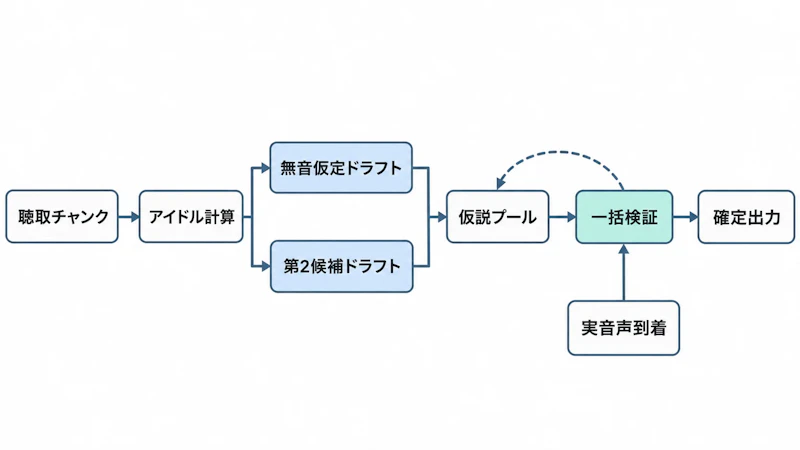
図1のように、下書きの生成と検証は会話の進行と並走します。聴取チャンクの空き時間はもともと捨てていた計算なので、先読みが外れても会話全体の処理量はほとんど増えません。
実験結果
評価には著者らが構築したTickTock-Benchが使われました。音声推論(Web Questions、Llama Questions、TriviaQA、AlpacaEval、Big Bench Audio)、会話のやり取りの自然さ(Full-Duplex-Bench v1およびv1.5)、エージェント的なツール利用(Full-Duplex-Bench v3)の3カテゴリ、計8タスクという構成です。
主な結果は次の表のとおりです。比較対象には、既存の投機的デコーディング手法であるPLD、Token Recycling、lookahead decodingが使われています。
指標 | 結果 |
|---|---|
発話チャンクの高速化 | 約2.6〜2.8倍 |
ツール呼び出しの高速化 | 最大23.41倍(Streaming SLM)、3.45倍(Gander) |
応答開始までの遅延 | 平均73%減、74〜241ms |
実時間からの最大遅れ | 平均94.4%減 |
既存手法(PLD等)の高速化 | 約0.96〜1.23倍 |
応答開始の74〜241msという値は、人間同士の会話で次の話者が話し始めるまでの間隔(おおむね200ms前後)に近い水準です。既存の投機的デコーディング手法がほとんど効いていない点も対照的で、音声の全二重処理という構造に合わせた先読みであることが効いていると読めます。
切り分け実験では、無音仮定の下書きだけでも発話チャンクは2.6〜2.9倍速くなる一方、ツール呼び出しは1.2〜1.4倍にとどまりました。ツール呼び出しでの大きな伸びは仮説プールが主な要因で、第2候補の枝はそれより小さい追加効果という位置づけです。計算量の少ない音声モデルという文脈では、Phonon TTSのような軽量な音声合成とは異なり、モデルを小さくせずに待ち時間だけを削るアプローチになっています。
まとめと今後の展望
追加学習なしで既存モデルにそのまま載せられ、出力も変えずに遅延だけを削れるという点は、リアルタイム音声AIを組む側にとって扱いやすい性質です。ただし論文自身が挙げる適用範囲の制約も小さくありません。
- 同時接続が少ない運用が前提。1台のGPUで多数のセッションを捌くと空き時間が消える
- 測定対象はテキストの背骨部分(Thinker)のみで、音声合成の処理時間は含まない
- Moshiのような並列ストリーム型のアーキテクチャには直接適用できない
とくに同時実行数が増えると前提が崩れるという点は、商用サービスでそのまま効果が出るかを左右します。今後の方向としては、デジタルな無音以外の入力仮定、たとえばストリーミングで届く音響特徴を使った下書きが挙げられています。計算の遊びを遅延の削減に変換するという考え方自体は、全二重以外のストリーミング処理にも広げやすいでしょう。
論文情報: "Decode Before You Hear: Speculative Listening for Chunk-Interleaved Full-Duplex Speech Language Models"(Yutong Bian et al., 2026) arXiv:2611.06982


