 AI-Papers
- Top-kとTop-pそれぞれの構造的な失敗パターンを理論的に解明し、和集合演算で両者の長所を統合したハイブリッドマスキング規則を提案
- フリーズしたフルアテンション教師モデルの速度予測に学生モデルを合わせるVelocity Distillation Lossにより、データ分布の不一致問題を回避した微調整を実現
- Wan2.1-1.3B(480p)で95%のアテンションスパース性と16.2倍の高速化を達成し、VSA・VMoBA・SLAなど既存手法を全評価指標で上回る
研究の背景
テキストから動画を生成する拡散モデル(Diffusion Model)は、近年のビデオ生成AIの中核技術となっています。しかし、Transformerベースのモデルで用いられるアテンション機構(入力トークン同士の関連性を計算する仕組み)は、トークン数の2乗に比例して計算量が増加するため、長尺・高解像度のビデオ生成では深刻な計算コストのボトルネックになっています。
この問題へのアプローチとして、計算に不要な注意パターンを省略するスパースアテンションが注目されています。既存手法では、スパース性(省略割合)を高めると生成品質が低下するというトレードオフが避けられませんでした。清華大学の研究チームはこの課題に取り組み、SpargeAttention2を発表しました。
Top-kとTop-pの限界を解剖する
スパースアテンションでは、各クエリトークンがどのキートークンに注目するかを「マスク」で選びます。これまで主流だったマスキング手法に、上位k件の確率値を保持するTop-kと、累積確率がpを超えるまで上位から選ぶTop-pがあります。SpargeAttention2はまず、それぞれがどのような状況で破綻するかを理論的に分析しました。


注意重みが多くのトークンに均等に分散している場合(図2)、Top-kは固定数のトークンしか選ばないため、有用な情報の大半を切り捨ててしまいます。一方、ごく少数のトークンに注意が集中する「アテンションシンク」が生じると(図3)、Top-pは累積確率の閾値にすぐ達してしまい、他の有益なトークンが除外されます。どちらの手法も、特定の分布パターンに対して構造的な失敗モードを持つことが確認されました。
ハイブリッドマスキングと蒸留微調整
この分析をもとに、SpargeAttention2は2つの核心的な改良を提案します。
第1の改良がハイブリッドTop-k+Top-pマスキングです。Top-kで選ばれたトークンとTop-pで選ばれたトークンを和集合(Union)で統合するというシンプルなアプローチです。均等分布ではTop-pが適切に機能し、歪んだ分布ではTop-kが重要なトークンを確実に捕捉します。どちらの極端な状況でも片方の手法が補完するため、ハイブリッドは両ケースに対して頑健に動作します。
第2の改良がVelocity Distillation Loss(速度蒸留損失)です。SLA2のような先行する学習可能スパースアテンション研究でも微調整は行われていましたが、通常の拡散損失を用いると事前学習データと微調整データの分布差により品質が低下する問題がありました。論文では、フルアテンションモデルでさえ微調整だけで品質が落ちるケースを実証しています。


このVelocity Distillation Lossは、フリーズした教師モデル(フルアテンション)と学習中の学生モデル(スパースアテンション)が同一入力に対して同じ「速度予測」(ノイズ除去方向の推定値)を出すよう訓練します。入力データの分布に依存せず、モデル同士の出力を直接一致させる形で学習できるため、データ分布の不一致問題を根本から回避できる点が特徴です。微調整後は図5のようにアテンション分布がよりシャープになり、さらに高いスパース性を維持しながら品質を保てるようになります。
実験結果:速度と品質の両立

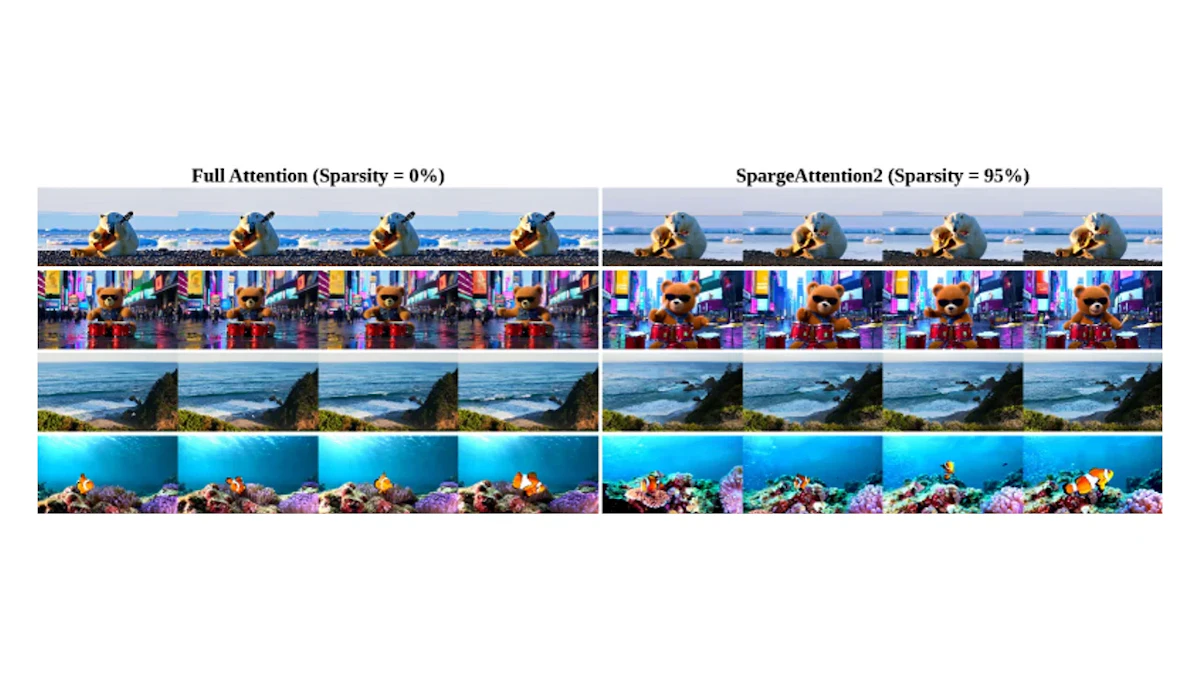
図1に示すように、95%という高いスパース性でもSpargeAttention2はフルアテンションと同等の動画品質を維持しています。定量評価では、Wan2.1-1.3B(480p)においてアテンション計算が97秒から6秒へと16.2倍の高速化を達成し、アテンションスパース性は95%に達しました。
Wan2.1-14B(720p)でのベースライン比較を以下に示します。
手法 | ImageQuality | AestheticQuality | VQA精度 | スパース性 | アテンション計算時間 |
|---|---|---|---|---|---|
フルアテンション(基準) | 68.01 | 64.66 | 86.15 | 0% | 2550秒 |
VSA | 64.03 | 63.37 | 77.63 | 90% | 651秒 |
VMoBA | 67.18 | 63.64 | 81.66 | 90% | 832秒 |
SLA | 64.43 | 61.89 | 76.90 | 95% | 285秒 |
SpargeAttention2 | 69.08 | 64.92 | 85.21 | 95% | 157秒 |
SpargeAttention2は、同じ95%スパース性のSLAと比べてもアテンション時間を285秒から157秒へ短縮し、品質指標はすべての評価軸でフルアテンションに最も近い値を示しました。アブレーション実験でも、Top-p単独(VQA 62.57)や訓練なし(VQA 20.40)に対して、提案手法(VQA 85.21)が大幅に優位であることが確認され、ハイブリッドマスキングと蒸留微調整それぞれの貢献が実証されています。
まとめと今後の展望
SpargeAttention2は、既存のTop-kとTop-pマスキングが持つ構造的な失敗パターンを理論的に解明し、ハイブリッド統合とVelocity Distillation Lossという2つの改良によって実用レベルのスパースアテンションを実現しました。コードはGitHub(thu-ml/SpargeAttn)で公開されており、Wan2.1など最新の拡散モデルに直接適用できます。
今後の課題としては、ビデオ以外のモーダルや異なるアーキテクチャへの拡張、動的なスパース性制御(シーンの複雑さに応じて閾値を動的に調整する仕組み)の実装などが考えられます。また、今回の実験はWan2.1モデルに限定されており、FLUXなど他のアーキテクチャでの有効性は今後の検証が待たれます。ビデオ生成の商用・研究応用において、スパースアテンション技術はさらに重要な役割を果たしていくことが期待されます。
論文情報: "SpargeAttention2: Trainable Sparse Attention via Hybrid Top-k+Top-p Masking and Distillation Fine-Tuning"(Jintao Zhang et al., 2026) arXiv:2602.13515, CC BY 4.0
本記事の図(図1〜図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


