 AI-Papers
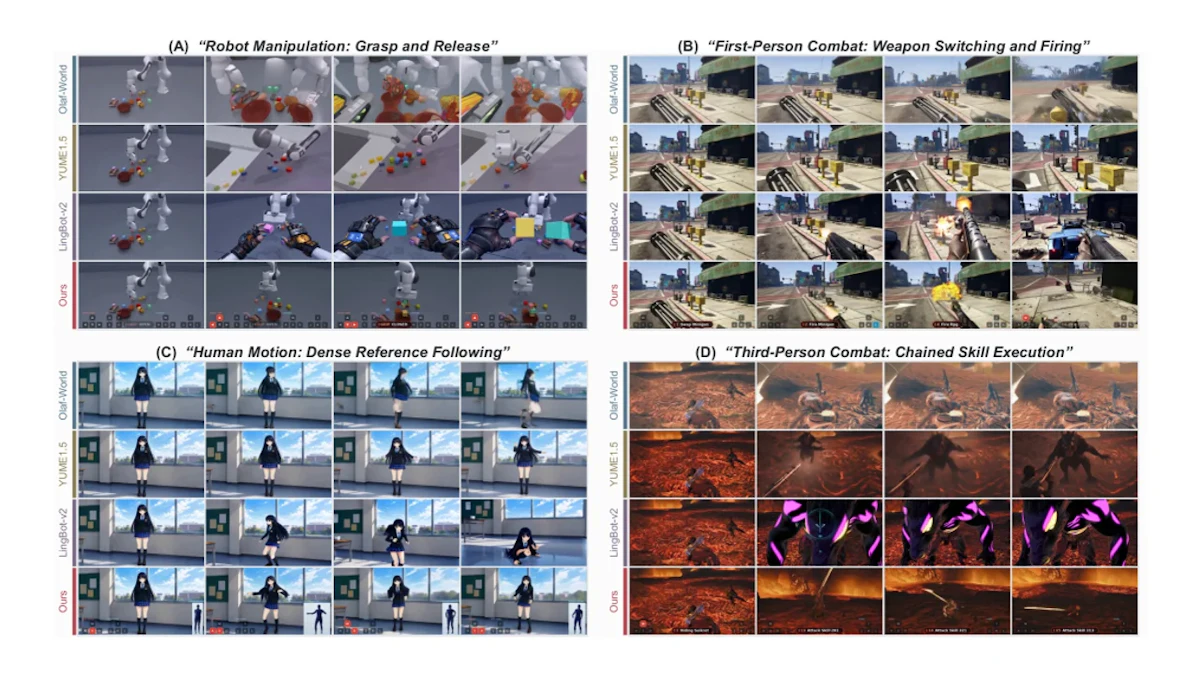
- 同じ動きを異なる見た目で二重に描く「シャドウペア」で、動作と見た目を自動的に切り離す新しい動画ワールドモデルです
- 動作ラベルや動き推定器、追加の微調整なしで、デモ動画をそのまま再利用できる「動作アセット」に変換します
- 人間動作でPSNR22.4(従来18.2)、ロボット操作で22.6(従来14.0)を達成し、長期生成でも平均86%の選好勝率を記録しました
研究の背景
動画ワールドモデルは、入力された操作や動きに応じて次の映像を予測する仕組みです。ゲームエンジンやロボットのシミュレータ、アニメ制作など幅広い応用が期待されています。しかし、映像を1フレーム単位で正確に制御することは難しい課題として残っていました。
これまでの手法には2つの傾向がありました。1つは動作をゆるく符号化する方法で、モデルが勝手に動きを補ってしまい、狙った通りの制御ができません。もう1つは特定の分野に特化した信号(骨格の座標やカメラの姿勢など)を必要とする方法で、分野をまたいだ汎用的な利用が困難でした。
ShadowDancer は、この表現の問題に正面から取り組んだ研究です。動画から「動き(dynamics)」と「見た目(appearance)」をきれいに分離することで、1つのデモ動画に含まれる動作を、まったく別の環境へ持ち込めるようにしました。
シャドウペアという発想
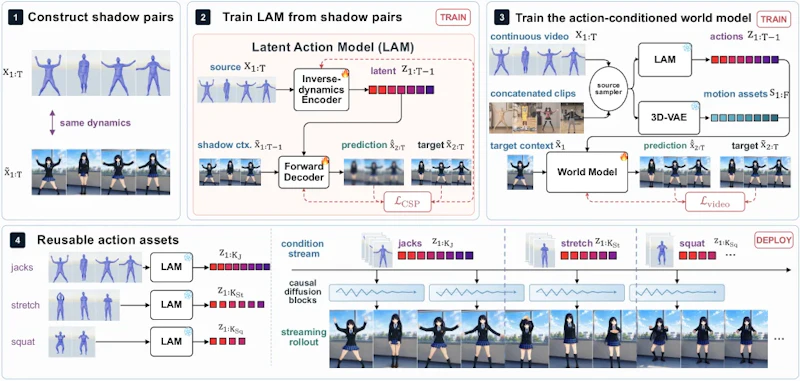
本手法の中心にあるのがシャドウペアという考え方です。同じ動きを、異なる見た目で2通りにレンダリングした動画のペアを指します。論文では映像をレンダリング関数として表し、R(d, c) と R(d, c̃) の2つを作ります。
ここで d は動きの軌跡、c はキャラクターや背景、照明といった見た目の要素です。2つの映像は動き d を完全に共有しつつ、見た目 c̃ だけを独立して差し替えます。こうすると、ペアの間で変化した要素(見た目)は「動きを表す情報ではない」と自動的に判断できるのです。
研究チームはこうしたペアを大量に生成する「シャドウライブラリ」を構築しました。アニメ制作ツール、オープンワールドゲーム、ロボットシミュレータ、そして実世界の動画(OpenX ロボットデータセットやインターネット動画)まで、多様な素材を集めています。
交差シャドウ予測とLAM
シャドウペアを活かして動きだけを抽出するのが、交差シャドウ予測(Cross-Shadow Prediction)という学習方法です。この学習で鍛えられるのが潜在動作モデル(Latent Action Model、LAM)と呼ばれる部品です。
LAM のエンコーダは、ある動画の連続する2フレームから潜在動作 z を取り出します。一方でデコーダは、ペアのもう一方の動画のフレームと、その z を組み合わせて次のフレームを予測します。見た目はもう一方の動画から与えられているため、z に見た目の情報を含めても役に立ちません。結果として z には動きの情報だけが残るという仕組みです。
通常の手法は同じ動画を自己再構成させますが、ShadowDancer はあえて見た目の違うペアで学習させます。この違いが、動きと見た目を分離する決め手になっています。実際、シャドウペアを使わない場合は潜在表現がうまく転送できず、ペアを加えるとPSNRが1.4ポイント改善したと報告されています。
動作をアセットとして再利用
学習が終わると、LAM と3D-VAE(動画を圧縮する部品)を固定したまま、動画拡散モデルを微調整してブロック因果ワールドモデルに仕立てます。土台には SkyReels-V2-1.3B という事前学習済みの動画拡散Transformerを使い、過去のフレームだけを参照する前向きの注意機構へ変換しています。動画を世界モデルとして扱う発想は、PhiZeroのような物理を離散化する世界モデルとも共通する流れにあります。
この設計により、デモ動画から取り出した動きは a = (z, s) という「動作アセット」として保存できます。z はLAMが取り出した潜在動作の系列、s は3D-VAE が捉えた動きの細部です。可変長のアセットをつなぎ合わせて条件として流し込むだけで、微調整も動作ラベルも不要のまま新しい動きを再生できます。新しい動作を1つ加えるコストは、固定済みエンコーダを1回通すだけです。
実験結果と性能比較
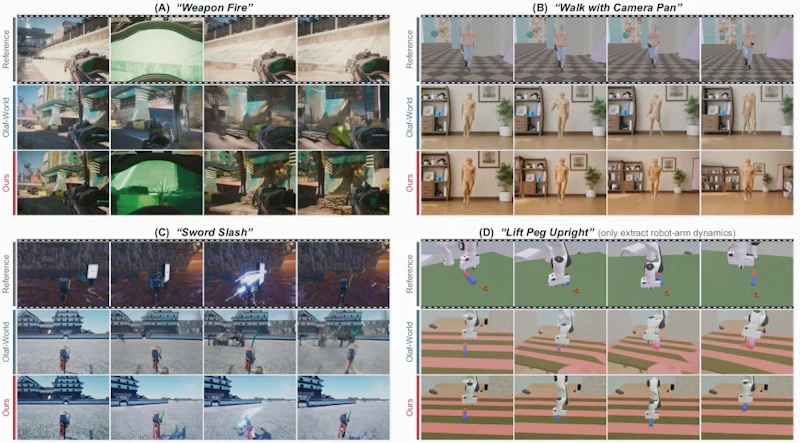
研究チームは、人間動作、ロボット操作、一人称視点、三人称視点、カメラ軌道という複数の分野で評価を行いました。素材には Blender で再描画したSMPL-X系列、ManiSkill シミュレータ、Unreal Engine のシーンなどを用いています。比較対象は自己再構成型の最先端手法である Olaf-World などです。
動作転送の品質を示すPSNR(数値が高いほど映像が正確)では、以下の通り大きな差が出ました。
分野 | ShadowDancer | 従来手法 |
|---|---|---|
人間動作 | 22.4 | 18.2 |
ロボット操作 | 22.6 | 14.0 |
一人称視点の戦闘 | 17.0 | 13.0 |
三人称視点アクション | 17.4 | 12.6 |
カメラ制御では軌道誤差(ATE)が0.005と、従来の0.072から大幅に減少しました。長時間にわたって動きを生成し続ける長期ロールアウトの評価でも、視覚言語モデルによる目隠し評価で動作制御94%、忠実度95%、長期の一貫性94%の勝率を記録しています。全体を通じた平均選好勝率は86%に達しました。
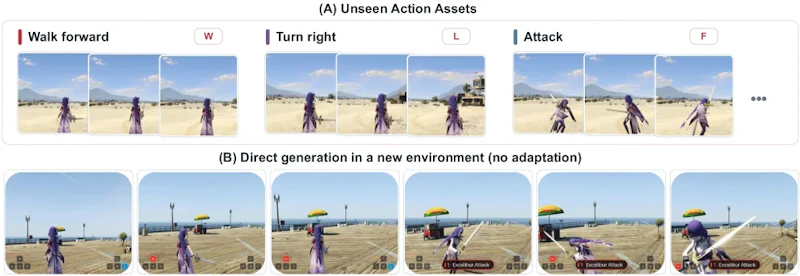
さらに、学習時に見たことのない改造キャラクターから記録した動作でも、別の環境で正しく再生できることが示されています。動きと見た目の分離が、単なる暗記ではなく汎用的に機能していることを裏付ける結果です。
まとめと今後の展望
ShadowDancer は、同じ動きを異なる見た目で描き分けるシャドウペアと、交差シャドウ予測を組み合わせることで、動作ラベルや動き推定器に頼らずに動きと見た目を分離しました。得られた動作アセットは、アニメ、ゲームエンジン、ロボットシミュレータを横断して再利用でき、動画ワールドモデルの汎用性を一段引き上げています。
一方で、シャドウペアを生成できるのは同じ動きを二重に描けるレンダラーが用意できる場合に限られます。実世界の動画は自己ペアとして扱う工夫で取り込んでいますが、多様な動きをどこまで安定して抽出できるかは今後の検証が必要でしょう。とはいえ、デモ動画を「動作アセット」として蓄積し組み合わせるという発想は、映像生成の制御性を高める実用的な方向性を示しています。
論文情報: "ShadowDancer: Teaching Video World Models Any Action by Learning Unified Dynamics Representations from a Video and Its Shadow"(Jin Cao, Zian Meng, Kaipeng Zhang, 2026) arXiv:2607.28362, CC BY 4.0
本記事の図(図2、図3、図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


