 AI-Papers
- 4秒の動画を256個の離散トークン「物理言語」に圧縮し、連続表現の44,800トークンから175分の1に削減
- VLM由来のReasonerで未来を推論してから拡散デコーダで描画する「reason then render」を提案
- Physics-IQ Verifiedなど4つの物理ベンチマークで最高スコアを達成し、ゼロショット動作転移も実現
研究の背景
世界モデルとは、現実世界がこの先どう変化するかを予測するAIの仕組みです。ロボットが物を押したらどう動くか、コップを傾けたら水がどうこぼれるかといった物理的な結果を先読みできれば、行動計画や動画生成に幅広く応用できます。
従来の動画世界モデルの多くは、ピクセル空間で直接、次の映像を予測してきました。しかしこの方式では、物体の衝突や重力、連鎖反応といった物理法則が高次元の映像予測器の内部に埋もれてしまい、明示的な推論の対象になりません。その結果、見た目はもっともらしくても物理的にはあり得ない映像が生成されやすいという課題がありました。
今回紹介するPhiZeroは、この問題に「物理を推論の対象として切り出す」という発想で取り組んだ研究です。動画から物理的な変化だけを抜き出したコンパクトな離散表現を学び、その表現の上で未来を考えてから映像に描き起こします。
物理言語という発想
PhiZeroの中心にあるのが、動画の状態変化を圧縮した離散表現「物理言語(Physical Language)」です。連続する2つの映像フレーム間で「何がどう変わったか」という遷移だけを取り出し、それを少数の記号列に置き換えます。
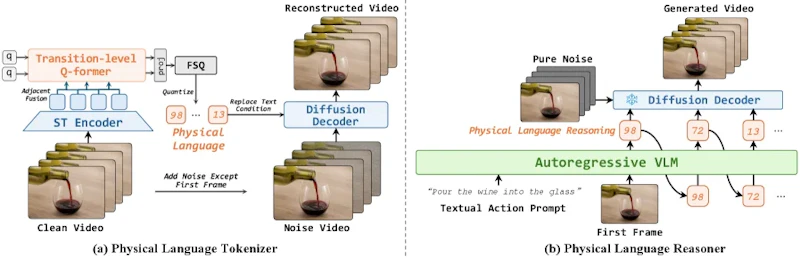
圧縮の担い手が「Physical Language Tokenizer」です。隣り合う潜在状態の遷移ごとに32個のクエリを用いる遷移レベルのQ-Former(重要な情報を絞り込む注意機構)で特徴を抽出し、FSQと呼ばれる手法で離散トークンに変換します。この工夫により、33フレームの4秒動画を256個の離散トークンで表現できるようになりました。
連続的なVAE表現では同じ動画に44,800トークンが必要ですから、実に175分の1という大幅な圧縮です。トークン化した物理言語は、Wan2.2のVAEエンコーダと5B規模の拡散デコーダによって、最初のフレームを手がかりに元の動画へ復元されます。
推論してから描く手法
PhiZeroのもう1つの柱が「reason then render(推論してから描画する)」という2段階の枠組みです。まず未来を物理言語で推論し、その結果を拡散デコーダが映像へ変換します。
推論を担う「Physical Language Reasoner」は、Qwen3-VL-4Bを初期値とする自己回帰型のVLM(視覚言語モデル)です。最初のフレーム画像と「物を押す」といったテキストの行動意図を受け取り、次に起こる状態遷移を物理言語の記号列として予測します。この記号の語彙は継続事前学習と動きの豊富なデータでの微調整を通じて25,000語まで拡張されています。
物理を言語のような記号列として扱うことで、世界の変化そのものが明示的な推論の対象になります。ピクセルを直接予測する方式と違い、物理法則に沿った一貫性を保ちやすくなる点が大きな特徴です。関連して、コードを思考の道具に使って物理的に一貫した動画を生成するVideoCoCoの取り組みも参考になります。
学習データの構築
PhiZeroは大量のインターネット動画から物理言語を学びます。データは段階的なフィルタリングで絞り込まれ、用途ごとに使い分けられます。
- 50,000時間の実世界動画と1,000時間のシミュレーション動画を収集
- トークナイザの事前学習には10,000時間を使用
- トークナイザの微調整とReasonerの事前学習には500万本の4秒クリップを使用
- Reasonerの微調整には動きの豊富な100万本のクリップを厳選
ラベル付けを人手に頼らない自己教師あり学習で物理言語を獲得するため、こうした大規模な動画プールを効率よく活用できる設計になっています。
実験結果
PhiZeroは物理的な妥当性を測る4つの主要ベンチマークで、いずれも既存手法を上回るスコアを記録しました。物体の変位や重力による変形、連鎖反応、影の変化といった物理的な結果を、より正確に捉えられることが確認されています。
ベンチマーク | PhiZero | 比較手法 |
|---|---|---|
Physics-IQ Verified | 41.2 | 39.5(Cosmos3-Super) |
PhyGround 物理スコア | 3.01 | 2.90(Wan2.2-14B) |
WorldModelBench 物理整合性 | 4.88 | 4.51(従来手法) |
IntPhys2 総合 | 56.34 | 55.63(Gemini-2.5 Flash) |
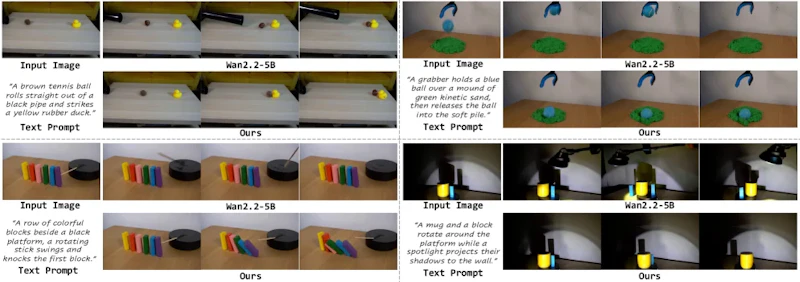
下の図は、ベースラインであるWan2.2-5Bとの比較です。衝突による物体の移動や重力による変形など、相互作用の物理的な帰結をPhiZeroがより忠実に再現できている様子が見て取れます。
動作転移とsim-to-real
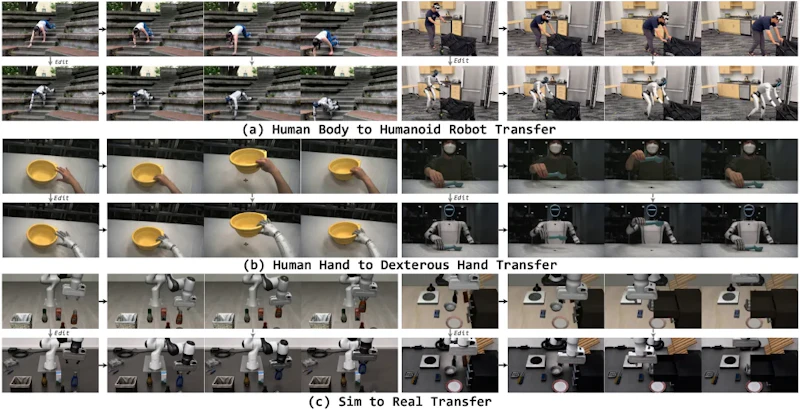
物理言語が見た目から独立して「動きそのもの」を表現している点も重要な成果です。ある動画の状態遷移を物理言語に符号化し、見た目の異なる別の最初のフレームで同じ記号列を復元すると、元の動きを保ったまま外観だけを差し替えた動画が得られます。
この性質を使うと、追加学習なしのゼロショットで動作を転移できます。人間の動きをG1ヒューマノイドへ移す身体間転移や、シミュレーション映像を現実世界の映像へ変換するsim-to-real転移が実現しています。ロボットの学習データ不足を補う手段としても有望です。
まとめと今後の展望
PhiZeroは、動画を256トークンの離散「物理言語」に圧縮し、VLMで未来を推論してから拡散デコーダで描画する世界モデルです。物理ダイナミクスを明示的な推論対象に据えたことで、複数の物理ベンチマークで最高水準の性能と、ゼロショット動作転移という応用力を両立しました。
一方で、物理言語がどこまで細かい物理現象を表現しきれるか、より長い時間スケールの予測でも一貫性を保てるかといった点は、今後の検証課題として残ります。256トークンという強い圧縮は効率と汎化に効く反面、微妙な質感や高速な動きの再現には限界がある可能性も考えられます。
とはいえ、映像予測を「物理の推論」と「描画」に分けるという設計思想は、ロボティクスや動画生成の両分野に新しい選択肢を示すものです。世界モデルの研究がピクセル一辺倒から、より構造化された表現へ広がっていく流れを象徴する成果と言えるでしょう。
論文情報: "PhiZero: A World Model Built Around Physical Language"(Shuyao Shang et al., 2026) arXiv:2607.28624
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


