 AI-Papers
- MMSI-BenchでGPT-5.4を4.5ポイント、Gemini 3 Proを1.2ポイント上回る空間推論スコアを達成
- 2Dから3Dへの階層的変換ツールと二重メモリ機構により、学習不要で既存のVLMを強化できる汎用設計
- S-300K(約29万サンプル)でファインチューニングした8BモデルがGPT-5.4・Gemini 3と同等性能を実現
研究の背景
視覚言語モデル(VLM: Visual Language Model)は画像の内容理解において目覚ましい成果を上げてきました。しかし「右から2番目の棚に何があるか」「カメラはどちらに移動したか」のような3D空間の関係を問うタスクになると、精度が大幅に低下することが知られています。
この弱点の根本原因は、VLMが一枚の画像から単一ステップで回答する「静的・無状態」の推論設計にあります。現実世界の空間理解には、複数の視点やフレームをまたいで証拠を積み上げ、3D構造を段階的に把握する連続的なプロセスが必要です。既存のVLMもツール拡張エージェントも、この継続的な状態管理を行う仕組みを備えていませんでした。
S-Agentの設計思想
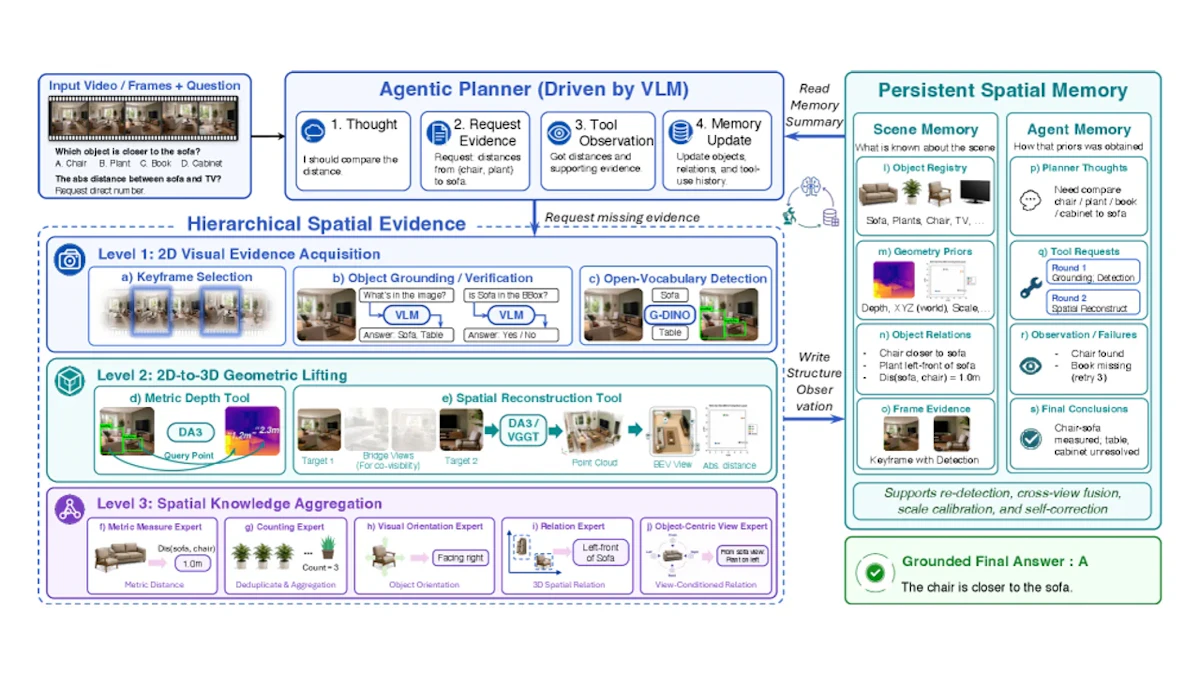
S-Agentは「VLMを直接答えを出す機械ではなく、ツールを操る計画係として使う」という発想を採用しています。VLMはどの証拠が必要かを決める役割を担い、証拠の収集と変換は専用の空間ツール群が担当します。
このパイプラインを構成する要素は3つです。階層的空間ツールが2D視覚情報を3D幾何証拠へ変換し、二重メモリ機構が推論状態を蓄積します。VLMプランナーはこれらを統括して最終的な空間的判断を下します。
空間ツールの3段階階層
空間ツールは3層の階層構造をとります。第1層は物体検出・深度推定・動画フレーム選択など、2D画像からクエリに関連する視覚的手がかりを抽出する層です。第2層ではメトリック深度ツールが、この2D情報を3D座標・カメラポーズ・鳥瞰図などの幾何証拠へ変換します。
第3層には5種類の専門家モジュールが置かれています。距離計測・物体計数・視覚的方向・相対位置・物体中心ビューをそれぞれ担当し、高レベルな空間知識として集約する層です。この段階的な変換により、単眼画像に含まれる奥行き情報が定量的な3D証拠へと引き上げられます。
二重メモリによる状態管理
空間推論では複数フレームにまたがって証拠を統合する必要があります。S-Agentはこれを2種類のメモリで解決しています。
シーン記憶は各フレームで検出した物体のテキストエイリアスや3D座標・幾何属性を保存する仕組みです。異なるフレーム間で同一物体のIDを維持しながら、空間的事実を蓄積できます。
エージェント記憶はプランナーの中間的な思考・ツール呼び出し・観察結果・中間結論を記録し、推論の重複を防ぎながら文脈を引き継ぎます。
実験結果
S-Agentは2つの空間推論ベンチマークで評価されました。MMSI-Benchでは平均スコア46.4%を達成し、GPT-5.4を4.5ポイント、Gemini 3 Proを1.2ポイント上回りました。ViewSpatial-Benchでは平均60.0%を記録し、GPT-5.4を14.4ポイント上回っています。主なスコアは次の表のとおりです。
評価項目 | S-Agentのスコア |
|---|---|
MMSI-Bench 平均 | 46.4% |
MMSI-Bench カメラ動き | 46.0% |
MMSI-Bench 物体動き | 48.7% |
MMSI-Bench 多段階推論 | 44.4% |
ViewSpatial-Bench 平均 | 60.0% |
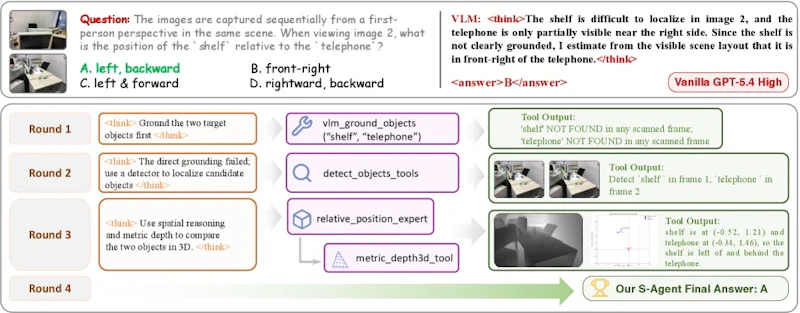
カメラ動きや物体動き、多段階推論といった、複数フレームの証拠を統合する必要がある項目での優位が目立ちます。
また、身体的AIの事前学習と並んで空間理解の強化が注目されるロボティクス領域でも応用が期待されており、S-Agentはトレーニングなしにその能力を引き出せる点で異なる方向性を示しています。
S-300Kデータセット
S-300KはSenseNova-SI-800Kから10万件の質問をサンプリングし、品質フィルタリングで5万1,596件の空間推論軌跡を保持して構築されました。最終回答・ターン単位・専門家ツール呼び出しの3種類を合計すると約29万2,000件のSFTサンプルを収録しています。
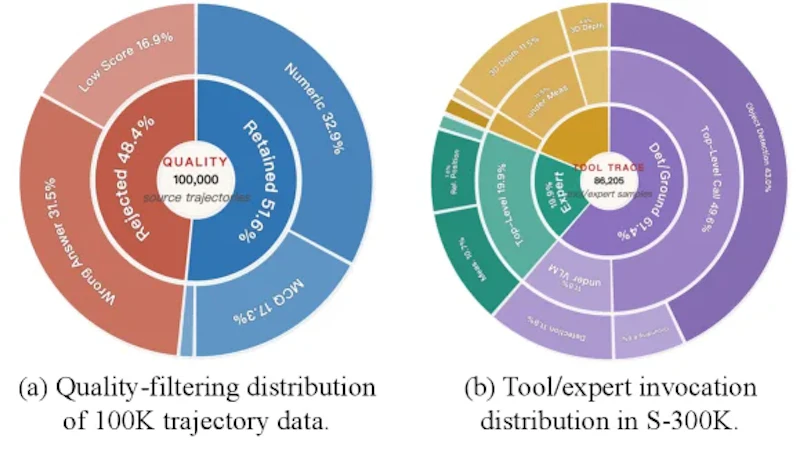
このデータセットでQwen3-VL-8BをファインチューニングしたS-Agent-8Bは、同規模のベースラインを大幅に上回るだけでなく、GPT-5.4やGemini 3と同水準の性能を達成しました。
まとめと今後の展望
S-Agentは、ツールと記憶の組み合わせにより小型VLMでも高度な空間推論が可能であることを実証しています。これはモデルの大規模化だけが性能向上の手段ではないといえるでしょう。
学習不要で既存VLMを強化できる設計は、ロボティクスやAR/VRなど3D理解が求められる応用領域への展開も見込まれます。一方で現在の評価はベンチマーク上に留まっており、実際のロボット制御や屋外環境への適用にはさらなる検証が必要です。空間ツールの拡充やより多様なシーンへの対応が、今後の課題となるでしょう。
論文情報: "S-Agent: Spatial Tool-Use Elicits Reasoning for Spatial Intelligence"(Yalun Dai et al., 2026) arXiv:2606.20515, CC BY 4.0
本記事の図(図2〜図4)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


