 AI-Papers
- MicrosoftとHugging Faceが2026年10月3日、エージェント評価基盤ThinkingBoxを公開。応答文ではなくデータベースの終了状態を検証する
- 507タスクを各20回繰り返し、12モデル分の121,680試行で分析。79,853件が検証に失敗し、うち67.24%は正常終了していた
- Pass@1はClaude Opus 5.5が67.16%で首位、20回全成功は241タスク(47.53%)にとどまる
DB状態で成否を判定
MicrosoftとHugging Faceは2026年10月3日、Hugging Face公式ブログでエージェント評価基盤ThinkingBoxを公開しました。開発にはEnderis AIのTuhin Kundu氏、Tommy Guy氏、Hugging FaceのSergio Paniego氏らが関わっています。
従来のエージェントベンチマークは、最終応答の文章や正しい形式のツール呼び出しが出たかどうかで採点するものが多くありました。ThinkingBoxはこの前提を変え、業務システムのバックエンドに相当するデータベースが実際にどう変化したかを検証します。
タスクは小売98件、自動車保険100件、旅行104件、ネオバンク104件、コンサルティング101件の計507件で、いずれも状態を伴う業務ワークフローです。うち477タスクはデータベース状態だけで採点し、残る30タスクには応答内容を見る二値のルーブリックを追加しています。公開ベンチマークのタスクはすべて合成的に再構成されたもので、実在顧客のデータは含まれません。
20回試行で再現性を測る
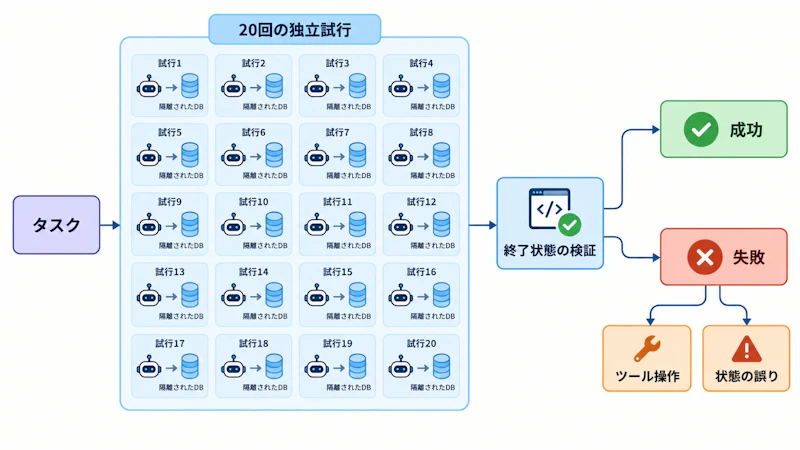
図1に示すように、各試行には初期化済みの独立したバックエンドが割り当てられ、試行間でデータベースを共有しません。終了時には決定的な検証器が、必要な変更が行われたか、意図しない副作用が残っていないか、フィールドの値が誤っていないかを個別に判定します。
同一タスクを20回繰り返す設計の狙いは、能力と信頼性を切り分けることにあります。ブログは「1回うまくいけばモデルがその作業をこなせることは分かるが、次も同じようにやるかは分からない」と述べ、単発のPass@1では見えない差を可視化しようとしています。
実際、Claude Opus 5.5は単発成功率の71%を20回試行でも保った一方、GLM-5.1は8%しか残りませんでした。再現性の低さはAIエージェントの再現性をめぐる他の研究でも指摘されており、評価軸として定着しつつあります。
失敗の8割はツール操作
共通セットでの分析は、507タスク×20回×12モデルの121,680試行を対象に行われました。このうち79,853件が実行可能な検証に失敗し、さらにその67.24%は異常終了せず、状態を変えるツールを呼び出し、最終的なツールエラーも報告していませんでした。表面上は成功に見える挙動が大量に含まれていたことになります。
失敗の内訳はツール操作の誤りが79.9%、状態の更新先や値の誤りが10.3%、ユーザー要求を解決しきれていないものが7.0%、状態を変える操作を一切行わなかったものが2.9%でした。推論の誤りよりも、ツールを正しく使い切る工程に課題が集中している構図です。
モデル別の成績
18モデルが評価され、Pass@1と20回全成功(Observed 20/20)の上位は次のとおりです。コストは後述の1タスクあたり指標です。
モデル | Pass@1 | 20/20成功 | 信頼可能1タスクの費用 |
|---|---|---|---|
Claude Opus 5.5 | 67.16% | 241件(47.53%) | 7.80ドル |
Claude Opus 5 | 66.50% | 241件(47.53%) | 13.30ドル |
GPT-5.4 | 65.36% | 128件(25.25%) | 6.80ドル |
GPT-5.6 Sol | 61.91% | 82件(16.17%) | 非公表 |
Kimi-K3 | 57.37% | 68件(13.41%) | 非公表 |
Claude Opus 5.5とClaude Opus 5の20/20成功数は公開値で同じ241件です。オープンウェイトのKimi-K3はPass@20で93.89%、小売分野のPass@1で82.24%と広さでは一部の商用モデルを上回りましたが、20/20成功は13.41%と一貫性で大きく劣りました。Claude Opus 5はその逆で、広さは譲っても一貫して解けるタスクがKimi-K3より173件多い結果です。
一貫性を費用で測る
ThinkingBoxは「信頼可能な1タスクあたりの費用」という指標も導入しました。507タスクを20回通しで実行した推定費用を、20回すべて成功したタスク数で割る計算です。GPT-5.4は20回分で869.80ドルを要し、全回成功が128タスクだったため6.80ドルとなります。
成功1回あたりの費用で測ると、たまたま当たった回も加点されます。全回成功を分母に置くこの指標は、本番で繰り返し実行する前提に近い見方を与えます。
公開範囲とライセンス
コード、データ、実行環境はそれぞれ別のライセンスで公開されています。
- フレームワーク本体は
github.com/microsoft/thinkingboxで公開 - 環境はMITライセンス、ベンチマークデータはCDLA-Permissive-2.0
- 実行環境のOpenEnvはBSD-3-Clauseで
github.com/huggingface/OpenEnvに所収 - データセットはHugging Faceの
microsoft/ThinkingBox-Benchから取得可能
検証がデータベース状態という外形的な事実に依拠するため、採点に別のモデルを使う方式より結果の再現がしやすい設計です。エージェントを業務システムに接続する段階では、Pass@1よりも20回分の挙動の揃い方が導入判断に直結します。


