 AI-Papers
- Allen Institute for AI(Ai2)が、研究質問と文献抜粋から引用付きレポートを生成する8Bのオープンウェイトモデル「AstaBrief」を公開
- Qwen3-8B をファインチューニングし、1回の生成でレポート全体を書き切る設計。Claude ベースの Thinking モードの平均178.5秒に対し、Fast モードは平均51.1秒
- SQABench-CS2 と DeepScholarBench で引用精度・内容品質ともに競合水準。学習データとチェックポイントも併せて公開された
AstaBriefとは
Allen Institute for AI(Ai2)が、科学文献をもとに引用付きのレポートを生成する専用モデル AstaBrief をオープンウェイトで公開しました。研究質問と検索で集めた文献の抜粋を入力として受け取り、主張ごとに出典を添えた統合レポートを出力します。
ベースモデルは Qwen3-8B です。モデル本体は Hugging Face の allenai/AstaBrief_8B で配布され、学習用データセットとチェックポイントも AstaBrief コレクションとして併せて公開されています。8B という規模のため、ファイアウォール内の研究機関のインフラや手元の環境で動かせる点が実用上の特徴です。
Ai2 の研究支援エージェント Asta では、この8Bモデルが「Fast モード」として組み込まれ、Claude を使う「Thinking モード」と並んで選択できる構成になっています。小規模なオープンモデルで研究支援タスクを成立させる方向性は、ZGCM-1とは?7Bで4.2倍速い学習と全レシピ公開を実現した基盤モデルで紹介した流れとも重なります。
一括生成で処理時間を短縮
既存の文献統合システムは、抜粋の要約、トピックごとのクラスタリング、セクション単位の執筆といった中間工程を順に実行するパイプライン型が主流でした。AstaBrief はこれらの中間ステップを省き、レポート全体を一度の生成で書き切ります。
この設計が処理時間に直結しています。Claude ベースの Thinking モードがレポート1本あたり平均178.5秒を要するのに対し、Fast モードは平均51.1秒で、約3.5倍の高速化となります。研究者が質問を少しずつ変えながら試行を繰り返す使い方では、この待ち時間の差が作業の進め方そのものに影響します。
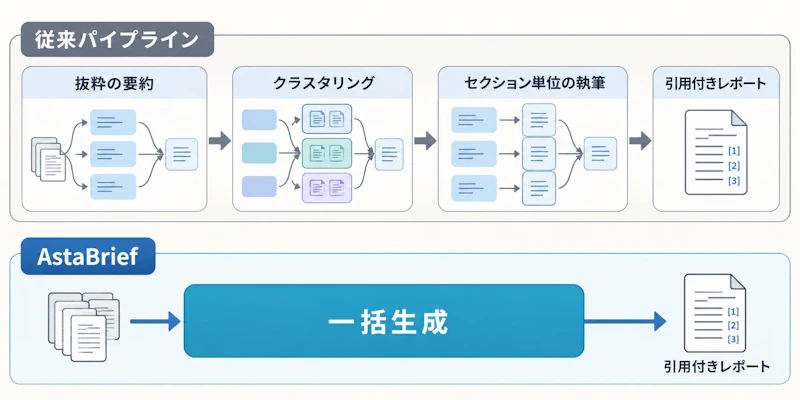
図1のように、従来型では各工程がモデル呼び出しを重ねるため、工程数がそのまま遅延とコストに積み上がります。AstaBrief は工程を折りたたむ代わりに、引用の整合性を学習段階で担保する設計を採っています。
学習データの作り方
教師ありファインチューニング(SFT)には、Asta に実際に投稿された9万件のユーザークエリをフィルタリングし、そこから生成した4.7万件の学習例を使っています。キーワード検索のような単純な問い合わせではなく、前提条件や制約の多い実際の研究上の質問が中心です。
さらに約6000組の選好ペアを使った DPO(Direct Preference Optimization、人間の好みに合う出力を直接学習させる手法)を適用しました。選好ペアの生成には Claude 3.5 Sonnet、Claude 3.7 Sonnet、o3、o4-mini、DeepSeek-V3、DeepSeek-R1 という複数のモデルを使い、GPT-4.1 と DeepSeek-R1 の2つの判定モデルが一致した場合のみ採用しています。
開発側が最も効果が大きかったと挙げているのは、引用密度にもとづく学習例のフィルタリングです。主張に対して一貫して出典を付けているレポートだけを残す処理が性能向上に寄与しました。一方で、より複雑なフィルタリングを重ねても必ずしも良くはならず、量より質が効くという結果になっています。
評価結果と利用状況
評価は4つの指標で行われています。内容の網羅性を見る Rubric Score、各段落が質問に関連しているかを見る Answer Precision、引用が主張を裏づけているかを見る Citation Precision、主張が引用で十分に支えられているかを見る Citation Recall です。
計算機科学の200問からなる SQABench-CS2 と、arXiv の論文を題材にした63問の DeepScholarBench で測定したところ、Claude を使うパイプラインや DR Tulu と引用・内容品質の両面で同水準の結果を示しました。研究者3名が14〜15問ずつ評価した人手調査では、引用の正確さについて2名が AstaBrief を他の選択肢より良いと判断しています。
実利用のデータも公開されています。Fast モードを試した374名のうち29.1%が2日以上使い、1人あたり平均3.67件のレポートスレッドを生成しました。23%が Fast モードのみを使い、18%が2つのモードを使い分けています。肯定的フィードバックの比率は84.2%で、Thinking モードの85.2%とほぼ並びました。
項目 | Fast モード(AstaBrief 8B) | Thinking モード(Claude ベース) |
|---|---|---|
レポート1本の平均生成時間 | 51.1秒 | 178.5秒 |
肯定的フィードバック率 | 84.2% | 85.2% |
限界と今後の課題
開発側は、今回の比較が2025年時点のフロンティアモデルを前提にしたものであり、結果は現時点でのモデル間の優劣ではなく「特定の学習方法とシステム設計の選択に関する証拠」として読むべきだと明記しています。フロンティアモデルの更新が速いため、相対評価は短期間で変わり得るという前提です。
残された課題として挙げられているのは、根拠の適用範囲が保たれるかの評価です。特定のサンプルに限った知見が、レポート上で広い一般論に読み替えられてしまう現象を検出する仕組みが必要だとしています。今後の方向性としては、より細かい粒度の選好学習、RAG と強化学習を組み合わせた手法の強化、複数ターン・複数ツールへの対応が示されました。


