 AI-Papers
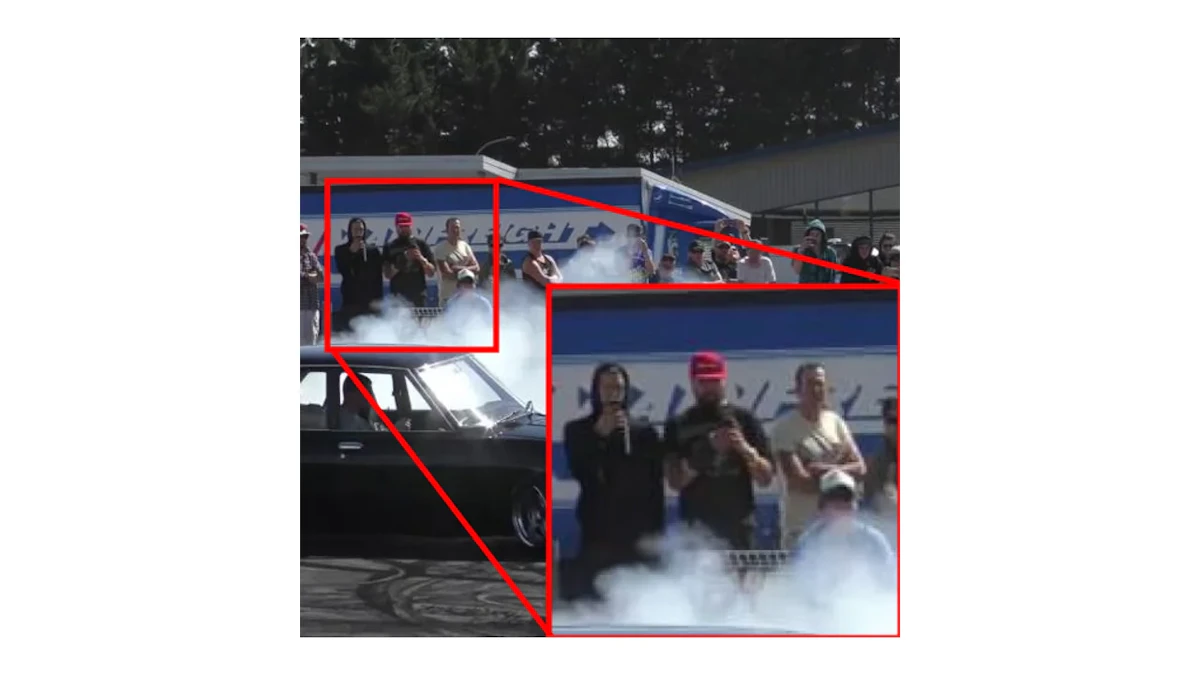
- Reference Attention機構により参照画像をトークン化してデコーダの各段階に注入。ファインチューニング不要でWan 2.1とVideoVAE+の両方に対応できる
- Inter4K・WebVidベンチマークでPSNRが最大+2.1dB向上し、VBench動画生成評価でも12次元中11次元で改善を達成
- 画像→動画生成・スタイル転送・動画編集に適用可能で、プラグイン設計により既存の動画生成パイプラインへの組み込みが容易
研究の背景と課題
近年の動画生成モデルは潜在拡散モデル(Latent Diffusion Model)を基盤としており、ノイズを除去するデノイザーには、テキストプロンプトや参照画像といった豊富な条件情報が与えられます。一方で、デノイザーが出力した潜在表現を実際の映像フレームへ変換するデコーダは、こうした条件付けを一切受け取っていません。
研究チームはこの偏りを「アーキテクチャ的非対称性(architectural asymmetry)」と呼び、デコーダにも同等の条件付けが必要だと指摘します。条件付けのないデコーダは、テキストや顔、細かな模様といった高周波成分(画像の細部にあたる情報)を失いやすく、フレーム間で見た目の一貫性が崩れます。RefDecoderは、この課題に取り組んだ研究です。
RefDecoderの設計と仕組み
RefDecoderは、動画VAE(映像を圧縮した潜在表現に変換し、元の映像へ戻すモデル)のデコーダに、参照フレームのシグナルを直接注入する手法です。既存のデコーダ重みはそのまま維持し、新たに追加した軽量なコンポーネントで参照情報を各アップサンプリング段階へ流し込みます。
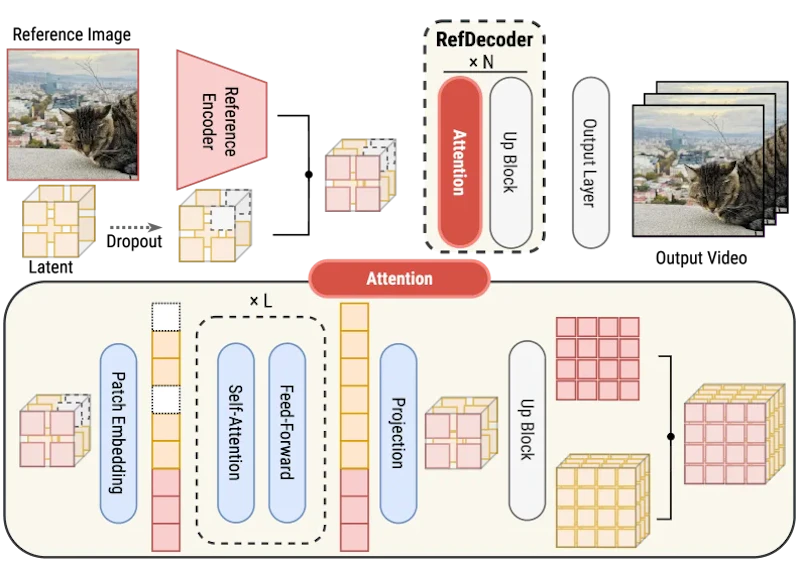
図2に示すとおり、手法は3つのコンポーネントで成り立っています。
- 軽量な畳み込みエンコーダが、参照画像を高次元のトークンに変換する
- デコーダの各アップサンプリング段階で、参照トークンと映像の潜在トークンを時間軸方向に結合し、共有Transformerブロックで処理する
- 処理後に両者を分離し、それぞれを個別にアップサンプリングする
この構成により、既存のデコーダ重みとの互換性を保ったまま、参照情報を各段階で活用できます。
学習では、映像の潜在トークンを最大70%の確率でゼロに置き換える「ドロップアウト」を使います。デコーダが参照シグナルに頼る度合いが強まり、再構成の品質が上がる狙いです。あわせて2段階のカリキュラム学習を採用し、まず基礎的な再構成能力を身につけさせてから、高解像度で動きの大きいシーンへ段階的に難易度を上げていきます。
実験結果と性能比較
評価にはInter4KとWebVidという2つのベンチマークを使用しています。Inter4KはUltra HD映像を含む高解像度データセット、WebVidは多様なシーンを含む大規模動画データセットです。評価指標はPSNR(ピーク信号対雑音比、値が高いほど画質が良い)、SSIM(構造的類似度、画像の構造の近さを測る指標で値が高いほど良い)、LPIPS(知覚的画質距離、人の見え方に近い尺度で値が低いほど良い)の3種類でした。
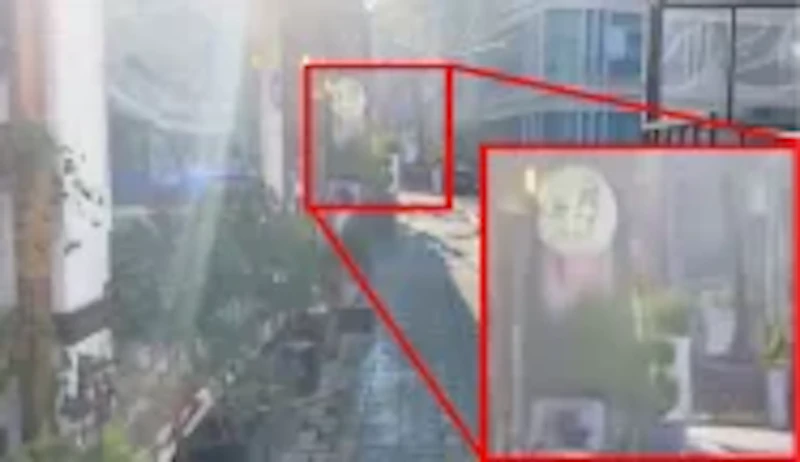
図3は、Wan 2.1とVideoVAE+という2つのバックボーン(土台となるモデル)での再構成結果を並べたもので、テキストや人物、構造的な模様といった細部の再現に差が出ています。数値の評価では、再構成品質に加えて動画生成の総合ベンチマークであるVBench(被写体一貫性・背景一貫性など12の視点から動画生成品質を評価する指標)も測っており、主な結果は次の表のとおりです。
評価項目 | RefDecoder | 元のデコーダ |
|---|---|---|
PSNR(Inter4K、Wan 2.1) | 34.9 | 33.7 |
VBench 総合スコア | 88.2 | 87.9 |
Wan 2.1をバックボーンとしてInter4Kで評価した場合、PSNRの伸びは+1.2dBにあたります。VBenchでは全12次元中11次元で改善が確認され、特に被写体の一貫性と背景の一貫性で差が出ました。VideoVAE+バックボーンではWebVidで最大+2.1dBのPSNR向上が得られ、LPIPSも全ての設定でほぼ改善しています。
構成要素を入れ替えて効果を確かめるアブレーション実験では、Transformerブロック数を3個から10個に増やすと、Inter4KのPSNRが34.3から34.9dBへ段階的に向上しました。計算資源に応じて品質との釣り合いを調整できる設計です。
多様なタスクへの応用
RefDecoderはファインチューニング不要でプラグイン的に利用できるため、動画生成以外のタスクにも適用できます。動画生成パイプラインの改善研究としては、拡散プロセス自体を効率化するAnyFlowのような手法も存在しており、RefDecoderはデコーダ側からアプローチする補完的な解決策にあたります。
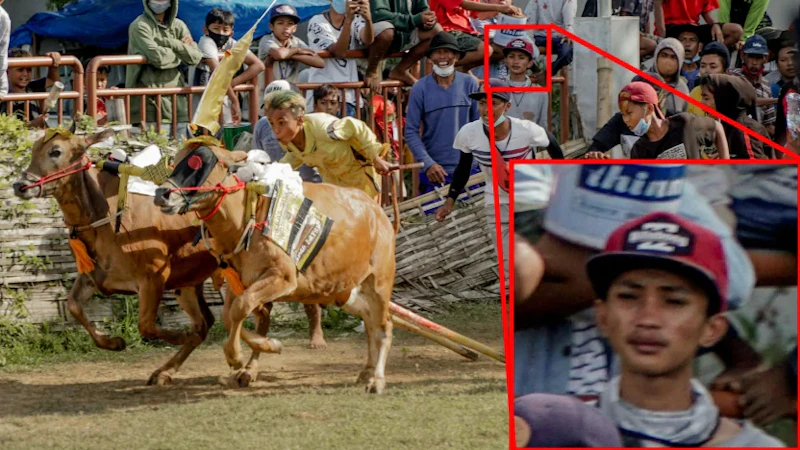
図4は、同じ参照入力から生成した動画を手法ごとに並べたもので、シーンの構造を保ったまま時間的に一貫したフレームが得られています。図5はスタイル転送の結果で、参照画像のスタイルに従いながら、入力画像の構造的内容が残っている様子が確認できます。
スタイル転送では、参照画像のスタイルを保ちながら入力映像の構造を維持した変換が可能です。動画編集タスクでは、LoRA-Editなどの手法で問題となる「非編集領域の劣化」を、参照フレームから忠実に復元することで抑えられました。画像から動画を生成するI2Vタスクでも参照フレームとの構造的整合性が高まり、より自然なモーションが得られます。
まとめと今後の展望
RefDecoderは、潜在拡散モデルでデコーダに条件付けがないという点を問題として取り上げ、Reference Attention機構による参照フレーム注入という解決策を示した研究です。ファインチューニングが要らない設計のため、Wan 2.1やVideoVAE+をはじめとする既存の動画生成パイプラインへの導入も現実的な選択肢になります。
課題も残っています。現状では単一の参照フレームのみに対応しており、複数参照への拡張、参照エンコーダのさらなる強化、より長尺の映像への対応などが今後の論点として挙げられました。ベースモデルが持つバイアスをそのまま引き継ぐ点には注意が必要ですが、デコーダという切り口から動画生成品質を高める手法として、応用できる範囲は広いでしょう。
論文情報: "RefDecoder: Enhancing Visual Generation with Conditional Video Decoding"(Xiang Fan et al., 2026) arXiv:2605.15196, CC BY-SA 4.0
本記事の図(図2〜図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


