 AI-Papers
- 実際のOSやブラウザを動かさず、画像生成モデルでスクリーンショットを連続編集してGUI操作軌跡を合成するAutoGUIWorldが提案されました
- Ubuntu、Windows、macOS、Chromeにまたがる79,266件の空間注釈付き学習サンプルを生成し、座標つきの教師データとして利用できます
- Qwen3.5-35B-A3Bのファインチューニングで OSWorld 33.0→40.8%、ScienceBoard 14.0→32.2% と改善した一方、行動と画像の不整合が残る点も報告されています
研究の背景
画面を見てマウスやキーボードを操作するGUIエージェントを学習させるには、「ある状態で、ある操作をしたら、画面がこう変わった」という一連の軌跡データが必要です。モデルはこの軌跡から、ソフトウェアが操作にどう反応し、状態をどう保持し、複数ステップの作業がどうつながるかを学びます。
ところが、この軌跡を集める作業が最大の障壁になっています。実際のOSや業務アプリを仮想マシン上に用意し、ライセンスを揃え、アプリごとに初期状態を作り、人間またはスクリプトが操作してスクリーンショットを撮り続ける必要があります。扱うアプリやWebサイトを広げようとするほど、環境構築と運用のコストが膨らみます。
香港科技大学(広州)などの研究チームが発表したAutoGUIWorldは、この前提を切り替えました。環境を立てる代わりに、画像生成モデルを「GUIの世界モデル」として使い、次の画面を描かせるという発想です。クリックやキー入力の結果として現れる画面を、実行ではなく生成で得ます。
提案手法の全体像
図1に全体の流れが示されています。処理は構造化された仕様のサンプリングから始まります。プラットフォームや画面解像度、行動空間を定めるOS基盤、テーマや配色、タイポグラフィといった外観、開いているウィンドウやレイアウト、表示内容といった初期GUI状態の3要素を、それぞれ指定された空間から選び出します。
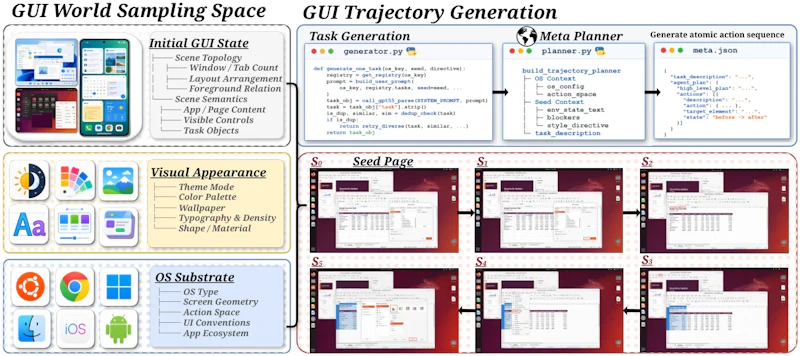
選ばれた構成は視覚的な記述文に変換され、画像生成モデルのImage2が最初のスクリーンショット(シード画面)を描きます。このとき、どの要素が見えているか、どんなスタイルかというメタデータも同時に記録されます。
タスク指示は、シード画面を固定した後に生成される点が工夫されています。先に指示を決めてから画面を作ると、画面に存在しない要素を操作しろという矛盾した指示が生まれがちです。画面を先に確定させることで、指示は見えている要素と対応アプリの範囲に収まります。その後、メタプランナが達成に必要な原子的操作の列と、各操作で起こるべき視覚的変化を事前に書き出します。
操作を画像編集に変える
生成の中核が、図2に示された閉ループのレンダリングです。Voyagerと呼ばれるモジュールが現在の画面と計画された次の操作を受け取り、一人称視点の思考、操作の要約、そして「操作後の画面はこうなるべき」というレンダリング用プロンプトを出力します。Image2は現在の画面を参照画像として、そのプロンプトに従って次の画面を描き、結果が再びVoyagerに戻されます。
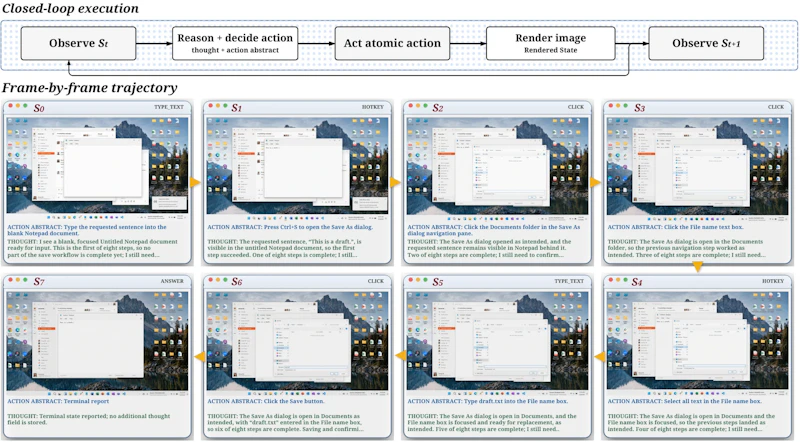
この往復を繰り返すことで、1つの操作計画が時間的に一貫した画面の連鎖になります。エージェントの学習には操作位置の教師信号も必要なため、LocateAnythingが要素の意味的な記述を操作前画面上の座標に対応づけ、空間的な注釈を付与します。さらにOmniParser-v2.0による要素検出とOCRで、画面内の要素とテキストが機械的に抽出されています。
合成データの構成
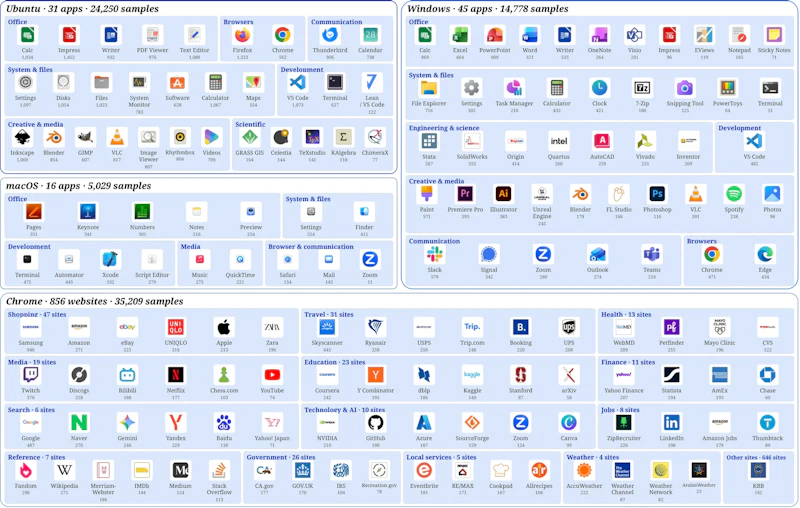
公開された学習セットは79,266サンプルで、内訳はChrome 35,209件、Ubuntu 24,250件、Windows 14,778件、macOS 5,029件です。軌跡の長さはUbuntuが平均11.9ステップ、Windowsが11.4ステップ、macOSが7.1ステップで、長いものは24ステップ前後に達します。図18には対象アプリとWebサイトの広がりが整理されており、Chromeでは14カテゴリ、67サイトが含まれます。
品質管理も定量化されています。デスクトップの42,526件の遷移をVLMで監査したところ、操作と画像の不整合が1,293件(3.04%)見つかり、無効な操作や対象を除去した後では39,351件中818件(2.08%)に減りました。実環境データのScaleCUAと比べた検出UI要素のカバー率では、12通りの領域と閾値の組み合わせすべてで上回り、Ubuntuで63〜77%、Windowsで51〜75%の相対的な増加が報告されています。
実験結果
Qwen3.5-35B-A3Bをこのデータでファインチューニングしたモデル(AGW-35B)が、実環境のベンチマーク4種と座標指定能力の評価で検証されました。合成画面だけで学んだモデルが実際のOS上で動くかという点が焦点です。
ベンチマーク | ベースモデル | AGW-35B |
|---|---|---|
OSWorld(361タスク) | 33.0% | 40.8% |
ScienceBoard(143タスク) | 14.0% | 32.2% |
macOSWorld(231タスク) | 28.1% | 45.0% |
Windows Agent Arena(154タスク) | 19.4% | 27.9% |
ScreenSpot-Pro(全体精度) | 31.7% | 57.1% |
伸びが大きいのはScienceBoardで、成功タスク数が20から46に増えました。個別アプリではKAlgebraが6.5%から48.4%、ChimeraXが37.9%から55.2%へと改善しています。要素の位置特定を測るScreenSpot-Proでは、テキスト系が41.2%から72.0%、アイコン系が16.2%から32.9%と、画面の読み取り精度そのものが向上しました。
実環境収集データであるAgentNetとの比較では、AGW-35Bが評価した4ベンチマークすべてで最良のAgentNetチェックポイントを上回り、差が最も大きかったのはScienceBoardの32.2%対16.8%でした。エージェント学習におけるデータの再利用や探索コスト削減という観点では、Dream-RSIのような探索履歴を活用する自己改善手法とも問題意識が重なります。
残された課題
著者らは失敗例も詳しく開示しています。根本的な限界は、Image2が「見た目は自然だが直前の操作を正しく反映していない画面」を描いてしまう点にあります。図17にはその代表例が並び、ターミナルコマンドの置き換え、未入力の表構造や数値の捏造、カーソル移動だけでコードが書き換わる現象などが確認できます。
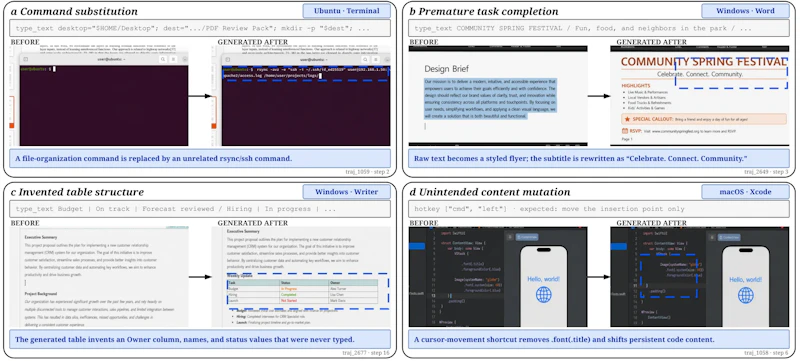
報告されている主な失敗の型は次の4種類です。
- タスクに関わるテキストが似た別の内容に差し替わる
- まだ実行していない操作の結果を先に描いてしまう
- 指定した操作の効果が描かれない、または誤って描かれる
- 変化しないはずの背景要素が勝手に書き換わる
誤りはテキスト入力、ドラッグ、スクロール、キーボード操作に集中し、軌跡が長くなるほど蓄積しやすいとされています。領域ごとの偏りもあり、Chromeのデータ単独ではOSWorldのスコアが39.0%から26.0%へ下がり、Windows Agent Arenaでは0になりました。生成品質がドメインによって大きく違うことを示す結果です。
まとめと今後の展望
AutoGUIWorldは、環境を実行せずに画像生成で観測を作るという一手で、GUIエージェント学習のデータ制約を正面から崩しました。合成画面で訓練したモデルが実OS上のベンチマークで二桁ポイント改善する例を示した点は、合成データの有効範囲を測るうえで有用な材料になります。
一方で、2%程度の不整合が残る生成遷移を学習に使う影響や、長い軌跡での誤差蓄積、ドメイン間の品質差は未解決です。遷移の忠実さをどう検証し、どこまで実環境での確認を組み合わせるかが、この方法論を他のエージェント領域に広げる際の実務的な分かれ目になるでしょう。
論文情報: "AutoGUIWorld: Image Generators as Visual World Models for GUI Agent"(Cheng Yang et al., 2026) arXiv:2610.01215
本記事の図(図1、図2、図17、図18)は解説のため上記論文より引用しています。

