 AI-Papers
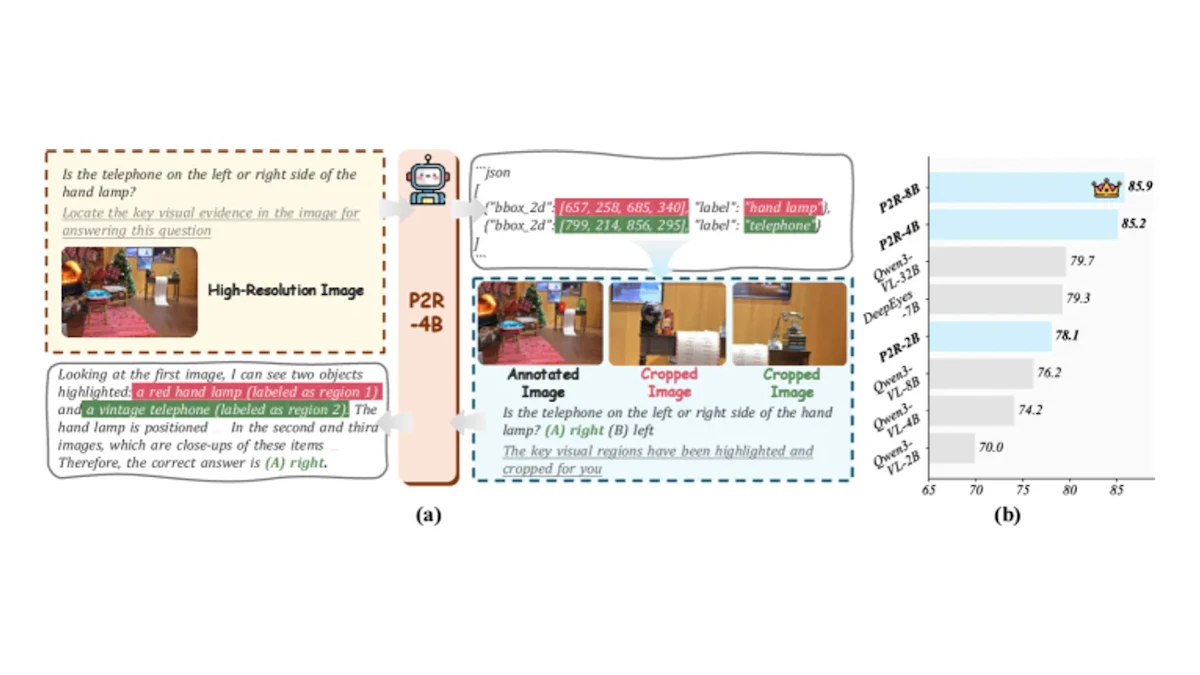
- 「知覚(証拠の特定)」と「推論(回答生成)」を明示的に切り離した2段階フレームワークP2Rを提案し、高解像度画像の細部理解を向上
- 役割認識型強化学習PRA-GRPOにより、最終回答の正誤信号だけで知覚フェーズと推論フェーズを交互に最適化できる設計
- 4BモデルでV-Star 93.2%・HR-Bench-4K 81.9%のSOTA性能を達成し、コードはGitHubで公開済み
研究の背景
人間は複雑な画像を見るとき、まず「どこに注目すべきか」を判断し、その後「何を意味するか」を解釈します。しかし従来のマルチモーダルLLM(大規模言語モデルと視覚処理を組み合わせたモデル)は、この2つのステップを一括で処理してきました。そのため、高解像度画像の細かな視覚手がかりを見逃しやすいという弱点があります。
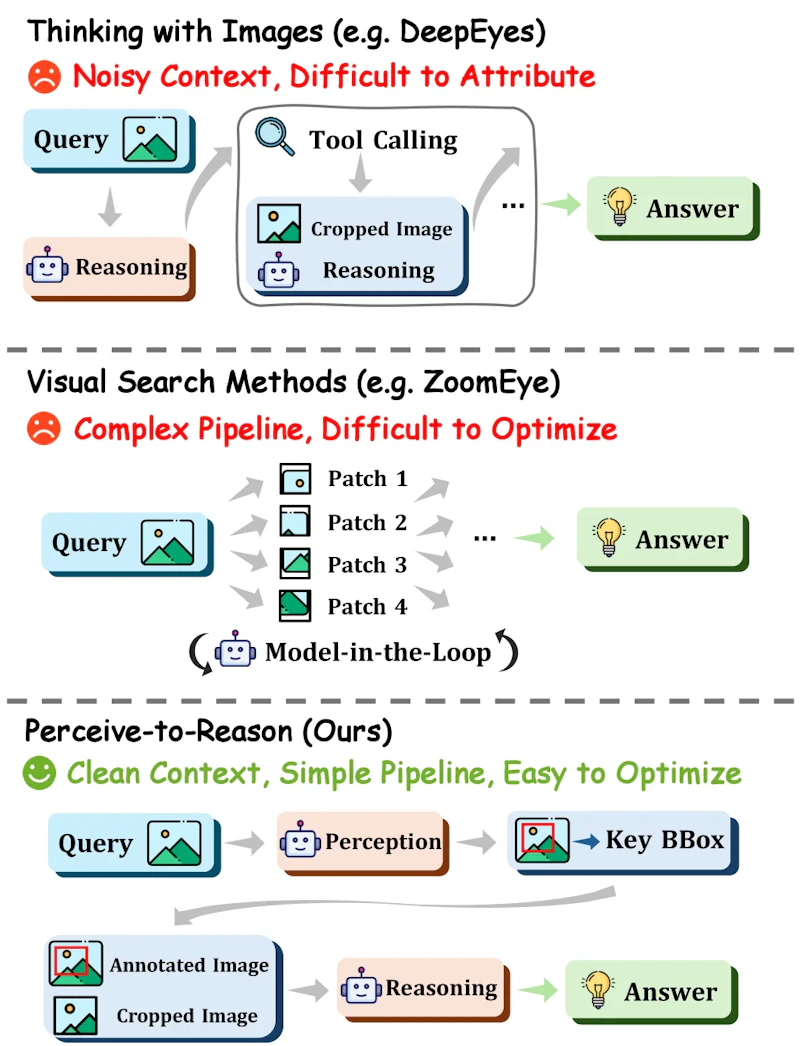
先行研究では、画像の一部を切り出したり検索で補完したりして局所的な証拠を補う試みが行われてきました。しかしこれらの手法は「知覚」と「推論」を明確に区別せず、一体的に処理する設計です。どちらの工程でエラーが生じているかを特定しにくく、改善の余地が残されていました。
P2Rフレームワークの仕組み
本研究が提案するP2R(Perceive-to-Reason)は、細粒度(きめ細かな)視覚推論を2段階で構成するフレームワークです。第1段階の「知覚フェーズ」では、質問に関連する証拠を含む領域をバウンディングボックス(矩形の枠)として特定します。第2段階の「推論フェーズ」では、切り出した局所領域と注釈付きの元画像を同時に参照しながら最終的な回答を生成します。
この設計の核心は、両フェーズでモデルのパラメータを共有している点にあります。専用のモジュールを追加するのではなく、同一モデルが「知覚者」と「推論者」という2つの役割を切り替えて動作する仕組みです。推論時の計算コストを大幅に増やさずに精度を向上できる、実用的なアーキテクチャといえます。
PRA-GRPOによる学習
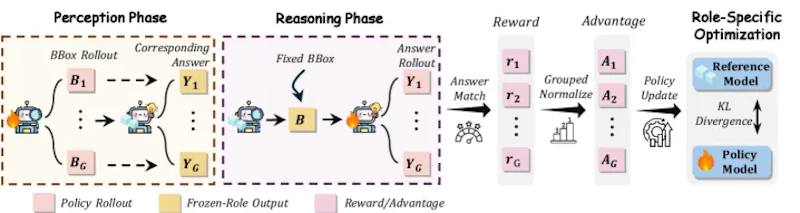
2段階フレームワークを有効に機能させるには、知覚フェーズと推論フェーズの両方を適切に学習させる必要があります。一般的な強化学習では、「どちらのフェーズが誤りの原因か」を区別する信号を得るのが難しく、学習が不安定になりがちでした。この課題を解消するために提案されたのが、PRA-GRPO(Perception-Reasoning Alternating GRPO)です。
学習は「知覚フェーズの最適化」と「推論フェーズの最適化」を交互に繰り返す形で進みます。各フェーズでは片方の役割のみをGRPO(グループ相対方策最適化)で更新し、もう一方のパラメータを凍結しておく仕組みです。最終的な回答の正誤という単純な監視信号から、役割ごとの学習信号を生成できる点が大きな特徴といえるでしょう。
実験結果
P2Rの有効性は複数の高解像度視覚ベンチマークで検証されました。Qwen3-VL(4B)をベースにしたP2R-4Bは、いずれのベンチマークでもSOTA(最高水準)の精度を記録しています。
ベンチマーク | P2R-4B |
|---|---|
V-Star | 93.2% |
HR-Bench-4K | 81.9% |
HR-Bench-8K | 80.5% |
4Bパラメータという比較的小さなモデルでこれだけの性能を実現している点は見逃せません。推論を潜在空間で効率化するアプローチとは対照的に、P2Rは推論プロセスの構造自体を見直すことで精度を引き上げます。
アブレーション実験では、知覚フェーズのみ・推論フェーズのみで学習した場合と比較して、両フェーズを交互に学習するPRA-GRPOが最も高い精度を示しました。
まとめと今後の展望
P2Rは「見る(知覚)」と「考える(推論)」を切り離すという直感的なアイデアを、実用的な2段階フレームワークとして形にした研究です。役割認識型の強化学習PRA-GRPOにより、最終回答の正誤という単純な監視信号だけで両フェーズを効果的に最適化できることが実証されました。
コードはGitHubで公開されており、Qwen3-VLをはじめとする既存モデルへの適用も容易です。今後は動画理解や医療画像解析など、細かな視覚認識が求められる領域への展開も見込まれます。
論文情報: "Perceive-to-Reason: Decoupling Perception and Reasoning for Fine-Grained Visual Reasoning"(Hongxing Li et al., 2026) arXiv:2607.01191, CC BY 4.0
本記事の図(図1〜図3)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


