 AI-Papers
- Microsoft AIが初のストリーミング音声認識モデル「MAI-Transcribe-2-Streaming」を公開し、音声受信から100ミリ秒強で暫定結果を返す
- 60言語に対応し自動言語判別を備え、Artificial Analysisの精度評価で1位、価格は音声1時間あたり0.54ドルの導入価格
- 音声合成の「MAI-Voice-2.1」「MAI-Voice-2.1-Flash」も同時発表され、Microsoft Foundryでパブリックプレビュー提供が始まった
3モデルを同時に発表
Microsoft AIは2026年10月1日(現地時間)、自社開発の音声モデル群を拡張する3つのモデルを発表しました。文字起こし(Speech to Text、STT)の「MAI-Transcribe-2-Streaming」、音声合成(Text to Speech、TTS)の「MAI-Voice-2.1」、およびその高速版「MAI-Voice-2.1-Flash」です。
このうちMAI-Transcribe-2-Streamingは、同社にとって初のストリーミング対応の文字起こしモデルにあたります。発話が終わるのを待たずに逐次処理するため、音声を受信してから100ミリ秒強で暫定的な認識結果を返します。
対応言語は日本語を含む60言語で、入力された音声がどの言語かを自動で判別する機能も備えます。第三者のベンチマーク機関であるArtificial Analysisの評価では、精度で1位と位置付けられています。
価格と性能の内訳
今回の発表では、3モデルすべてについて価格が明示されました。文字起こしは音声の長さ、音声合成は文字数を課金単位としています。
モデル | 遅延 | 対応言語 | 価格 |
|---|---|---|---|
MAI-Transcribe-2-Streaming | 約100ミリ秒で暫定結果 | 60言語 | 音声1時間あたり0.54ドル(年末までの導入価格) |
MAI-Voice-2.1 | 記載なし | 23言語 | 100万文字あたり22ドル |
MAI-Voice-2.1-Flash | 45秒の音声を150ミリ秒 | 23言語 | 100万文字あたり15ドル |
MAI-Voice-2.1は、1つの声のまま言語を切り替えても、それぞれの言語のネイティブアクセントで発話できる点を特徴としています。数秒の参照音声から声を複製する機能も用意されますが、利用には審査と本人の同意が必要です。
高速版のMAI-Voice-2.1-Flashは、同等の性能を持つ他社モデルと比べて約60%安価だと説明されています。遅延150ミリ秒という水準は、人間同士の会話に近いテンポでの応答を想定したものです。
音声エージェントの基盤
文字起こしと音声合成の双方で100ミリ秒台の遅延を確保した点は、音声で対話するAIエージェントを組む際の制約を緩めます。従来は、聞き取り、言語モデルによる応答生成、読み上げの3段階を直列につなぐと遅延が積み上がり、会話のテンポが崩れやすい課題がありました。
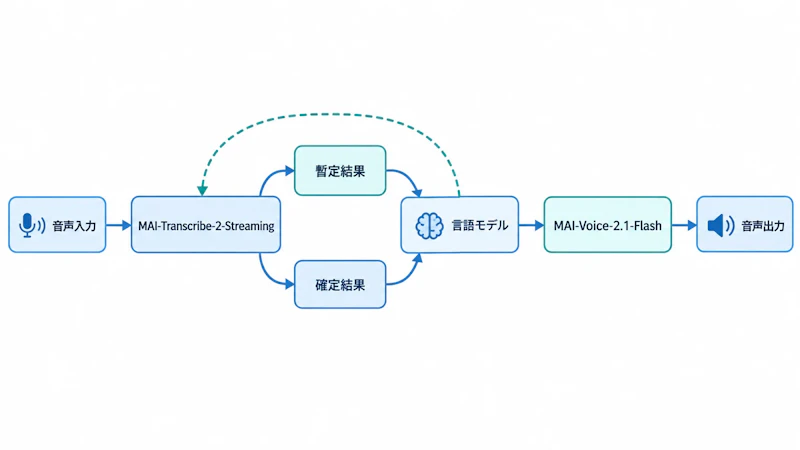
ストリーミング方式では、暫定結果を先に返して後から確定させる流れになるため、認識が終わる前に後段の処理を走らせる設計が取れます。図1のように、暫定結果と確定結果を分けて扱うことで、応答開始を早めつつ最終的な精度を保つ構成が可能になります。
音声を常時扱うエージェントでは、入力された音声の中に指示文が混ざり込む経路も生まれます。この種のリスクについてはプロンプトインジェクションとは?AIエージェント時代の攻撃手法と多層防御対策を解説で整理しています。
提供形態と残る制約
3モデルはいずれもパブリックプレビューとして公開され、開発者が即日検証できる状態にあります。提供経路は次の通りです。
- Microsoft Foundry(パブリックプレビュー)
- MAI Playground
- Vercel
- デモアプリケーション「Chatter」
日本語環境については制約が残ります。音声合成の日本語の既定音声は現時点で未実装で、東日本(Japan East)リージョンでの提供が予定されている段階です。文字起こし側は日本語を含む60言語に対応しているため、入力と出力で利用可能な範囲が異なる点に注意が必要です。
Microsoftは言語モデルでもMAIシリーズの自社開発を進めており、音声領域での今回の拡張も、外部モデルへの依存度を下げる流れの一部に位置付けられます。価格を明示したうえでプレビューを開放する進め方は、既存の音声APIを使う開発者に比較検討を促すものとなっています。


