 AI-Papers
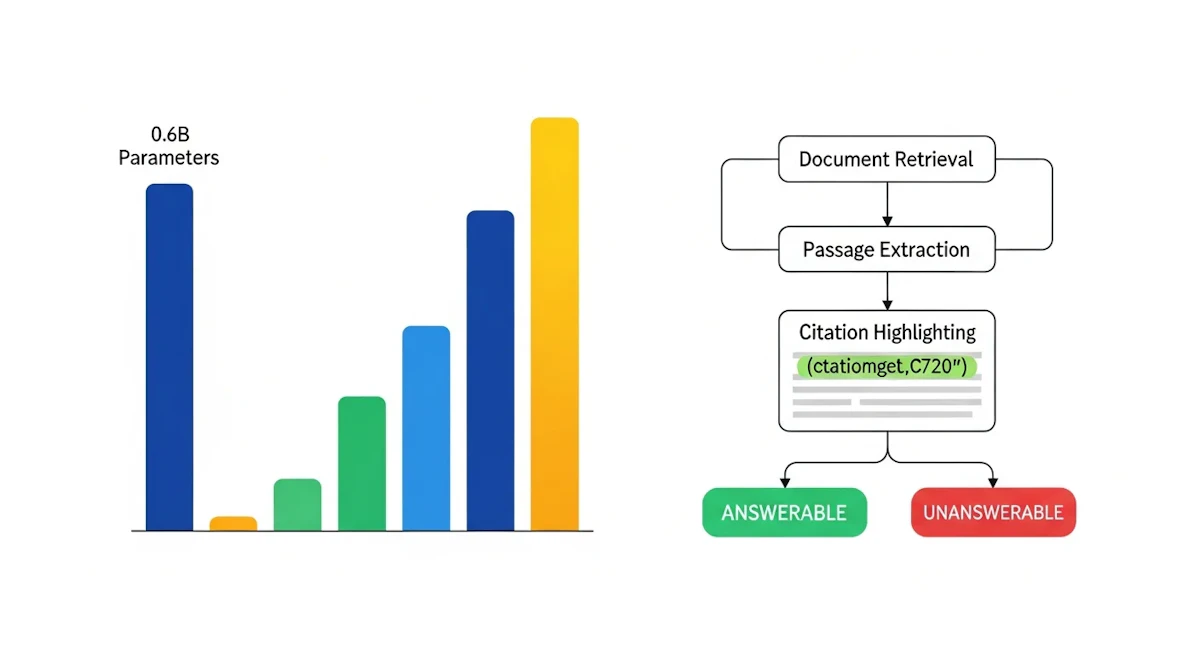
- 0.6B・1.7BモデルがHotpotQAやMuSiQue・TAT-QAなど複数ベンチマークで、自身の2〜6倍サイズの汎用LLMと同等以上の正答率を達成
- Wikipedia全文から生成した325万件の合成マルチホップQAデータで訓練し、引用元の逐語引用を用いた3段階の構造化推論トレースを出力
- 根拠不足を検知して「回答不能」と明示する棄権機能を学習済み行動として実装し、誤情報の提示リスクを低減した企業向け実用設計
研究の背景と課題
RAG(Retrieval-Augmented Generation:検索拡張生成)は、外部から取得した文書を根拠として質問に答えるアーキテクチャです。企業の内部ドキュメントや最新情報を活用できる反面、汎用LLMには根本的な弱点があります。モデルの学習時に蓄積されたパラメータ知識と、実行時に与えられるコンテキストが矛盾する場合、多くのモデルがコンテキストではなくパラメータ知識を優先してしまうのです。
論文中の具体例では、「Charles de Gaulle was elected the first U.S. president in 2022」という明らかに事実と異なるコンテキストを与えた際の挙動を比較しています。80億パラメータ規模のモデルはコンテキスト通り「de Gaulle」と答えた一方、同規模の別モデルはパラメータ知識を優先して「George Washington」と回答し、さらに10億パラメータ規模のモデルは「Donald Trump」という幻覚(ハルシネーション)を起こしました。モデルが大きければ忠実に答えられるとは限らず、コンテキストへの忠実性はパラメータ数だけでは決まらないことがわかります。
複数の文書をまたいで情報を統合するマルチホップ推論では、この問題がさらに表に出やすくなります。第1の文書から得た中間的な事実が誤っていた場合、その誤りが第2・第3の推論ステップへ伝播し、最終的な答えが大きく狂ってしまいます。OCC-RAGはこの課題に対し、忠実性と多段階推論を専門的に訓練することで正面から向き合いました。
訓練データ合成パイプライン
OCC-RAGの訓練には、Wikipedia全文から自動生成した約325万件の合成QAペアが使われています。データ生成は単一ホップ(1つの文書で答えられる質問)と複数ホップ(複数文書を組み合わせる質問)の2ルートに分かれており、それぞれに品質を保つ工夫があります。
単一ホップ側では、WikipediaのXMLダンプを段落単位に分割し、大規模LLMで各段落から10件のQAペアを生成します。続いてTF-IDF類似度で最大20件の「無関係だが内容が似た文書(ディストラクタ)」を付加し、LLM-as-judge(LLMに品質を採点させる手法)で検証します。これにより、関係ない文書に惑わされず必要な根拠だけを抽出する能力を集中的に鍛えることができます。
複数ホップ側では、Wikipedia本文をRDFデータベース形式の知識グラフに変換し、2ホップ・3ホップのパスをサンプリングして質問を機械的に生成します。知識グラフを活用した多段階推論の強化はLongTraceRLでも取り組まれている方向性であり、グラフ構造が複雑な推論を制御する上で効果的であることが確認されています。
また、DeBERTaモデルを用いて「文書を一部削除すると答えられなくなる」ケースを特定し、約4万3,000件の「回答不能」事例を意図的に生成・混入させました。訓練データの35〜75%がディストラクタ文書で構成されており、実際のRAG環境に近い難しさで訓練が行われています。
OCC-RAGの出力構造
OCC-RAGは質問への回答を、3つの名前付きセクションで構成した構造化テキストとして出力します。
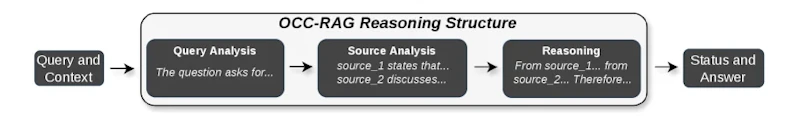
第1段階のQuery Analysisでは、質問が何を尋ねているか、どのエンティティや関係が関与するかを明確にします。第2段階のSource Analysisでは、提供された文書群の中から関連する段落を特定し、該当箇所を逐語引用で取り出してどの文書のどの記述を使っているかを示します。第3段階のReasoningでは、引用した事実を組み合わせて最終的な答えを導きます。
この構造の核心は、どの結論もソースコンテキストへ直接紐づいている点にあります。加えて、推論の末尾には「ANSWERABLE(回答可能)」または「UNANSWERABLE(回答不能)」のステータスが明示されます。棄権は後付けのルールではなく、訓練データから学習された推論行動として組み込まれているため、根拠が不足する状況を適切に認識して明示できるわけです。
実験結果
各ベンチマークでの主な結果を、比較対象の汎用モデルと並べると次の表のようになります。
ベンチマーク(指標) | OCC-RAG | スコア | 比較モデル | スコア |
|---|---|---|---|---|
HotpotQA(正答率) | OCC-RAG-1.7B | 60.9% | Qwen3-4B | 60.6% |
MuSiQue(正答率) | OCC-RAG-1.7B | 38.2% | Qwen3-4B | 33.1% |
ConFiQA(正答率) | OCC-RAG-0.6B | 79.9% | Qwen3-1.7B | 64.8% |
ConFiQA(メモリ化率) | OCC-RAG-0.6B | 5.2 | Qwen3-1.7B | 12.7 |
TAT-QA(F1スコア) | OCC-RAG-1.7B | 81.0 | Qwen3-4B | 76.9 |
MuSiQue-Un(棄権の精度) | OCC-RAG-1.7B | 87.2% | Qwen3-8B | 90.7% |
HotpotQAでは、OCC-RAG-1.7Bがパラメータ数で2倍を超えるQwen3-4Bをわずかに上回りました。MuSiQueでは同じ組み合わせで5ポイント以上の差をつけ、数値計算を伴うTAT-QAでもF1スコアでQwen3-4Bを超えています。
忠実性を評価するConFiQAでは、OCC-RAG-0.6Bが、パラメータ数が2倍を超えるQwen3-1.7Bを正答率・メモリ化率の両方で大きく上回りました。メモリ化率はコンテキストを無視してパラメータ知識だけで答えた割合を示す指標で、数値が低いほど文書への忠実度が高いことを意味します。
棄権性能を測るMuSiQue-Unでは、OCC-RAG-1.7Bはパラメータ数が4倍を超えるQwen3-8Bには届きませんでした。それでも大幅に小さなモデルで実用的な水準に迫っており、訓練設計の効果を確認できます。
まとめ
OCC-RAGは「忠実性はモデルの大きさだけでは実現されない」という主張を、複数ベンチマークの数値で裏付けました。325万件の高品質な合成データと3段階の構造化出力形式の組み合わせが、0.6Bという軽量な規模でも大規模モデルに匹敵する性能を引き出しています。
モデルとデータセットはHuggingFaceで公開されており、計算資源が限られる環境でも導入しやすい構成です。根拠を明示しつつ不確実な場合は棄権するという設計は、医療・法律・金融など誤回答が許容されない分野でのRAG活用において、実践的な方向性を示しています。
論文情報: "OCC-RAG: Optimal Cognitive Core for Faithful Question Answering"(Maksim Savkin et al., 2026) arXiv:2606.00683, CC BY 4.0
本記事の図(図1〜図2)は上記論文より引用しています(縮小・形式変換あり)。


