 AI-Papers
- スコアリングトークンのlogit分布の期待値から連続スコアを算出し、LLM-as-a-Judgeで生じる27%の同点率を0%に解消
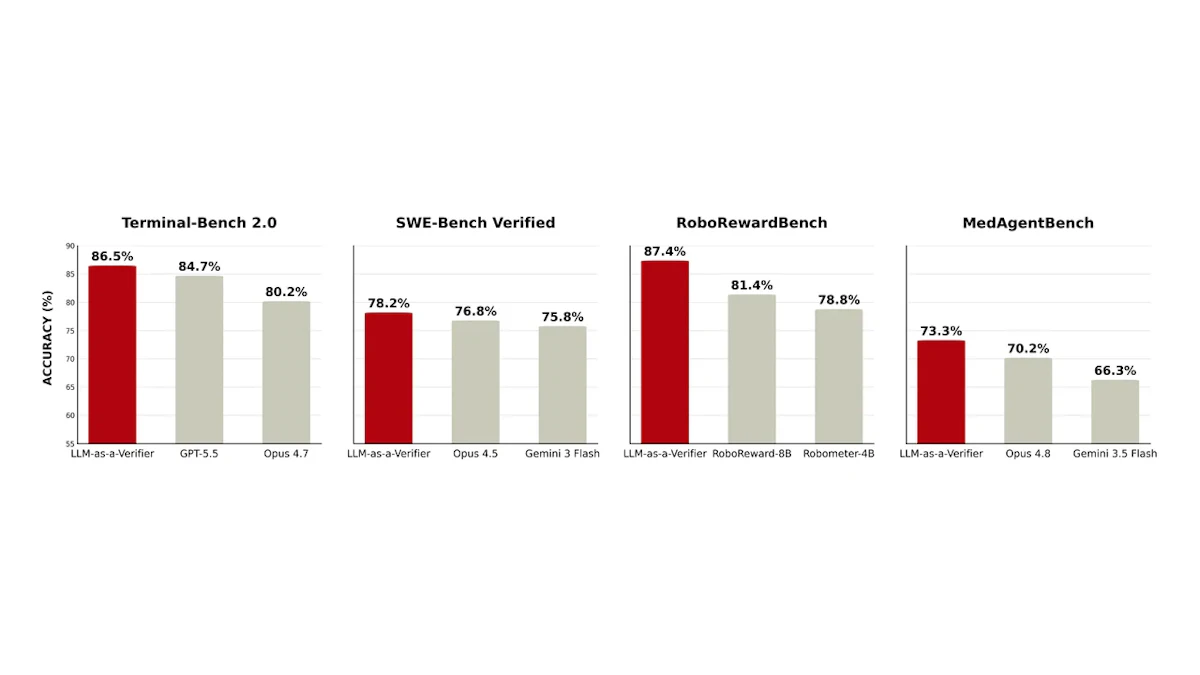
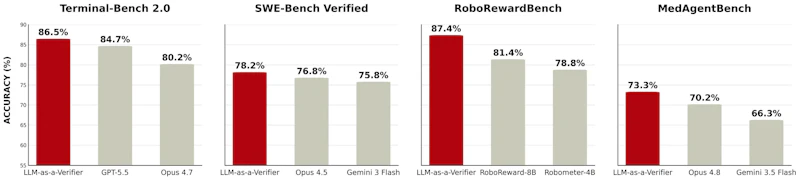
- スコア粒度・反復評価・基準分解の3軸で検証をスケールさせ、SWE-Bench Verified 78.2%・RoboRewardBench 87.4%など複数領域でSOTAを更新
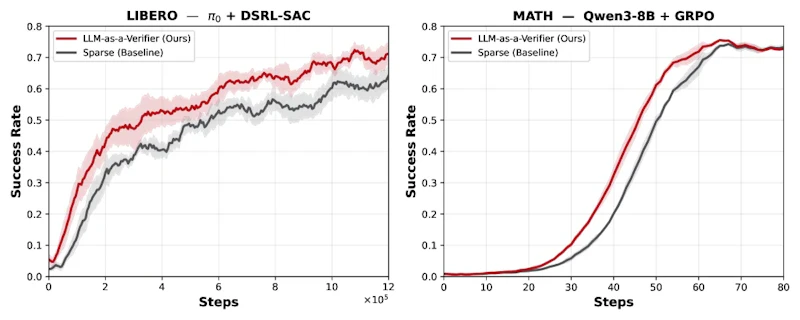
- 強化学習の報酬シグナルにも活用でき、ロボット制御で同等の成功率達成に必要な学習ステップを約1.8倍削減
研究の背景
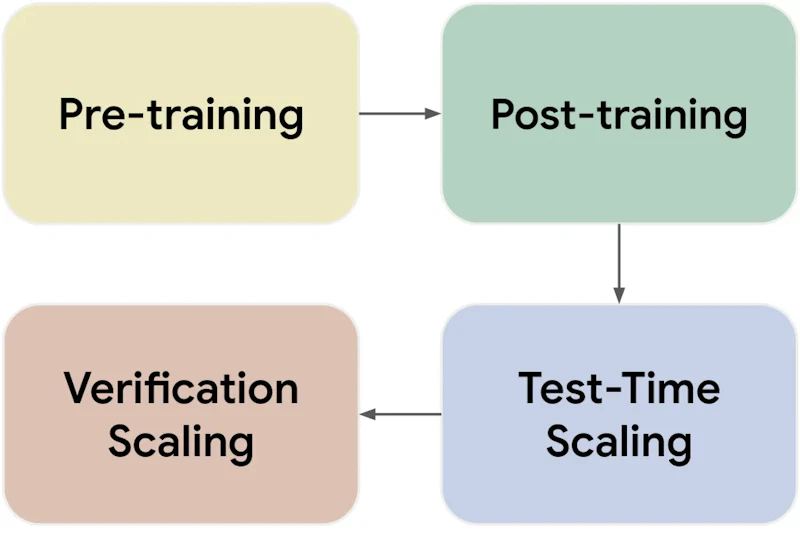
LLM(大規模言語モデル)の能力を高める方法として、これまでは主に2つのアプローチが研究されてきました。ひとつは事前学習のスケールアップ(より大きなデータとモデル)、もうひとつは推論時の計算量の増加(思考連鎖や多数の候補生成)です。
しかし、どちらのアプローチも「生成した候補の中から正しいものを確実に見極める」仕組みを持っていません。候補をいくら多く生成しても、評価する手段が粗ければ最良の答えを選び取れないからです。
本研究が提案するLLM-as-a-Verifierは、この「検証(Verification)」を第三のスケーリング軸として体系化します。パラメータを増やすでも推論計算を増やすでもなく、検証の精度と計算量を高めることでモデル全体の性能を底上げするという発想です。
提案手法の仕組み
従来のLLM-as-a-Judge(LLMを審査員として使う手法)は、モデルに「1点・2点・3点」といった離散スコアを直接生成させます。この方式では、同じタスクで複数の候補を評価したとき、同点になってしまうケースが26.7%にのぼり、選別の精度に限界がありました。
LLM-as-a-Verifierはこの問題を別のアプローチで解決します。スコアを示すトークン(「1」「2」「3」など)それぞれの出力確率(logit分布)を取り出し、その期待値を連続スコアとして計算するのです。たとえば「3点が50%・4点が30%・5点が20%」という分布なら、スコアは3.7という実数として算出されます。
この方式には2つの大きな利点があります。まず同点が原理的に発生しません。次に、モデルが「迷っている」不確実な状態も確率分布の形で捉えられるため、評価のばらつきを後から統計的に扱えます。
3つのスケーリング次元
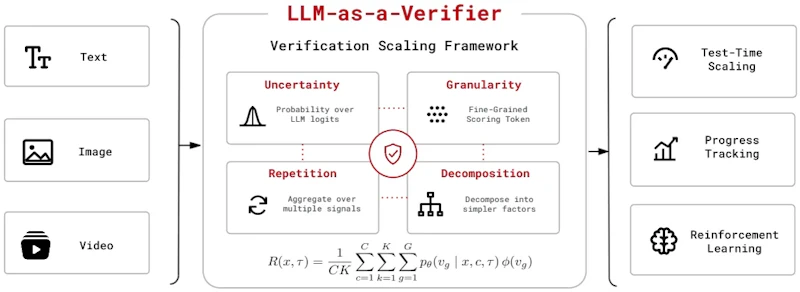
フレームワークの核心は、検証を3方向に独立して拡張できる点にあります。
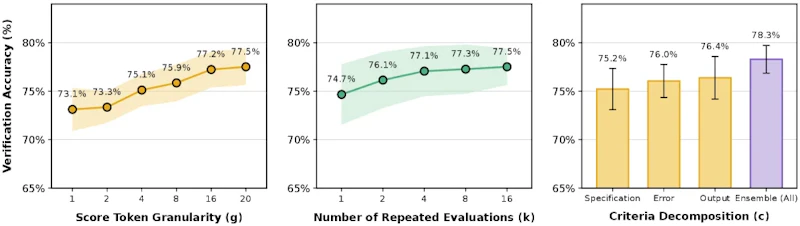
- スコア粒度(Granularity): 5段階から10段階・20段階へと目盛りを細かくするほど、正解と不正解の判別精度が上がります
- 反復評価(Repeated Evaluation): 同じ候補を複数回評価してスコアを平均することで、1回評価の偶然性を打ち消せます
- 基準分解(Criteria Decomposition): 「正確さ」「効率性」「安全性」など評価軸を分けて個別採点し合算することで、複雑なタスクでも精密な評価が可能になります
論文では、これら3軸のいずれを拡張しても検証精度が一貫して向上することを実験で確認しています。
効率的な候補選択アルゴリズム
N個の候補から最良を選ぶには、原理的にはN²回の比較が必要です。候補が多くなると計算コストが爆発してしまいます。そこで本研究はProbabilistic Pivot Tournament(PPT)というアルゴリズムを提案しています。
まずランダムな順序でN個の候補を一巡りさせる「Ring Pass」を実施し、各候補の初期スコアを得ます。次に上位k個を「ピボット(軸)」として選び、残りの候補はピボットとの比較だけに絞ります。これにより計算量はO(N²)からO(Nk²)まで削減でき、kがNより十分小さい場合に大きな効率化になります。
Ring Passでは各候補が「A側」と「B側」に1回ずつ登場するよう設計されており、モデルが持つ位置バイアス(A側の候補が有利になりやすい傾向)を打ち消す工夫もされています。
実験結果
フレームワークの有効性は、性質が大きく異なる複数の領域で検証されました。
- SWE-Bench Verified(コード修正): 78.2%でSOTA。コーディングエージェントが生成した複数の修正候補を検証器が評価し、最良のものを選ぶ形で性能を引き上げました
- Terminal-Bench V2(ターミナル操作エージェント): 86.5%を達成。理想的な選択が行われた場合の理論的な上限を示すOracle Pass@Kは98.9%に達しており、検証によってその上限に近づけるポテンシャルが示されました
- RoboRewardBench(ロボット動作評価): 87.4%を記録。追加学習なしで、専用の学習済み報酬モデルであるRoboReward-8B(81.4%)を上回りました
- MedAgentBench(医療タスク): 73.3%でSOTA。医療診断や処置判断といった専門領域にも汎用的に適用できることを示しました
LLM-as-a-JudgeとLLM-as-a-Verifierの直接比較では、同点率(同スコアになり判別できないケース)がJudgeの26.7%に対しVerifierでは0%となり、判別力の差が明確に示されました。
強化学習への応用
連続スコアは強化学習(RL)の密な報酬シグナルとしても機能します。従来のRL学習では「タスク完了か失敗か」という疎な二値報酬しか得られないケースが多く、学習が収束するまでに膨大なステップを要するという課題がありました。
本研究はロボット制御(LIBERO環境)とテキスト推論(MATH)の2つの設定でその効果を検証しています。ロボット制御では各ステップの進捗スコアを報酬に加えることで、同等の成功率を約1.8倍少ない学習ステップで達成しました。テキスト推論では最終答えが同じでも推論の質を評価することで、約1.1倍の効率向上が確認されています。
LLMの強化学習における報酬設計の難しさはMIPIに代表される推論エンジン最適化の研究でも広く議論されており、LLM-as-a-Verifierはこの課題への実践的なアプローチのひとつといえます。
まとめと今後の展望
LLM-as-a-Verifierは、検証を第三のスケーリング軸として体系化し、コーディング・ロボティクス・医療にまたがる複数領域でSOTAを達成した点に意義があります。追加学習なしで既存のLLMをそのまま検証器として使えるため、導入のハードルが低いことも実用上の強みです。
一方で、検証の精度はベースとなるLLMの能力に依存するため、評価対象タスクがモデルの能力範囲を超える場合は信頼性が低下する可能性があります。また、反復評価や基準分解を組み合わせると計算コストが増えるため、精度とコストのバランスを設計する知見が必要になります。
コードはGitHubで公開されており、コーディングエージェントの評価から医療AI・ロボット学習まで幅広い応用が期待されます。LLMを「生成器」としてだけでなく「評価器」として活用するという発想は、今後のエージェント開発の設計を変えていく可能性があります。
論文情報: "LLM-as-a-Verifier: A General-Purpose Verification Framework"(Jacky Kwok et al., 2026) arXiv:2607.05391, CC BY 4.0
本記事の図(図1〜図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


