 AI-Papers
- 知識グラフのランダムウォークで生成した多段階質問と検索エージェントの探索軌跡を訓練データとし、5つの長文脈ベンチマークで既存手法を一貫して上回る性能を達成
- 検索エージェントが「読んだが引用しなかった文書」を高混同性ディストラクタとして活用し、関連情報の識別力を強化
- 正解応答にのみルーブリック報酬を付与するポジティブ限定戦略で報酬ハッキングを防止し、推論プロセスの質を直接最適化
研究の背景
大規模言語モデル(LLM)はコンテキスト長の拡張が続いており、数十万から数百万トークンを扱えるモデルも登場しています。しかし「長い文書の中から必要な情報だけを正しく拾い上げ、それを組み合わせて推論する」という能力は、コンテキスト長とは別の問題であり、現在もLLMの弱点のひとつです。
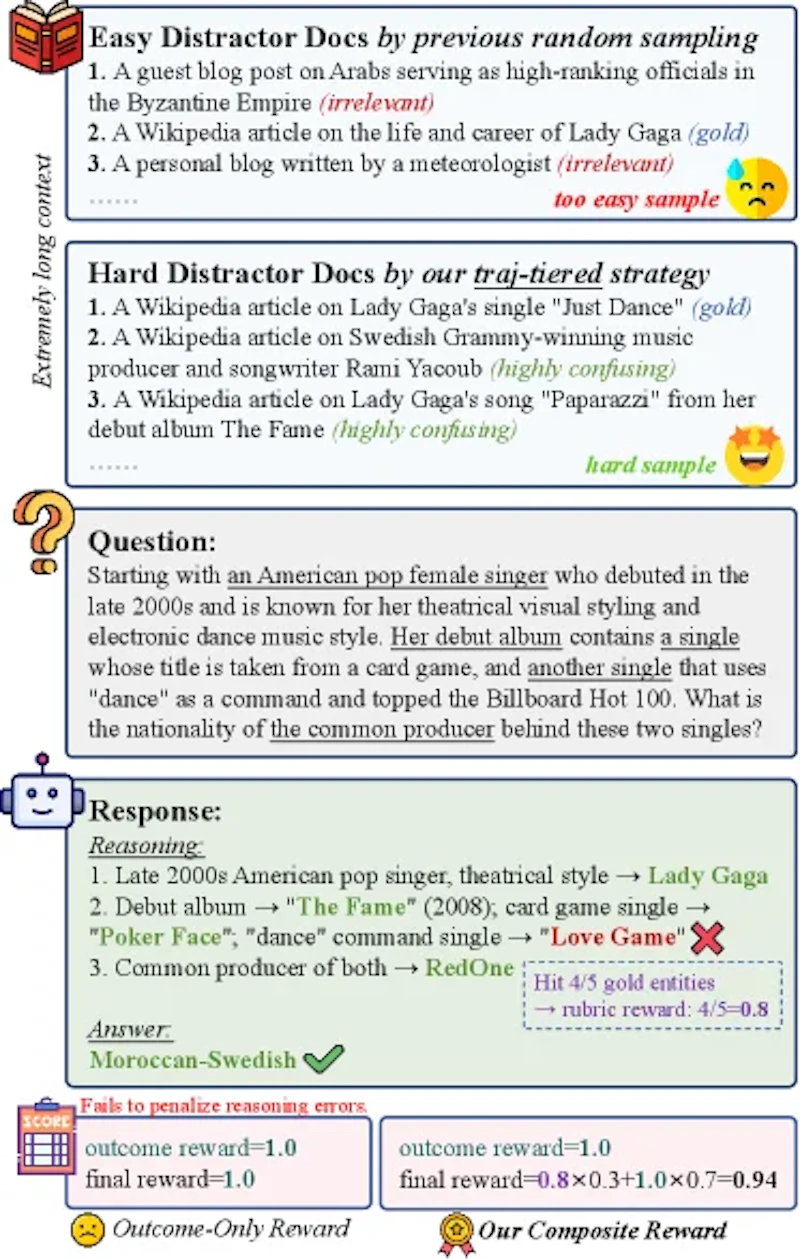
この課題に対し、強化学習(RL)を使ってモデルの長文脈推論能力を高める研究が進んでいます。しかし従来のアプローチには2つの限界がありました。1つ目は訓練データのディストラクタ(妨害文書)が簡単すぎること、2つ目は最終回答の正否だけを報酬とする「結果報酬のみ」の設計です。
これらの制約によって、モデルは文書をほとんど読まずに近道を探す悪い習慣を身につけてしまいます。
手法の全体像
清華大学と北京大学の研究チームが発表したLongTraceRLは、上記2つの問題を正面から解決するRLフレームワークです。「どんな難しいディストラクタを使って訓練するか」と「推論過程をどう報酬で評価するか」という2つの側面から同時にアプローチしている点が、従来手法との大きな違いになります。
データ構築と難度設計
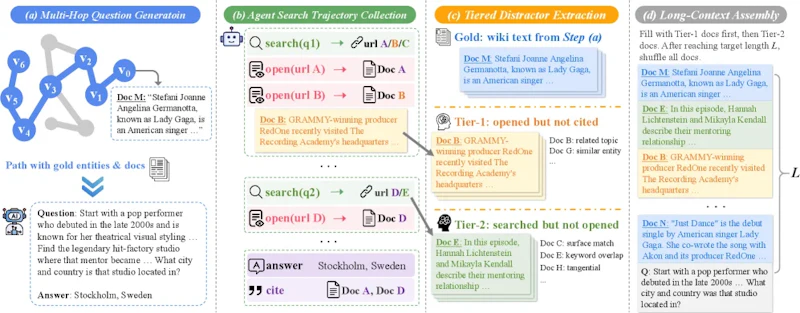
訓練データの土台となるのは、KILTデータセットのWikipediaハイパーリンクグラフです。このグラフ上で8ステップのランダムウォーク(無作為な経路探索)を実行し、複数のエンティティ(固有名詞や概念)を連鎖的につなぐパスを収集します。収集したパスをもとにGPTが最大8ホップの複合質問を自動生成するため、単純な検索では解けない本格的な多段階推論が必要な問題を大量に作成できます。
次に、これらの質問に対応する文脈文書として、検索エージェントの探索軌跡からディストラクタを抽出します。ここで採用するのが2層構造(ティアード)設計で、難度の異なる2種類の文書を組み合わせます。
- Tier-1(高難度): エージェントが実際に読んだが、最終的な引用には使わなかった文書
- Tier-2(低難度): 検索結果に表示されたが、エージェントが開かなかった文書
実際に読まれた文書はトピックが近く内容も混同しやすいため、モデルに本当の識別力が試される訓練素材になります。
こうした知識グラフを活用して多様な情報源から必要な内容を探索するアプローチは、テキスト・テーブル・知識グラフを横断する統合検索を扱うOmniRetrievalなど、最近のRAG研究とも共鳴する方向性です。
ルーブリック報酬の設計
報酬設計では、最終回答の正否を判定する「結果報酬」に加えて、推論ステップの質を測る「ルーブリック報酬」を導入しています。ルーブリック報酬は「回答の中に含まれる正解エンティティ数 ÷ 全正解エンティティ数」という比率で算出されます。モデルが単に正解を当てるだけでなく、推論の各ステップで必要な情報を正しく参照できているかを細かく評価できる仕組みです。
ここで鍵になるのが「ポジティブ限定戦略」です。ルーブリック報酬は最終回答が正解の場合にのみ適用します。不正解の回答にも報酬を与えると、モデルが正解エンティティをただ並べるだけの「報酬ハッキング」に走りやすくなるためです。
最終的な報酬は結果報酬とルーブリック報酬を係数α=0.3で組み合わせた形となり、この設定が最良の性能をもたらすことが実験で確認されています。
実験結果と考察
LongTraceRLは4B・8B・30Bの3モデルで、5つの長文脈ベンチマークを対象に評価されました。Qwen3-4Bではベースラインの53.3点から59.0点へ5.7点改善し、最強のベースライン手法と比較しても2.5点上回る結果を達成しています。30Bの大型モデルでも同様の傾向が見られ、モデルサイズに関わらず手法の有効性が確認されました。
ディストラクタの設計と報酬設計がどれだけ効いているかを、Qwen3-4Bでの比較実験の数値で見てみます。
設定 | スコア |
|---|---|
LongTraceRL(探索軌跡ベースのティアード構成 + ポジティブ限定) | 59.0点 |
ポジティブ&ネガティブ方式のルーブリック報酬 | 57.1点 |
検索ベースの文書をディストラクタに使用 | 56.7点 |
ランダムな文書をディストラクタに使用 | 55.7点 |
ルーブリック報酬なし(同一データで訓練) | 53.7点 |
ベースライン | 53.3点 |
ディストラクタの難度設計が性能に直接影響することに加え、ルーブリック報酬を外すとベースラインに近い水準まで落ちることから、報酬設計そのものが性能向上の主要因だと裏付けられています。正解と不正解の両方に報酬を与える方式がポジティブ限定を下回る点も、報酬ハッキングを避ける設計の妥当性を示しています。
まとめと今後の展望
LongTraceRLは、知識グラフを使った自動データ生成と、推論過程を直接評価するルーブリック報酬という2つのアイデアで、長文脈推論の改善という実用的な課題に取り組んだ研究です。4Bから30Bまで幅広いモデルサイズで効果が確認されており、コード・データセット・モデルがすべて公開されているため再現性も高く、研究の出発点として活用しやすい内容と言えます。
今後の展望としては、Wikipedia以外のドメインへの拡張や、数百万トークン規模のより長い文脈への適用が考えられます。ルーブリック報酬の考え方は長文脈推論に限らず、複数ステップの推論を要するタスク全般に応用できる可能性があり、過程を監督する報酬設計の研究に新しい視点をもたらしています。
論文情報: "LongTraceRL: Learning Long-Context Reasoning from Search Agent Trajectories with Rubric Rewards"(Nianyi Lin et al., 2026) arXiv:2605.31584
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


