 AI-Papers
- NVIDIAのNeMo Agent ToolkitがDABStepのHardタスクで89.95%を達成し、データ分析ベンチマークの首位を獲得した
- 学習ループで生成した再利用可能なhelper.pyにより、軽量モデルを用いた1タスク20秒の高速推論を実現した
- オフライン省察で品質を維持しながら、比較手法比で約30倍の速度向上とコード量62%削減を同時に達成した
DABStepとは
DABStep(Data Agent Benchmark for Multi-step Reasoning)は、AIエージェントによる多段階データ推論能力を評価するベンチマークです。金融決済セクターのデータを対象に450タスクで構成され、そのうち84%がHardタスクに分類されます。
回答の正誤は厳密なテキストマッチで判定され、コード生成と実行を組み合わせた複数ステップの推論が求められます。単純なデータ検索では対応できない複雑な計算や条件分岐が多く含まれるため、汎用的なLLMをそのまま呼び出すだけでは高スコアを出せない難易度です。
このベンチマークで、NVIDIAのNeMo Agent Toolkit Data Explorerが首位を獲得したと発表されました。
3フェーズ設計の概要
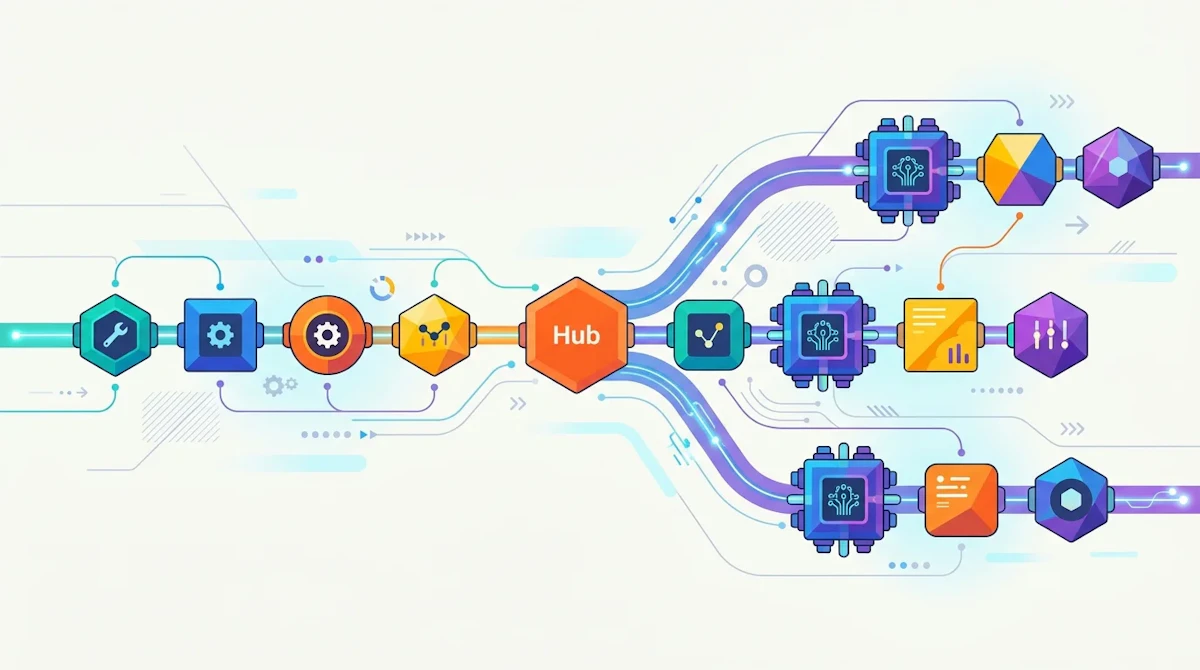
NVIDIAのNeMo Agent Toolkitは、学習ループ、高速推論、オフライン省察という3つのフェーズで構成されます。設計思想の核心は、知識の獲得と高速な推論を明確に分離することです。多段階の思考プロセスを一つのモデルに担わせる推論モデルとは異なり、重い処理を事前フェーズに切り出すことで推論時の負荷を最小化するアプローチをとっています。
人間のデータサイエンティストが作業前に堅牢なツールキットを整備してから分析に臨む手順を模倣した設計です。事前に共通操作を整理しておけば、個々のタスクへの対応は軽量な関数呼び出しだけで完結します。
学習ループの設計
学習ループでは、データセット内の代表的なタスクを重量級モデルでバッチ処理し、個別のPythonスクリプトをhelper.pyという統合ライブラリへ蒸留します。ここでの核心は、異なるタスク間の共通操作を認識し、DRY(Don't Repeat Yourself)原則に基づいて関数を段階的に汎用化する点です。
例として、「マーチャント手数料IDの一覧取得」と「特定月の取引手数料計算」は一見異なるタスクですが、どちらも「マーチャント情報の取得」と「手数料データの検索」という共通の基礎ステップを必要とします。こうした相互依存性を発見してリファクタリングを繰り返した結果が、多くのタスクに対応できる汎用関数群です。
同フェーズでは少数例(few-shot examples)も同時に生成し、後続フェーズで参照できる形に整備します。
高速推論の実現
推論フェーズでは、軽量モデルであるClaude Haiku 4.5を使用します。複雑なドメインロジックはhelper.pyに封じ込められているため、エージェントは関数シグネチャだけを参照して呼び出しを行えば済みます。
実装コードをコンテキストから除外することでウィンドウサイズを削減し、1タスクあたり20秒、コード長1,870文字という効率的な処理を実現しています。
オフライン省察
品質管理は本番推論フェーズではなく、オフラインで実施します。エージェントが生成したコードを事後的に審査し、helper.pyの活用度やプロンプト遵守度を確認する工程です。さらに類似タスク間での回答一貫性を分析し、矛盾するアプローチを検出して正確な方法論を推論します。
オフライン処理で得た知見はシステムプロンプトに注入され、次の推論フェーズで即座に活用されます。推論フェーズ自体を高速に保ちながら、省察ループを通じて精度を継続的に向上させる仕組みです。
性能比較と成果
DABStepリーダーボードの記載によると、NVIDIAのData Explorer(Claude Haiku 4.5使用)はHardタスクで首位に立ちました。同リーダーボードに記載の他システム、および比較対象として示されているClaude Codeの単独利用と並べると、次のようになります。
項目 | NVIDIA Data Explorer | 比較対象 |
|---|---|---|
Hardタスクの正答率 | 89.95% | AntGroup DataPilot 87.57% / Google AI DS-STAR 45.24% |
1タスクあたりの処理時間 | 20秒 | Claude Code単独 約10分 |
コード長 | 1,870文字 | 5,011文字 |
Hardタスクでの正答率の差は顕著です。処理速度は約30倍の高速化、コード長は62%の削減にあたり、推論効率の高さが確認できます。
実装へのヒント
このアプローチが示す設計原則は、データ分析に限らずAIエージェント全般に応用できます。タスク群に共通する操作パターンを抽出し、再利用可能なライブラリとして整備しておく。重い処理は事前フェーズに集約し、本番推論を軽量に保つ。品質検証はオフラインで行い、その知見をプロンプトに反映する。この3点が中心的な知見です。
NVIDIAはNeMo Agent Toolkitの実装例をNVIDIA Launchableを通じて公開する予定としています。データ分析タスクの自動化を検討するエンジニアにとって、実践的な参照設計として活用できるでしょう。


