AI-Papers
- 64×64の小さな行列ではCPU処理時間がGPU処理時間の約100倍あり、GPU計算ではなくCPUのオーバーヘッドが律速になる「オーバーヘッド境界」の状態をプロファイラーで確認できる
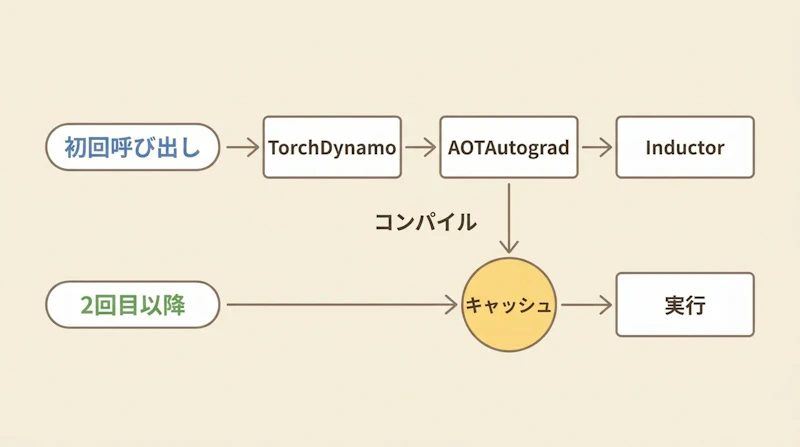
torch.profiler.profile()とChromeトレース出力を組み合わせると、CPU/GPU間の非同期実行の詳細やaten::matmulなどの内部カーネル起動まで時系列で可視化できるtorch.compile()は演算子フュージョンで効率を高めるが、初回呼び出し時にコンパイルが実行されてキャッシュされるため、最初の呼び出しに大きなウォームアップコストが発生する
torch.profilerとは
PyTorchに標準搭載されているtorch.profilerは、モデルのCPUおよびGPU処理時間を演算子単位で計測するためのツールです。どの処理がどれだけの時間を消費しているかを特定することで、性能改善の優先箇所を判断できます。
LLMや画像モデルを扱う開発者が「なぜ訓練が遅いのか」「GPUの利用率が上がらないのか」を調べる際の出発点として使います。基本的な使い方は、torch.profiler.profile()コンテキストマネージャで計測対象のコードをラップし、activities引数にProfilerActivity.CPUとProfilerActivity.CUDAを指定するだけです。計測後はprof.key_averages().table()でサマリーを表示したり、prof.export_chrome_trace()でChromeトレース形式のファイルを出力したりできます。
計測ノイズを減らすうえではscheduleパラメータの指定も効いてきます。標準的なパターンは次の3つの組み合わせです。
wait=1: 初期化フェーズをスキップするwarmup=1: ウォームアップに充てるactive=3: 実際に計測するステップ数を決める
この指定により、初期化やウォームアップの影響を除いた区間だけを計測対象にできます。なお、任意のコードブロックにrecord_functionでラベルを付けると、トレース上にそのブロックの処理が名前付きで表示され、大規模モデルでどのレイヤーが遅いかを特定する際に役立ちます。
小さな行列で見えるオーバーヘッド境界
HuggingFaceが公開したtorch.profilerのチュートリアルでは、64×64の行列を使ったmatmul(行列積)とadd(加算)の演算を例に、プロファイリングの読み方を解説しています。この設定で実際に計測すると、CPU処理時間の合計が約2,314マイクロ秒なのに対して、GPU処理時間の合計はわずか23マイクロ秒でした。
CPUの時間がGPUの約100倍あるということは、GPU計算自体はすぐ終わっているのに、CPUがその呼び出し準備やオーバーヘッドで大半の時間を消費している状態です。これを「オーバーヘッド境界(overhead-bound)」と呼びます。
この状態ではGPUを高性能なものに換えても改善効果はほとんどなく、行列サイズを大きくして1回の計算量を増やすか、演算を統合してカーネル起動回数を減らすことが有効な対策になります。
大きな行列では計算境界に変わる
4096×4096の行列で同じ演算を実行すると、CPU処理時間が約4.9ミリ秒、GPU処理時間が約4.5ミリ秒と、両者がほぼ同じ桁に収まりました。次の表のように、行列サイズによって両者の関係は大きく変わります。
行列サイズ | CPU処理時間 | GPU処理時間 |
|---|---|---|
64×64 | 約2,314マイクロ秒 | 23マイクロ秒 |
4096×4096 | 約4.9ミリ秒 | 約4.5ミリ秒 |
後者の状態を「計算境界(compute-bound)」と呼びます。計算境界ではGPU演算の最適化が直接的な性能改善につながり、より高性能なGPUへの移行や、FP16/BF16などの混合精度演算の活用が有効なアプローチになります。
プロファイラーでCPUとGPUの処理時間を比べることで、まず自分のコードがどちらの状態にあるかを診断するのが性能改善の出発点です。オーバーヘッド境界なのか計算境界なのかで、取るべき対策がまったく異なります。
Chromeトレースで実行を時系列で見る
prof.export_chrome_trace("trace.json")を呼ぶと、Chromiumのトレース形式でタイムラインが出力されます。このファイルをPerfetto UI(ui.perfetto.dev)で読み込むと、CPUレーンとGPUレーンそれぞれの処理が時系列で確認できます。
トレースを見ると、CPUがaten::matmulを呼び出してからGPUでカーネルが実際に実行されるまで、約2.5ミリ秒のオフセットがあることがわかります。CPUがカーネルをGPUに投入するコマンドを発行してから、GPUがそれを拾って実行を開始するまでに時間がかかるためです。こうした非同期動作の詳細をタイムラインで把握できる点が、プロファイラーの利点といえます。
また、最初のプロファイリングステップでは追加の遅延が発生しやすい点にも注意が必要です。cuBLASのヒューリスティック計算やワークスペースの割り当て、モジュールの遅延ロードが初回実行時にまとめて行われるためで、これがウォームアップを挟む理由の一つでもあります。
プロファイリングの知識を深めると論文中の実験設定も読み解きやすくなり、AI論文の読み方完全ガイドと合わせて参照すると研究の実験設計の背景をより深く理解できます。
torch.compileの効果と初回コストに注意
torch.compile()を有効にすると、aten::matmulとaten::addの2つの演算子がaten::addmmという1つの演算子に統合されます。これを「演算子フュージョン」と呼び、CPUからGPUへのカーネル起動回数を減らす効果があります。ただし、フュージョンはディスパッチャーレベルの統合であり、GPU上で実行されるカーネル自体が融合されるわけではない点に注意してください。
気をつけたいのは初回呼び出し時のウォームアップコストです。TorchDynamo、AOTAutograd、Inductorという3段階のコンパイル処理が初回の呼び出し時に実行され、その結果がキャッシュされます。このため最初の呼び出しは大幅に遅くなりますが、2回目以降はキャッシュ済みのコードが再利用されてフュージョンの恩恵を受けられます。
また、コンパイル後は実行時のCPUオーバーヘッドが増える点も把握しておくとよいでしょう。TorchDynamoのキャッシュ検証やAOTAutogradのラッパー処理が加わるため、チュートリアルの実測ではeagerモードと比べてCPUオーバーヘッドが約2倍になりました。
そのため、小さな行列や呼び出し回数の少ない処理にcompileを適用しても期待した効果が得られない場合があります。まずプロファイラーでボトルネックを特定し、計算境界にある処理にcompileを適用するのが効果的な順序です。