 AI-Papers
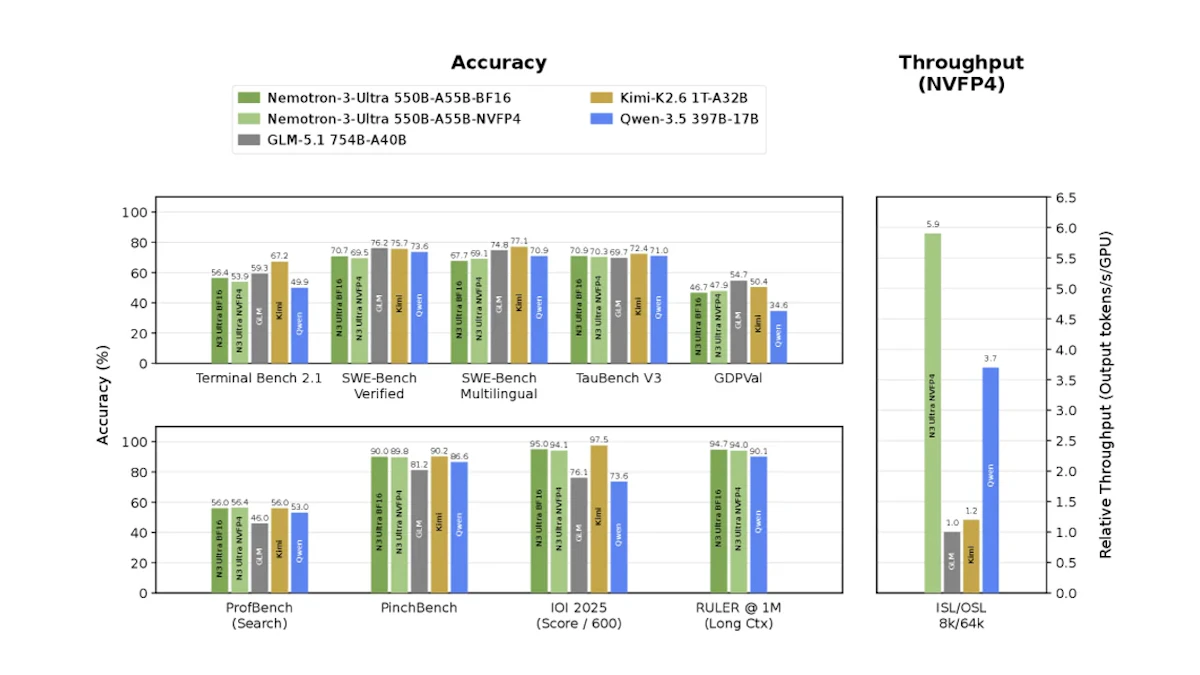
- MoE(混合専門家)でアクティブパラメータを全体の10%(55億)に抑え、Mambaとの組み合わせでKVキャッシュを削減し、推論スループットを最大6倍に向上
- NVFP4精度で20兆トークンを事前学習し、11以上の専門教師モデルを使う多教師蒸留(MOPD)で事後学習の精度を段階的に向上
- ベースモデル・量子化モデル・学習データ・学習レシピをすべてHuggingFaceでオープンソース公開し、開発者が試しやすい環境を整備
研究の背景
大規模言語モデル(LLM)の推論コストは、モデルの規模が増えるにつれて急速に膨らみます。精度を高めるためにパラメータを増やすほど、推論時のメモリ消費と計算量も増え、商用展開のハードルが上がりました。
この課題へのアプローチとして、MoE(Mixture of Experts、混合専門家)が注目を集めています。MoEは各トークンの処理に全パラメータではなく一部の「専門家」のみを使うため、総パラメータ数を増やしながら実際の計算量を抑えられます。
また、Transformerの自己注意機構が持つKVキャッシュ(過去のトークンの計算結果を保持する領域)の肥大化問題には、入力を固定サイズの状態に圧縮して処理するMamba(状態空間モデル)との組み合わせが有効です。NVIDIAはこの2つを組み合わせた「Nemotron 3 Ultra」を発表し、主要なオープンLLMと同等の精度を保ちながら推論スループットを最大6倍に向上させたと報告しています。
アーキテクチャ
Nemotron 3 Ultraの総パラメータは550億ですが、推論時にアクティブになるのはその約10%にあたる55億です。108層から成るハイブリッド構造で、Mamba層と自己注意(Attention)層を交互に配置しています。
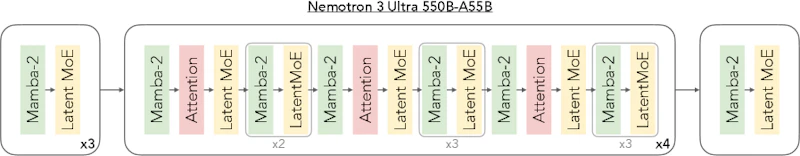
MoE部分はLatentMoEという手法を採用しており、1層あたり512個の専門家を持ちつつ、入力トークンごとに上位22件だけを起動します。ルーティングを潜在空間(潜在サイズ2048)で行うことで、通常のスパースMoEより高いパラメータ効率を実現しました。
Mamba部分は状態次元128、グループ数8、ヘッド数256という構成です。自己注意機構と異なり、過去の情報を固定サイズの状態に圧縮して処理するため、シーケンスが長くなってもKVキャッシュが増えません。これにより100万トークン(1Mトークン)のコンテキスト長に対応できます。
学習の工夫
事前学習は合計20兆トークンのテキストデータで行われました。第1フェーズ(15兆トークン)と第2フェーズ(5兆トークン)に分けてデータ構成を調整し、ウェブクロール約49%(第1フェーズ)を主体に、法律文書、コード(173B新規トークン)、事実探索データなど19カテゴリを組み合わせています。
学習精度にはNVFP4(NVIDIAの4ビット浮動小数点形式)を使用しました。ただし学習中に損失の急激な悪化(発散)が複数回発生し、チェックポイントに戻って再学習するなど、安定化には多くの工夫を要しています。
事後学習ではMOPD(Multi-teacher On-Policy Distillation、多教師オンポリシー蒸留)と呼ばれる手法を2回反復します。コーディング、数学、エージェント推論など11以上の専門分野でそれぞれ特化した教師モデルを訓練し、学生モデルが自ら生成した回答に対して報酬シグナルを与えます。2回目の反復では1回目の中間モデルも教師として加わり、さらに精度を高めました。
加えて、MTP(Multi Token Prediction、複数トークン予測)ヘッドを2つ追加して学習することで、推論時に投機的デコーディングを利用でき、生成速度をさらに高めています。
推論性能の比較
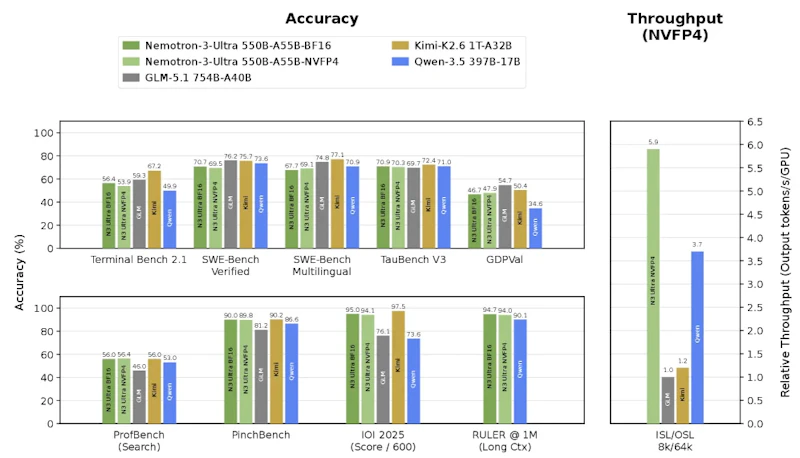
性能比較は、8Kトークン入力・64K出力という推論負荷が高い設定で行われました。GB200上でNVFP4精度を使用した場合、他の主要オープンLLMと比べてスループットが最大約6倍に達します。
この差はデコード(トークン生成)フェーズで特に顕著です。密なモデルは推論時に全パラメータを読み込む必要がありますが、Nemotron 3 UltraはアクティブパラメータがわずかなためI/Oボトルネックを回避できます。一方、入力の読み込み(プリフィル)が多い場面では活性パラメータ数が少ないため、Qwen-3.5などの競合モデルに速度で劣る場合があります。
精度面の主な結果は次の表のとおりです。
ベンチマーク | スコア |
|---|---|
MMLU | 89.08% |
GPQA | 50.0% |
HumanEval | 83.84% |
MATH | 82.0% |
RULER 1M(1Mトークン長文脈) | 76.83% |
長文脈への対応方針はモデルごとに異なります。注意機構の計算量を大幅に削減して1Mトークン対応を実現したMiniMax Sparse Attentionとは異なり、Nemotron 3 UltraはMambaによるキャッシュ回避という別のアプローチで長文脈処理を実現しています。
まとめ
Nemotron 3 Ultraは、MoEによるスパース化とMambaによるKVキャッシュ削減を組み合わせ、大規模モデルの精度と高速推論を両立させた実例です。特にエージェント推論や長時間タスクのように多くのトークンを生成する場面で、効率の改善が見込めます。
課題としては、プリフィル重視の設定では競合モデルに速度で後れをとる点と、NVFP4学習での安定化の難しさが挙げられています。ベースモデルから量子化済みモデルまで学習データ・学習レシピも含めてオープンソース化されており、研究者や開発者が自分の環境で実験しやすい点は大きな利点といえるでしょう。
論文情報: "Nemotron 3 Ultra: Open, Efficient Mixture-of-Experts Hybrid Mamba-Transformer Model for Agentic Reasoning"(NVIDIA et al., 2026) arXiv:2606.15007, CC BY 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


