 AI-Papers
- 28段階・約450倍のコーパス規模でRAGの4手法を統制比較し、1000万トークン超で古典的なBM25が最も強いことを実証
- 最大規模ではBM25が密ベクトル検索やエージェント検索を約20ポイント上回り、質問あたりの検索トークンは最大39分の1に抑制
- 密埋め込み優位というRAG設計の通念を覆し、LLMによるインデックス構築なしで最もコスト効率が高いと結論
研究の背景
RAG(Retrieval-Augmented Generation、検索で集めた文書を大規模言語モデルに読ませて回答を生成する仕組み)は、社内文書検索やナレッジベース構築の定番手法になりました。その検索部分をどう作るかについて、近年は密ベクトル検索(文書を意味の近さで探す埋め込みベースの手法)や、グラフ検索、LLM自身が文書を探索するエージェント検索など、新しい方式が次々と提案されています。
一方で、これらの比較は数千から数万件程度の小さなコーパスで行われることが多く、実際の企業データのように数十万件を超える規模でどうなるかは十分に検証されていませんでした。「BM25 Wins at Scale」と題した本研究は、この空白を埋めるため、同じ文書集合と同じ質問を使いながらコーパスの規模だけを段階的に変える統制実験を行い、規模とともに各手法の優劣がどう変化するかを追跡しました。
ここでいうBM25とは、単語の一致頻度と希少性をもとに文書をランク付けする古典的な語彙検索(キーワードマッチ)のアルゴリズムです。1990年代から使われてきた枯れた技術ですが、本研究はこれが大規模環境で最も有効だと示しました。
検証方法とコーパス設計
研究チームは、入れ子構造になった28段階のコーパス階段を用意しました。各段は1つ前の段を完全に含んだまま1.25倍ずつ大きくなり、最小の1144文書(約170万トークン)から最大の51万1959文書(約6億800万トークン)まで、約450倍の範囲を連続的にカバーします。
重要なのは、質問に関わる証拠となる文書群を一定に保った点です。土台となる1144文書は、正解の根拠となる722件、正解に似ているが誤った事実を含む326件の罠、存在しない情報を問う99件のおとり、2件の骨組み文書で構成されます。背景となるコーパスだけを膨らませることで、規模の増加が純粋に検索性能へ与える影響を切り出せるようにしています。
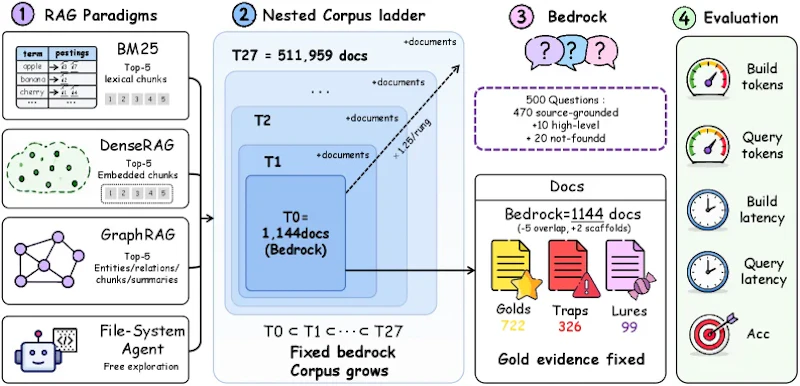
質問は全部で500問あり、コーパス内に直接根拠がある470問、複数の情報をまとめて答える高度な10問、そして「答えられない」と適切に判断すべき20問に分かれます。4つの検索方式(BM25、密ベクトル検索、グラフ検索、ファイルシステムエージェント)はいずれも同じリーダーモデルで回答を生成し、正解率に加えて構築トークン、検索トークン、応答時間まで計測されました。
主要な実験結果
小規模なコーパスでは、LLMが自らファイルを探索するファイルシステムエージェントが最も高い正解率を示しました。土台の170万トークン規模では、エージェントが77.4%、BM25が74.7%と僅差でエージェントが優勢です。密ベクトル検索は58.1%にとどまり、この段階から精度で見劣りします。
状況が変わるのが約1000万トークンの地点です。ここでBM25がエージェントに追いつき、以降はコーパスが大きくなるほど差を広げていきました。最大規模の6億800万トークンでは、BM25が50.5%を保つ一方、エージェントは30.7%、密ベクトル検索は29.9%まで落ち込み、その差は約20ポイントに達します。
規模 | BM25 | エージェント | 密ベクトル | HippoRAG 2 |
|---|---|---|---|---|
土台(170万トークン) | 74.7% | 77.4% | 58.1% | 66.2% |
約1000万トークン | 70.1% | 69.9% | 51.0% | 58.6% |
最大(6億800万トークン) | 50.5% | 30.7% | 29.9% | 計測停止 |
なぜ密ベクトルは弱いか
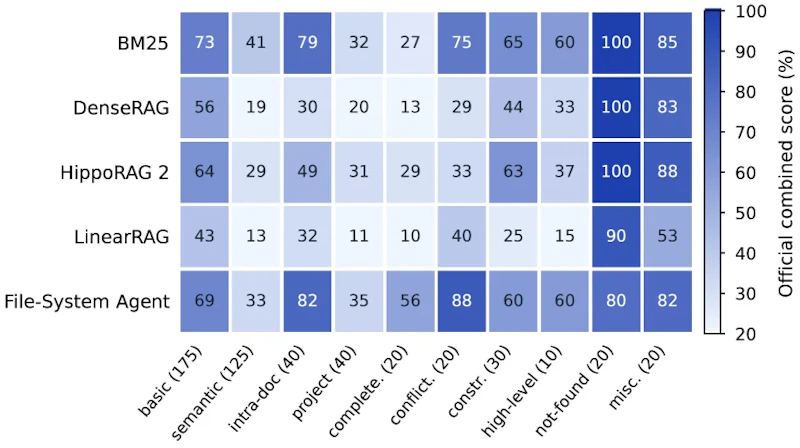
密ベクトル検索が規模とともに崩れる主な原因は、コーパスに紛れ込んだ意味的な罠にあります。正解と意味は近いのに事実が間違っている文書が増えると、意味の近さで探す密ベクトルはこれらを引き寄せてしまいます。単語の一致で判定するBM25のほうが、こうした紛らわしい誤情報をより確実にはじけるというわけです。
密ベクトル検索は高性能な埋め込みエンコーダの進化に支えられて計算効率自体は高いものの、本研究の設定では精度の壁を越えられませんでした。グラフ検索も苦戦しており、HippoRAG 2は1億5470万トークンで計測が止まり、その時点のスコアはBM25より15ポイント低い41.0でした。LLMでグラフを構築する方式は、そもそも大規模になる前に構築コストの壁にぶつかります。
コスト効率の圧倒的な差
BM25の強みは精度だけではありません。インデックス構築にLLMを一切使わないため、構築時の生成トークンはゼロです。対照的にMS-GraphRAGは1060万トークンのコーパスで1億9000万トークンを消費し、最大規模へ外挿すると79億トークンに膨らみます。LightRAGはさらに超線形に増え、推定1020億トークンという非現実的な水準に達しました。
検索時のコストも桁違いです。BM25は1問あたり約5800トークンで、規模が変わってもほぼ一定に保たれます。一方ファイルシステムエージェントは土台の22万6000トークンから膨張し続け、BM25の最大39倍もの検索トークンを消費しました。13万文書規模では割り当て予算の31%を使い果たす場面も出ています。
興味深いのは、エージェントの探索基盤を生ファイル検索からBM25のランク付けに差し替えた「Agent+BM25」の結果です。この一手だけで最大規模の正解率が36.9から69.4へと32ポイント以上改善し、検索トークンは1問あたり89万5000から10万1000へ激減しました。エージェント的な推論は、ランク付けされた候補を絞り込んだうえで働かせるのが最も効果的だと示しています。
まとめと実務への示唆
本研究は、数十万件規模の実務コーパスでは古典的なBM25が最も妥当な既定値であると結論づけました。複数情報を集約する質問にはAgent+BM25が向きますが、それでも発見の土台にはBM25のランク付けを使うのが効率的です。LLMでグラフインデックスを構築する方式は、構築コストがほぼ線形に収まり関係性を問う質問が主体でない限り、10万から100万文書の規模で採用を正当化するのは難しいとしています。
もっとも、この結果は特定の質問設計とリーダーモデルに依存する部分もあり、意味的な言い換えが多く語彙が一致しにくいタスクでは密ベクトルの利点が残る可能性があります。とはいえ、規模が大きくなるほど新しい手法が有利になるという直感に反し、枯れた語彙検索が精度とコストの両面で勝るという知見は、検索基盤を設計する開発者にとって実用的な出発点になるでしょう。
論文情報: "BM25 Wins at Scale: A Scaling Study of Retrieval-Augmented Generation Paradigms"(Pengyu Wang et al., 2026) arXiv:2607.26497
本記事の図(図2、図6)は解説のため上記論文より引用しています。


