 AI-Papers
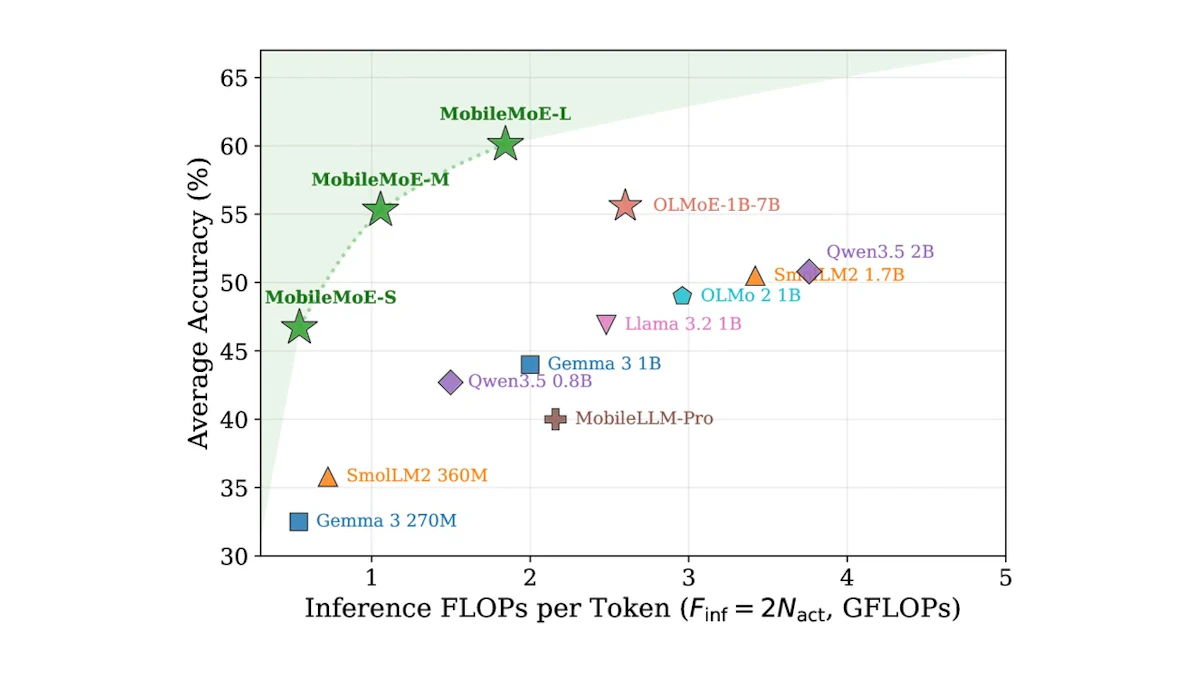
- 密モデル比2〜4倍少ない推論FLOPsで同等以上のベンチマーク精度を達成し、モバイル向けMoEの優位性を体系的に実証
- スケーリング則の分析から、専門家数E=8・細粒度g=8・共有専門家ありの組み合わせがオンデバイス最適構成と判明
- iPhone 16 ProとGalaxy S25の実機計測で最大3.8倍の高速デコードを実現し、INT4量子化によるメモリ削減も達成
研究の背景
スマートフォン上でLarge Language Model(LLM)を動かす「オンデバイス推論」への関心が急速に高まっています。しかしモバイルデバイスはメモリと演算能力に厳しい制約があるため、クラウド向けの大規模モデルをそのまま転用することはできません。
従来のオンデバイスLLMは主に「密モデル(Dense Model)」、すなわちすべてのパラメータを毎回の推論で使い切る設計を採用してきました。一方、データセンター向けにはMixture-of-Experts(MoE)、つまり入力ごとに一部の「専門家」サブネットワークだけを活性化するアーキテクチャが、計算効率の高い手法として確立されています。
ところがMoEはこれまで数十億から数千億パラメータ規模でのみ研究されており、0.3〜1B程度の小規模モデルでも有効かどうかは未検証でした。
Metaの研究チームはこの空白を埋めるため、モバイル向けのMoEスケーリング則を一から構築し、3つのモデルサイズで実機検証まで行った「MobileMoE」を発表しました。MiniMax-M2のようにフロンティア性能を目指す超疎MoEとは方向性が異なり、MobileMoEはスマートフォンの物理的制約を出発点に据えた設計原則の確立を目的としています。
オンデバイス向けスケーリング則
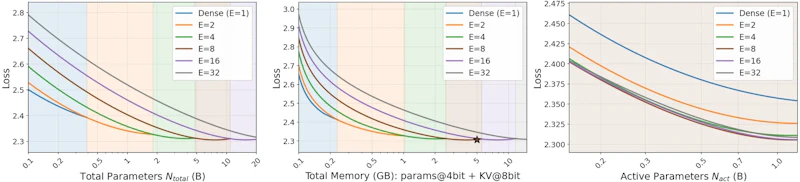
既存のLLMスケーリング則(Chinchillaなど)はデータセンター向けに推論コストを無視して設計されており、オンデバイス環境にそのまま適用できません。モバイルではモデルをメモリに収めながら推論速度も確保する必要があるため、独自の設計指針が求められます。
MobileMoEはこの問題に対し、「活性パラメータ数 Nact」「総パラメータ数 Ntotal」「オンデバイスメモリ M」の3軸を同時に考慮したスケーリング則を構築しました。任意の計算予算・メモリ制約のもとで最適なMoE設計を理論的に導出できる点が大きな特長です。
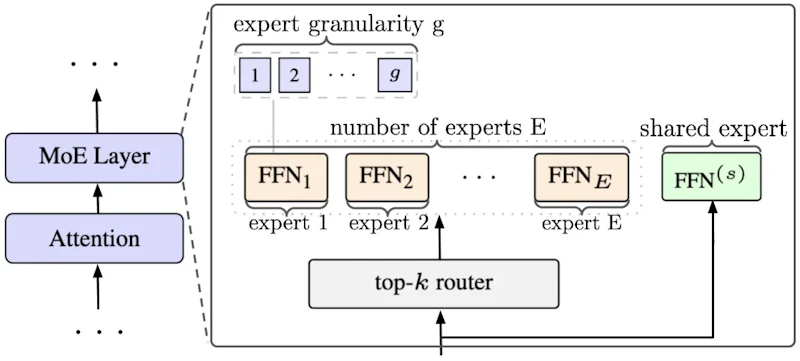
スケーリング則から導かれた主な知見は3点あります。第1に、メモリ量を固定した場合、MoEは密モデルよりも低い損失(高い精度)を達成でき、最適な専門家数はE=4〜8の範囲に集中しました。第2に、専門家を細かく分割する「細粒度設計(Fine-Grained Experts)」が固定計算量下で有効で、分割倍率g=8あたりで改善効果が飽和します。第3に、常に活性化される「共有専門家(Shared Expert)」を1つ加えると、ルーティング専門家のみの構成より損失が下がることが確認されました。
アーキテクチャの設計
スケーリング則の分析結果をもとに選定された最終アーキテクチャは、専門家数E=8、細粒度g=8、共有専門家ありという組み合わせです。各MoE層には64個の細粒度ルーティング専門家と1個の共有専門家が配置され、入力ごとに必要な専門家だけが選択されます。
モデルは3サイズで提供され、いずれもINT4量子化後のメモリ使用量が実機の制約に収まる範囲に設計されています。
モデル | 活性パラメータ | 総パラメータ | INT4メモリ |
|---|---|---|---|
MobileMoE-S(スモール) | 272M | 1.26B | 0.68GB |
MobileMoE-M(ミディアム) | 528M | 2.82B | 1.48GB |
MobileMoE-L(ラージ) | 922M | 5.33B | 2.75GB |
スモールの0.68GBは、現行のミドルレンジ端末でも常駐させやすい水準です。サイズが上がっても活性パラメータは1B未満に抑えられており、推論時の演算量は総パラメータ数ほどには増えません。
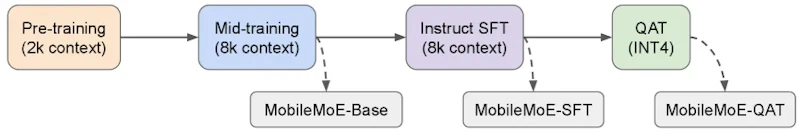
4段階の訓練レシピ
MobileMoEの訓練はすべてオープンソースデータを用いた4段階パイプラインで実施されており、再現性の高さが特長の一つです。
第1段階の事前学習(PT)では、ウェブデータを中心に約6兆トークンを処理し、幅広い言語能力の土台を築きます。第2段階の中間学習(MT)では、コード・数学・知識分野のデータ比率を高め、専門領域への適応力を伸ばします。ここで使われる約5,000億トークンは高品質にキュレーションされており、コンテキスト長も2,048から8,192トークンへ拡張されました。
第3段階の指示チューニング(SFT)では8,000万件以上のサンプルを通じ、実際の指示へ的確に応じられる能力を与えます。第4段階の量子化対応訓練(QAT)は、INT4精度への変換時の精度低下を最小化する工程で、実機デプロイの品質を保証する仕上げとなっています。
実験結果
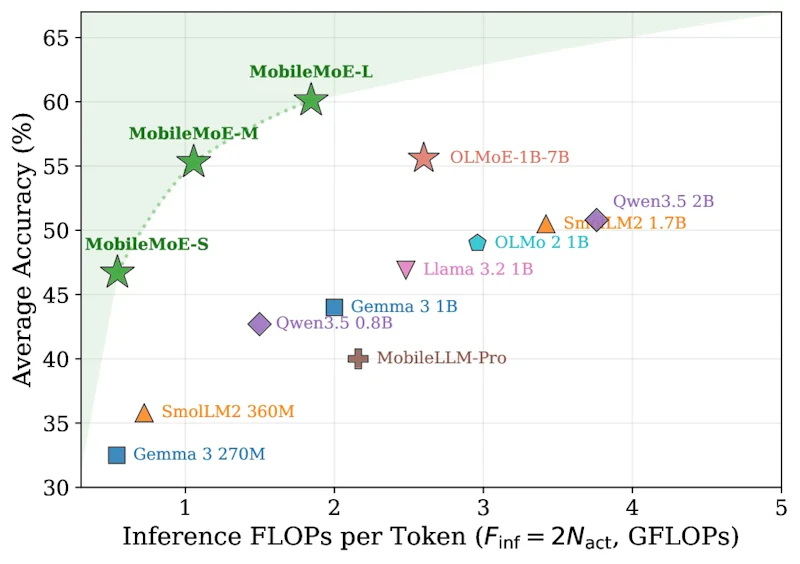
常識推論・知識・科学・読解・推論にわたる14のベンチマーク平均で評価したところ、MobileMoEは3サイズすべてで同規模の既存モデルを上回りました。
モデル | 14ベンチマーク平均 | 比較対象 | 比較対象の精度 |
|---|---|---|---|
MobileMoE-S | 46.7% | Gemma 3 270M | 32.5% |
MobileMoE-M | 55.3% | Qwen3.5 0.8B | 42.7% |
MobileMoE-L | 60.1% | OLMoE-1B-7B | 55.6% |
とりわけMobileMoE-LはOLMoE-1B-7Bに対し、総パラメータ数を23%削減しながら精度で上回っています。小さいモデルほど差が大きく、MobileMoE-SとGemma 3 270Mの開きは14ポイントを超えました。
推論速度の面では、INT4量子化済みモデルをSamsung Galaxy S25とiPhone 16 Proで実測しました。同等メモリの密モデル(MobileLLM-Pro)と比べると、プリフィル速度で1.8〜3.8倍、デコード速度で2.2〜3.4倍という改善が確認されています。iPhone 16 Proでは特に加速幅が大きく、8kコンテキストでのピークメモリ消費もMobileMoE-S(1.49GB)がMobileLLM-Proの1.91GBより22%少なくなりました。
訓練効率の観点でも差が出ています。MobileMoE-Lは密型ベースライン(Llama 3.2 1B: 9兆トークン、SmolLM2: 11兆トークン)の2〜4分の1のトークン数で同等以上の性能に到達しました。
まとめと今後の展望
MobileMoEはモバイル向けMoEスケーリング則を初めて体系化し、オープンソースデータのみで再現可能な4段階レシピを公開した点で価値ある研究です。密モデルと同等のメモリに収まりながら推論効率を大幅に改善できることが、実機データで裏付けられました。
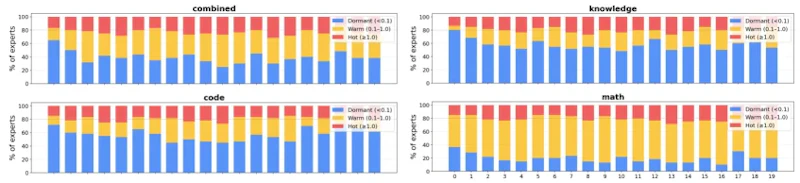
一方、課題も残っています。MoE特有のエキスパートルーティングのばらつきによる負荷分散問題や、より低スペックなデバイスへの展開可能性については引き続き研究が必要でしょう。訓練にH100を64基使用しているため、個人や中小規模での再訓練コストも無視できません。
それでも、スマートフォン上でのリアルタイムAI処理という実用目標に向けた明確な設計指針を示した意義は大きく、今後のオンデバイスLLM研究の基盤となる成果といえます。
論文情報: "MobileMoE: Scaling On-Device Mixture of Experts"(Yanbei Chen et al., 2026) arXiv:2605.27358, CC BY 4.0
本記事の図(図1、図2、図3、図6、図9)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


