 AI-Papers
- 229.9Bの総パラメータのうちトークンあたり9.8B(約4.3%)のみを起動する超疎MoE設計で、AIME 2026・94.2%、GPQA-Diamond・89.8%のフロンティア水準を達成
- 共通プレフィックスを一度だけ計算するPrefix-tree mergingで最大40倍の訓練高速化を実現し、長時間エージェント軌跡のRL訓練コストを大幅に削減
- 最新チェックポイントM2.7は自身の訓練スクリプトを自律的にデバッグして30%の性能向上を達成するSelf-Evolutionの初期段階に到達
研究の背景
大規模言語モデル(LLM)の性能競争は激化の一途をたどっています。しかしその多くは、推論のたびに数百億から数千億のパラメータを全量起動するため、計算コストが膨大です。「少ない計算量でフロンティアAIと同等の性能を引き出せるか」という問いは、研究者にとって長年の課題でした。
Mixture of Experts(MoE、専門家混合)と呼ばれる手法は、この課題への有力な回答として注目されています。モデル内部に多数の「エキスパート」(小さなサブネットワーク)を用意し、各トークンの処理には一部のエキスパートだけを呼び出す設計です。MoEを採用すればパラメータ総数は増えても、1回の推論で実際に動かすパラメータ数を抑えられます。
MiniMax社はこの設計思想を徹底し、229.9Bの総パラメータのうちトークンあたりわずか9.8B(約4.3%)しか起動しない超疎MoEモデル「MiniMax-M2」シリーズを発表しました。本論文(arXiv:2605.26494)では、M2・M2.5・M2.7の3世代で進化してきたモデルの設計と、それを支える訓練技術を詳述しています。
超疎MoEのアーキテクチャ設計
MiniMax-M2は256個の細粒度エキスパートを持ち、各トークンの処理には8つのエキスパートのみを起動します。多くのMoEモデルが採用するsoftmax top-kゲーティング(全エキスパートのスコアを正規化して上位k個を選ぶ方式)とは異なり、M2ではシグモイド(sigmoid)ゲーティングを採用しています。
シグモイドゲーティングでは各エキスパートが独立したスコアを受け取るため、エキスパート同士を直接競合させずに活性化を制御できます。さらにゲーティング関数に学習可能なバイアス項を導入し、エキスパートごとのルーティングスコアを調整することで、補助的な負荷均衡損失に依存せずに各エキスパートへの負荷を均等に保てるようになっています。
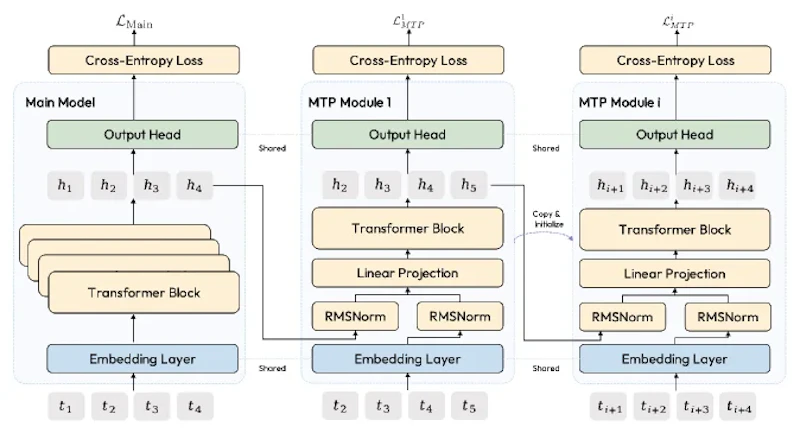
事前学習にはMulti-Token Prediction(MTP、複数トークン同時予測)モジュールも組み込まれています。事前学習の初期はMTPモジュール1個(K=1)で始まり、後期のDecayフェーズでは3個(K=3)に拡張します。
推論時はMTPモジュールが生成した下書きトークンをメインモデルが1回のフォワードパスで検証する仕組みです。標準の自己回帰的デコーディングと同じ出力品質を保ちながら、処理速度を高められます。
Forge: 長時間エージェント訓練を支えるRLシステム
フロンティア性能を実現するには、モデルに複雑なエージェント行動を学習させる強化学習(RL)が欠かせません。しかし数秒から数時間にわたる実行時間のばらつきがあるエージェント軌跡を効率よく大規模に扱うことは容易ではありません。MiniMax-M2の訓練を支えるのが「Forge」と呼ばれる独自のRLシステムです。
Forgeは大きく二つの仕組みで訓練効率を高めています。一つ目はWindowed FIFO Scheduling(ウィンドウ型スケジューリング)です。生成キューに一定サイズのウィンドウを設け、ウィンドウ内では完了した軌跡を柔軟に取り出せる一方、ウィンドウをまたぐ境界では厳密な順序を維持します。
この設計により、「先の処理が終わるまで後続が始められない」ヘッドオブラインブロッキングを軽減しながら、学習データの分布の一貫性を保てます。
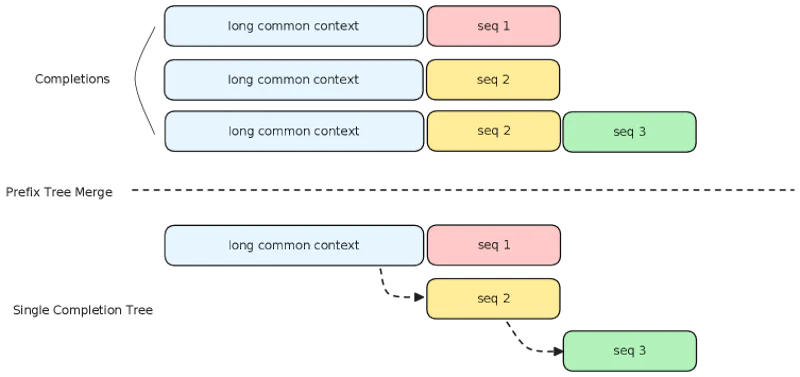
二つ目がPrefix-tree merging(プレフィックスツリーマージ)です。同じバッチ内で共通のプレフィックス(先頭部分)を持つ複数の応答を1つのツリー構造に統合し、共有プレフィックスのフォワードパス計算を1回に圧縮します。計算後にツリーが分岐して個別の応答を処理するため、数学的には独立サンプル訓練と完全に等価でありながら、最大40倍の訓練高速化とメモリ消費の削減を達成しています。
エージェント型データパイプラインと訓練戦略
M2シリーズのもう一つの柱は、エージェント型タスクに特化したデータパイプラインです。ソフトウェアエンジニアリング(SWE)とアプリ開発(AppDev)の2種類のタスクに対し、実行可能なワークスペース内でエージェントが行動した軌跡を大規模に収集・フィルタリングします。実際の実行環境に基づく報酬を使うことで、動作するコードを生成する能力を強化しています。
「Plan-Act-Reflectループ」と呼ばれる思考スタイルも導入されており、タスクの計画・実行・振り返りを繰り返すエージェント的推論を訓練データに反映させています。合成データを活用してフロンティア性能を目指すQUESTのような研究と比べ、実環境での軌跡と実行結果に基づく報酬を重視した点がM2の特徴です。
Self-Evolution: モデルが自身の訓練を改良する
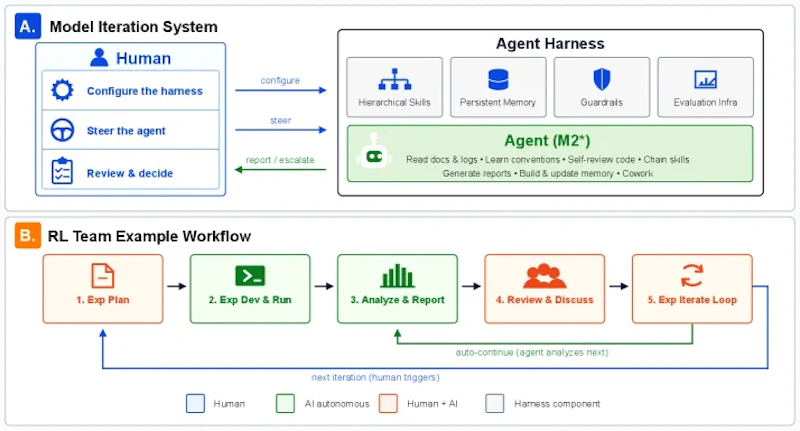
最新チェックポイントのM2.7では、「Self-Evolution(自己進化)」の初期段階が報告されています。モデル自身が訓練スクリプトのバグを検出・修正し、自律的に性能を高めるという取り組みです。
「Model Iteration System」と呼ばれる仕組みの下、M2.7は100ラウンドの反復サイクルを通じて自身のスカフォルド(実行フレームワーク)を修正しました。その結果、社内評価指標で30%の性能向上を達成しています。また日々の反復作業量の30〜50%をモデルが自動的に処理するまでになり、人間エンジニアはより高レベルな判断に集中できるようになりました。
「人間が方向を決め、モデルが実装する」という役割分担のもとで進むこの取り組みは、AIが人間の監督下で自身の能力を改善するサイクルを回し始めた初期段階といえます。
ベンチマーク結果と性能の位置づけ
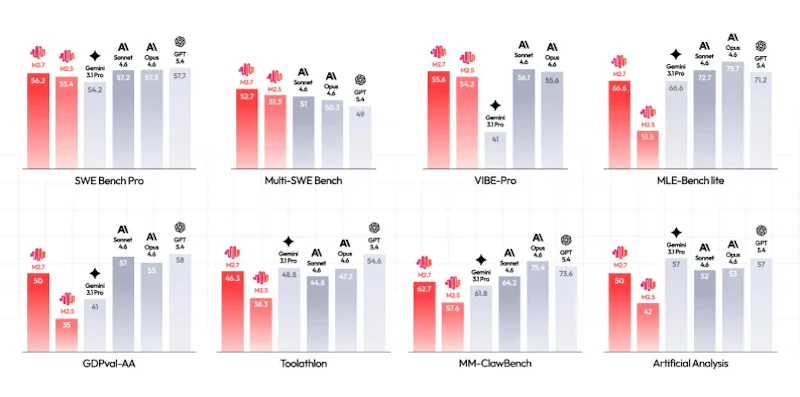
M2.7(活性化パラメータ約9.8B)は、はるかに大規模な計算資源を必要とするモデルと肩を並べる結果を示しています。推論・知識の分野に加え、エージェント型コーディングやエージェント協調作業の評価でも高いスコアを記録しました。各ベンチマークの結果は次のとおりです。
ベンチマーク | 分野 | M2.7 |
|---|---|---|
AIME 2026 | 推論・知識 | 94.2% |
GPQA-Diamond | 推論・知識 | 89.8% |
SWE-bench Multilingual | エージェント型コーディング | 76.5% |
SWE-bench Pro | エージェント型コーディング | 56.2% |
Terminal-Bench 2.0 | エージェント型コーディング | 57.0% |
BrowseComp | エージェント協調作業 | 77.8% |
約10Bの活性化パラメータでこの水準に届いている点が、M2シリーズの設計が狙ったところです。
まとめと評価
M2からM2.5、M2.7と段階的に改善を重ねてきた経緯も本論文では詳しく記録されています。M2.5でのSWE-bench Multilingual・74.1%がM2.7では76.5%に向上するなど、11種類のベンチマーク全てで一貫した改善が確認されており、データパイプラインとRL手法の継続的な改良が着実に成果を上げています。
超疎MoEアーキテクチャの意義は、単なる効率改善にとどまりません。活性化パラメータが少ないほど推論コストが下がり、API提供コストの削減やより多くのユーザーへのサービス拡大につながります。フロンティアAIの性能を「約10倍少ない計算量」で実現するM2のアプローチは、AI研究の効率化という流れに沿った成果といえるでしょう。
一方でモデルの重みは現時点では公開されておらず、第三者による詳細な再現検証には制約があります。また自己進化の仕組みはまだ初期段階であり、どこまで自律的に改善を進められるかは今後の課題です。「最小限の起動で最大の性能を」という設計指針が次世代LLMの研究にどう波及するかが、次に見るべき点になります。
論文情報: "The MiniMax-M2 Series: Mini Activations Unleashing Max Real-World Intelligence"(Aili Chen et al., 2026) arXiv:2605.26494
本記事の図(図1、図2、図6、図8)は解説のため上記論文より引用しています。


