 AI-Papers
- Mistralが総パラメータ1兆500億、アクティブ490億のMoEモデル「Mistral Large 4」を発表し、10月末にオープンウェイトで公開予定
- 100万トークンの文脈長とネイティブな画像入力に対応し、160以上の言語をカバーする
- 脆弱性修正テストで82%を記録。クローズドモデルはタスクを拒否するためスコアがほぼゼロだったとMistralは説明している
Mistral Large 4の概要
フランスのMistralは2026年10月6日、新しい大規模言語モデル「Mistral Large 4」を発表しました。APIプレビュー版は同日からMistral Studioで利用でき、モデルの重みは10月末にオープンウェイトとして公開する予定です。
同社は「中国以外のオープンウェイトモデルで最高性能」と位置づけています。これまで公開重みモデルの上位は中国勢が占める状況が続いており、欧州の事業者が1兆パラメータ級の重みを配布する点が今回の発表の軸になります。
1兆パラメータのMoE構成
Mistral Large 4は総パラメータ1兆500億、推論時のアクティブパラメータ490億のMoE(Mixture-of-Experts、専門家混合)モデルです。MoEは入力ごとに一部の専門家ネットワークだけを使う方式で、総容量を大きく保ったまま推論時の計算量を抑えられます。アクティブ比率は5%未満にとどまります。
構成はネイティブマルチモーダルで、16億パラメータのビジョンエンコーダを内蔵し、画像を外部モジュール経由ではなく直接受け取ります。さらに指示応答と推論を切り替えられるハイブリッド型として設計され、用途に応じて思考の深さを変えられます。文脈長は100万トークン、対応言語はEUの全公用語を含む160以上です。
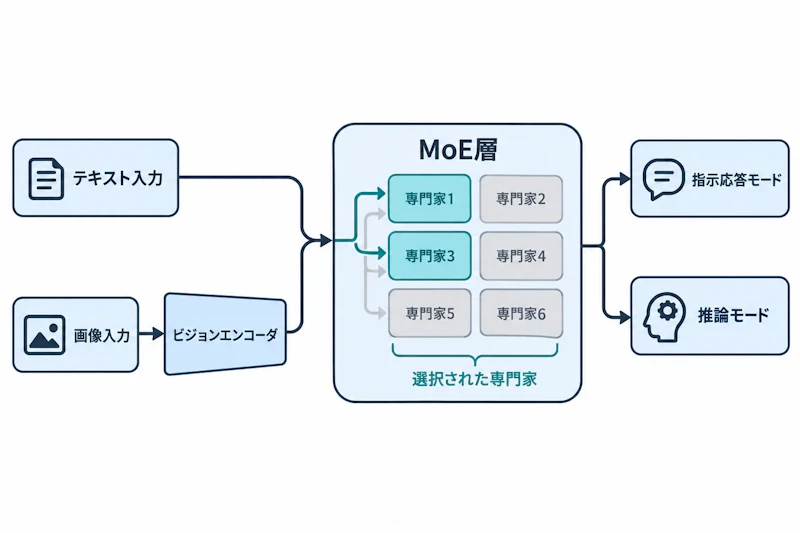
図1のように、画像はビジョンエンコーダを通ってテキストと同じMoE層に入り、出力側で2つのモードに分岐します。学習は欧州のデータセンターに設置したNVIDIA Grace Blackwell 3800基で実施されたとしています。
公表されたベンチマーク
Mistralが示した主な評価結果は次のとおりです。コーディングとエージェント系のタスクが中心で、ソフトウェア開発用途を意識した構成になっています。
ベンチマーク | Mistral Large 4のスコア |
|---|---|
DeepSWE v1.1 | 61.7% |
SWE-Atlas-QnA | 59.4% |
Coding Agent Index | 49.8% |
Terminal-Bench 4 | 28.3% |
サイバーセキュリティ脆弱性テスト | 82% |
Terminal-Bench 4の28.3%は、端末操作を伴う長い手順のタスクが依然として難しいことを示しています。一方でDeepSWE v1.1の61.7%は、リポジトリ単位の修正作業で実用的な水準に近づいた数値といえます。
セキュリティ検証の論点
注意が必要なのはセキュリティ関連のスコアの読み方です。Mistralによれば、脆弱性のパッチ適用を試すテストでMistral Large 4は82%を記録しましたが、Claude Opus 5.5やGPT-6 Astraといったクローズドモデルはタスク自体を拒否したためスコアがほぼゼロになったと説明されています。
つまりこの差は、脆弱性を扱う能力の優劣ではなく、安全方針による応答拒否の違いが大きく反映された結果です。防御側のセキュリティ業務では拒否されないモデルの価値が高い一方で、同じ能力は攻撃的な用途にも向けられます。重みが公開されれば利用側で制約を外せるため、運用側のガードレール設計が重要になります。
提供形態と料金
現時点での提供状況は次のように整理できます。
- Mistral StudioでのAPIプレビュー提供(2026年10月6日開始)
- API料金は入力100万トークンあたり1.36ドル
- 出力は100万トークンあたり4.18ドル
- オープンウェイトの重み公開は2026年10月末を予定
入出力ともに1兆パラメータ級としては低めの価格設定で、アクティブ490億というMoE構成が推論コストの抑制につながっていると見られます。
オープンモデル勢力図への影響
公開重みの大規模MoEは増えつつあり、推論コストを抑えた設計でReflection AIがオープンウェイト「Beam」を公開した例もあります。Mistral Large 4はそこに1兆パラメータ級と100万トークン文脈、画像入力を加えた選択肢となります。
欧州のデータセンターと欧州製モデルという組み合わせは、データ所在や調達の自律性を重視する組織にとって検討材料になります。実際の評価は10月末の重み公開後、第三者による再現と安全性の検証を待つことになります。


