 AI-Papers
- 人手アノテーション不要の合成タスク8,000件のみで、GPT-4oなどフロンティア閉鎖型エージェントと同等以上の深層調査性能を達成
- 統一的なルーブリック木(rubric tree)で自動的に検証可能な報酬を生成し、強化学習を効率化
- モデル・データ・訓練スクリプトをすべて公開しており、研究者が低コストで自前の調査エージェントを構築可能
深層調査エージェントとは何か
従来の検索エンジンは、キーワードに一致するページを返すことが主な役割でした。一方、「深層調査エージェント(deep research agent)」は、複数の情報源を横断して知識を統合し、複雑な質問に対する包括的なレポートを自律的に生成できるシステムです。OpenAIの「Deep Research」やGoogleのGemini Deepなど、大手企業が相次いで提供を開始したことで注目を集めています。
こうしたエージェントの訓練には通常、専門家による大量のアノテーション(正解ラベル付け)や、高品質な人手データが必要とされてきました。コストと時間がかかるこの課題に対して、Jian Xieらの研究チームが提案したのがQUEST(Quality-driven Unified Expert Synthesis Training)です。
QUESTが解決する問題
深層調査エージェントの訓練における最大の障壁は、学習データの品質と量の確保にあります。調査タスクの「正解」を人間が手作業で評価するのは難しく、多様な観点からの採点基準を統一することも困難です。
また、強化学習(RL)でエージェントを改善するには、モデルの出力が正解に近いかどうかを自動的に判定する「報酬関数」が必要になります。しかし、長文レポートの品質を数値で表すことは、単純な数学問題とは異なり一筋縄ではいきません。QUESTはこの問題を「ルーブリック木」という独自の仕組みで解決します。
QUESTの提案手法
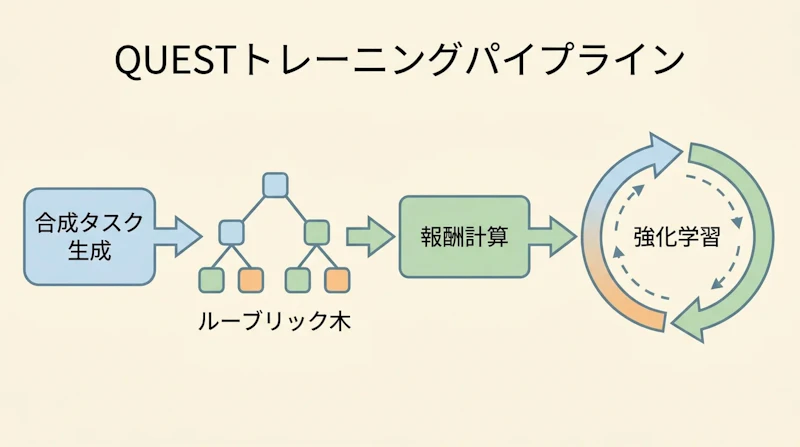
QUESTの中核にあるのは、「統一的なルーブリック木(unified rubric tree)」による合成タスク生成パイプラインです。ルーブリックとは採点基準のことで、ルーブリック木では評価基準を階層的なツリー構造として整理します。たとえば「最終的な結論が正しいか」という大項目の下に、「使用した情報源が信頼できるか」「論拠が一貫しているか」といった小項目が並ぶ形です。
この構造があることで、モデルの出力が正解かどうかを自動的に判定できる仕組みになっています。人間の専門家が個別に採点しなくても、ルーブリック木に照らし合わせるだけで報酬スコアを計算できます。さらに、タスクの難易度や種類をバランスよくコントロールしながら8,000件の合成タスクを生成しているため、偏りの少ない学習が実現されました。
訓練プロセスは3段階で構成されています。
- 中間訓練(intermediate training): 長文のコンテキストを扱う基礎能力を養う
- 教師あり微調整(SFT): 調査タスクの形式を学習する
- 強化学習(RL): ルーブリック木から得られる報酬をもとに性能を継続的に改善する
モデルサイズは2Bから35Bまでのファミリーをカバーしており、利用者は用途に応じた規模を選べます。
8つのベンチマークで示した性能
QUESTはGenie、AssistantBench、BrowsingBenchなど8つの深層調査ベンチマークで評価されました。比較対象はGPT-4oをベースとした閉鎖型エージェントで、商用サービスとして運用されているフロンティアモデルです。
結果として、わずか8,000件の合成タスクのみで訓練されたQUESTが、多くのベンチマークでこれらの閉鎖型エージェントに匹敵するか上回る性能を示しました。人手によるアノテーションをまったく使用せずにこの水準へ到達した点が、この研究の要になります。
uPRM(教師なしプロセス報酬モデル)のように人手ラベル不要で高い性能を引き出す研究が相次いでおり、QUESTはその深層調査領域での実践例といえます。
完全公開がもたらす実用性
QUESTのもうひとつの特徴は、モデルの重み・合成データセット・訓練スクリプトをすべてオープンに公開している点です。研究者は論文を読むだけでなく、実際にコードをダウンロードして自前の深層調査エージェントを再現・改良できます。
フロンティア閉鎖型エージェントのように巨大なインフラや専有データを必要とせず、8,000件の合成データと公開済みの訓練スクリプトだけで同等の性能を引き出せるとすれば、学術機関や中小の開発チームにとって大きな福音となるでしょう。
課題と今後の展望
QUESTの現時点での課題として、ルーブリック木による評価が複雑な主観的判断をすべて捉えきれるわけではない点があります。文体の自然さや文脈理解の深さといった側面はツリー構造の採点基準では数値化しにくく、人間の評価と自動評価の間にズレが生じる可能性があります。
また、8,000件という合成データ数がどの程度まで一般化できるかは、タスクドメインによって変わる可能性があります。研究チームは今後の課題として、より多様なタスク形式への対応や、さらに大きなモデルサイズでの検証を挙げました。
人手アノテーションなしで深層調査エージェントを訓練するというQUESTのアプローチは、今後の自律型AIエージェント研究において有望な方向性を示しています。完全公開という姿勢とあわせて、研究コミュニティへの貢献度は高いといえるでしょう。


