 AI-Papers
- ランダム置換ブロックハダマール(RPBH)変換で活性化分布を正規化し、キャリブレーションデータ不要で全レイヤー・タイムステップに共通コードブックを適用できる
- W2A4では競合手法がほぼノイズに崩壊する中、FLUX.1-schnellでGenEval 0.604を維持し唯一実用的な出力を生成できた
- FLUX.1から動画生成Wan 2.1まで同一レシピで適用可能。コードとプロジェクトページが公開済み
研究の背景
画像生成や動画生成の分野では、FLUX.1やWan 2.1、HunyuanVideoといった高性能な拡散トランスフォーマー(DiT)が相次いで公開されています。しかし、これらのモデルはパラメータ数が膨大で、推論時には高コストのGPUを必要とします。
ポスト学習量子化(Post-Training Quantization、PTQ)は、モデルの重みや演算をより少ないビット数で表現して推論コストを下げる有力な手段です。W4A4(重み4bit・アクティベーション4bit)やさらに圧縮率を高めたW2A4への対応が、実用展開の上で強く求められています。
量子化の壁:活性化の不安定さ
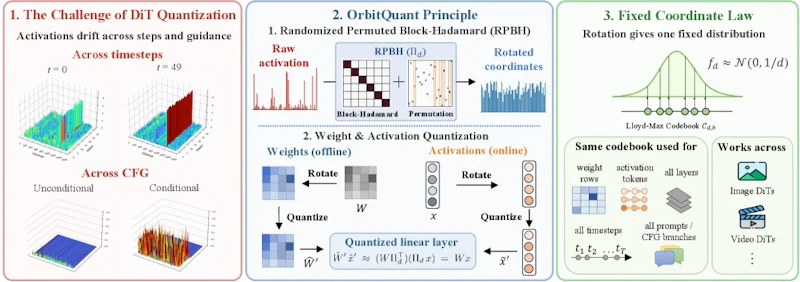
拡散モデルの量子化には独特の難しさがあります。従来のPTQは、モデルに代表的なサンプルデータを流して中間層の出力値(アクティベーション)の統計を取り、スケーリング係数を決める「キャリブレーション」を行います。
しかし拡散モデルでは、アクティベーションの値域を動かす要因が複数あります。タイムステップ(ノイズ除去ステップの番号)やプロンプト(テキスト指示)によって値域は大きく変動し、テキスト条件なしと条件ありを同時処理するClassifier-Free Guidance(CFG)でも分布が変わります。
そのため、一度決めたスケーリング係数がすべての推論状況に通用しません。これが既存手法の精度低下や、新モデルごとの再キャリブレーション負担につながっていました。
RPBH変換:データ不要の正規化
OrbitQuantはこの問題を、「アクティベーションを量子化しやすい分布に変換する」アプローチで解決します。中核となるのが、ランダム置換ブロックハダマール(Randomized Permuted Block-Hadamard、RPBH)変換です。
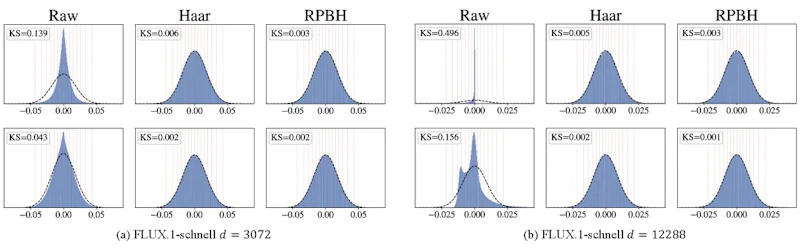
ハダマール変換は信号処理でよく使われる直交変換の一種です。OrbitQuantはこれをブロック単位で適用し、さらにランダムな置換を組み合わせることで、どのようなアクティベーションでも正規分布 N(0, 1/d)(dは次元数)に近い分布へ整形します。
この変換はデータに依存せず、変換行列は固定です。サンプルデータを見て調整する必要がないため、キャリブレーションが不要になります。また変換は重みにあらかじめ「吸収」でき、推論時の追加計算は軽微で済みます。
Lloyd-Maxコードブックの共有
正規分布に整形されたアクティベーションに対し、OrbitQuantはLloyd-Maxアルゴリズム(量子化誤差を最小化する最適な量子化点を求める手法)で事前構築したコードブックを適用します。分布の形状が既知であるため、このコードブックはサンプルを流さずとも計算できます。
その結果、タイムステップ・プロンプト・レイヤーを問わず、また画像生成モデルと動画生成モデルの両方で同一のコードブックを流用できます。新しいモデルに適用する際に再調整が不要な点が、実用上の大きな強みです。
定量・定性の両面で確認された効果
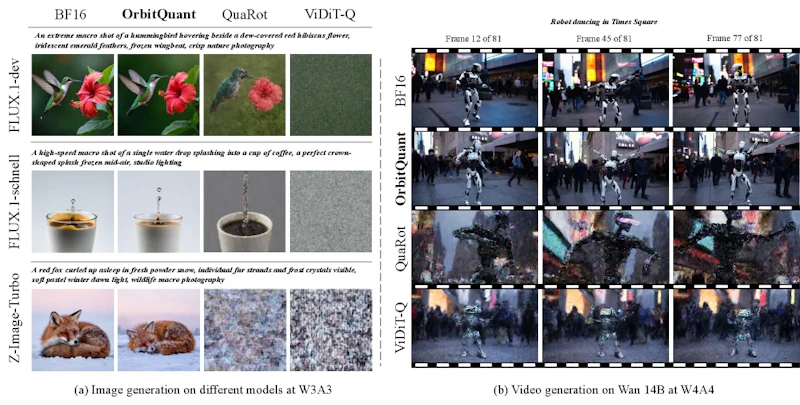
GenEvalベンチマーク(画像生成の品質評価指標)での評価では、FLUX.1-schnellのW4A4でOrbitQuantは0.703を記録しました。これはBF16フルプレシジョン(0.664)をわずかに上回る数値です。FLUX.1-devでは0.633と若干低下しますが、実用的な範囲に収まっています。
さらに厳しいW2A4条件では差が際立ちます。競合手法のQuaRot・SmoothQuant・ViDiT-QはGenEvalスコアがほぼ0.001まで崩壊し、出力がほぼノイズに近い状態へ退化しました。一方OrbitQuantはFLUX.1-schnellで0.604を維持し、唯一実用的な出力を生成できた手法です。主な数値をまとめると次のようになります。
条件 | OrbitQuant | 比較対象 |
|---|---|---|
FLUX.1-schnell W4A4(GenEval) | 0.703 | BF16: 0.664 |
FLUX.1-dev W4A4(GenEval) | 0.633 | - |
FLUX.1-schnell W2A4(GenEval) | 0.604 | QuaRot・SmoothQuant・ViDiT-Q: 約0.001 |
Wan 2.1-1.3B W4A6(VBench) | 24.35% | フルプレシジョン: 24.67% |
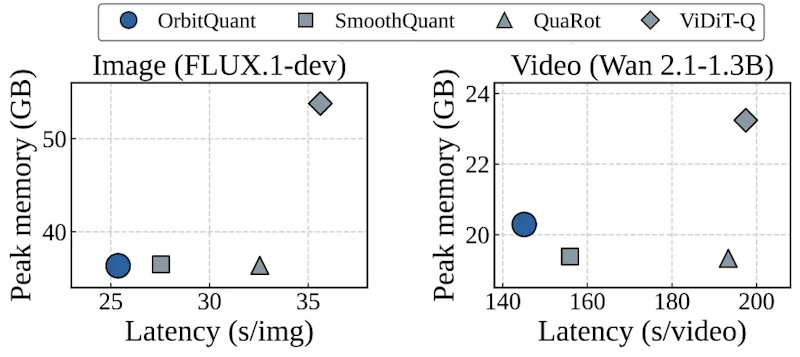
動画生成への転移も確認されています。Wan 2.1-1.3BのW4A6でのVBenchスコアはフルプレシジョンとの差がわずか0.32ポイントにとどまり、画像から動画へ同一のRPBH変換レシピが機能することを示しました。
AdaLNの扱いと圧縮効率
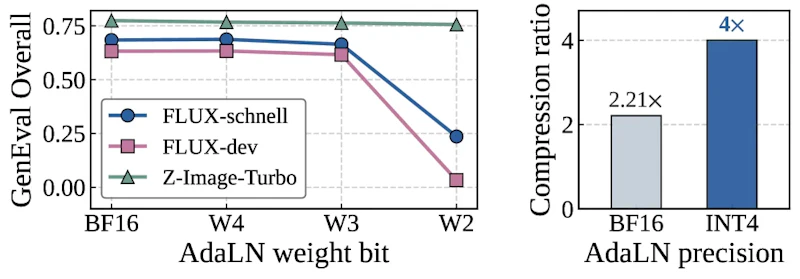
拡散モデルに特有のAdaLN(適応的レイヤー正規化)は量子化の影響を受けやすいコンポーネントです。実験では、AdaLNのアクティベーションをINT4に量子化すると性能が低下することが確認されました。
そのため論文では、主要な注意機構やFFN層をW4A4で量子化しつつ、AdaLNのアクティベーションはBF16のまま保持する設定を推奨しています。この構成でもモデルサイズの2.21倍圧縮が得られ、AdaLNもINT4にすれば4倍圧縮が可能です。
まとめ
OrbitQuantは「キャリブレーションデータ不要」という設計で、拡散トランスフォーマーの量子化における実用上の障壁を取り除きました。FLUX.1・Wan 2.1・HunyuanVideoなど複数のモデルに同一の手順で適用でき、W2A4という超低ビット幅での実用性は他手法には見られない特徴です。
iRDMのような1ステップ推論アプローチと並んで、OrbitQuantはビット幅圧縮の観点から推論効率化を追求する手法として位置づけられます。コードとプロジェクトページは公開済みで、AdaLN量子化の改善やより大規模なモデルへの拡張が次の課題として残されています。
論文情報: "OrbitQuant: Data-Agnostic Quantization for Image and Video Diffusion Transformers"(Donghyun Lee et al., 2026) arXiv:2607.02461
本記事の図(図1〜図5)は解説のため上記論文より引用しています。

