 AI-Papers
- 4Bの軽量オーケストレータが強化学習で複数の専門モデルとスキルを動的に選択し、10ベンチマーク平均70.1%を達成。GPT-5(69.3%)やGemini-2.5-Pro(68.7%)を上回る性能を記録した
- 結果ベースのRLのみで学習し、ステップレベルの教師ラベルが不要。未学習の専門モデルやスキルを追加しても再訓練なしで性能が向上する拡張性を持つ
- コードはGitHub(jinyangwu/Maestro)で公開。巨大な単一モデルに頼らず複数モデルを賢く組み合わせるコスト効率の高いアプローチとして注目されている
研究の背景と課題
マルチモーダルAIの分野では、一つの巨大なモデルがあらゆる問題に対処するアプローチが長らく主流でした。しかし現実には、数学的推論・医療画像解析・チャート読み取りなど、タスクの種類によって強みを持つモデルは異なります。
複数の専門モデルを使い分けることは理論上は効率的ですが、「どのモデルをいつ使うか」を動的に制御する仕組みがなければ効果は限られます。既存のエージェントフレームワークの多くは、単一モデルに固定されたロジックで外部ツールを呼び出す設計になっており、複数モデルの補完的な強みを十分に活かせていませんでした。Maestroはこの課題に正面から取り組んだ研究です。
Maestroの全体設計
Maestroは4Bパラメータのオーケストレータモデルを中心に、複数の凍結された専門モデル(expert models)と二層構造のスキルライブラリを組み合わせるフレームワークです。
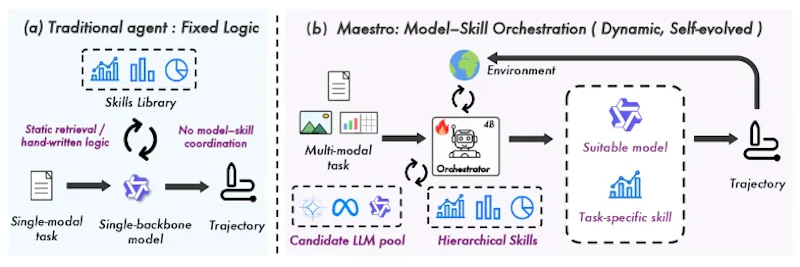
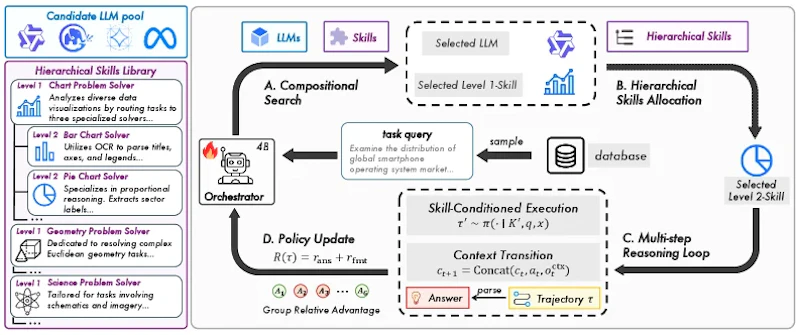
オーケストレータが各推論ステップで行う判断は3つです。どの専門モデルを呼び出すか、そのモデルにどのスキルを適用するか、そして推論をいつ終了するかです。この判断を繰り返すことで、問題ごとに最適なモデルとスキルのアンサンブル(組み合わせ)を構成します。
強化学習による学習方法
Maestroの学習には「結果ベースの強化学習(outcome-based RL)」を採用しています。中間ステップの正解ラベルは一切不要で、最終的な答えの正誤だけをフィードバックとして受け取り、オーケストレータが最適な選択を自動的に学んでいきます。
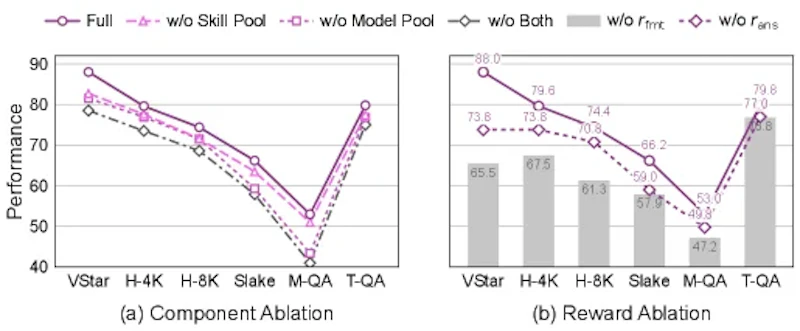
報酬は形式報酬(format reward)と結果報酬(outcome reward)の2種類から構成されます。形式報酬は出力フォーマットの整合性を、結果報酬は最終回答の正確さを測ります。この2種類の報酬を組み合わせることがマルチターンでの安定した学習に不可欠であることは、後述のアブレーション実験でも確認されています。
強化学習を用いた効率的なLLM訓練手法については、RELEXとは?15%の学習ステップでRLVR訓練を完遂するランク1外挿法でも詳しく解説しています。
実験結果と性能比較
Maestroは数学的推論・チャート理解・科学的分析・医療画像解析を含む10の多様なベンチマークで評価されました。平均精度70.1%を達成し、GPT-5(69.3%)およびGemini-2.5-Pro(68.7%)を上回る結果が得られています。
モデル | 10ベンチマーク平均精度 |
|---|---|
Maestro(4B) | 70.1% |
GPT-5 | 69.3% |
Gemini-2.5-Pro | 68.7% |
さらに学習時に含まれていない4つのベンチマーク(分布外テスト)では、新しい専門モデルとスキルを追加した状態で59.5%の精度を達成しました。オーケストレータの再訓練なしにこの性能が得られることは、システムの拡張性の高さを示しています。
アブレーション実験から見える設計の要点
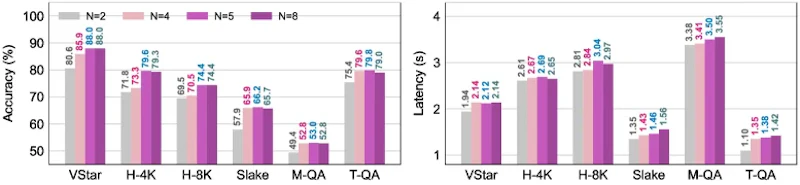
コンポーネントごとの寄与を調べたアブレーション実験では、専門モデルプールとスキルライブラリがそれぞれ独立して性能に貢献し、両者を組み合わせた場合に最高性能が得られることが確認されました。どちらか一方を除いた場合でも性能は低下しており、モデル選択とスキル選択の両方が重要な役割を担っています。
報酬関数に関しても、形式報酬だけでは出力の安定性が増すものの精度が頭打ちになり、結果報酬だけでは学習が不安定になることが示されました。2種類の報酬を組み合わせることが、安定した多段階の推論制御の鍵となっています。
まとめと今後の展望
Maestroが示したのは、4Bという小さなオーケストレータが問題に応じて適切な専門モデルとスキルを選び組み合わせることで、閉源の大型モデルをすべて上回れるという実証です。段階的な教示なしに結果のみで学習できる点、そして未学習モデルへの汎化能力は、実運用上の大きな利点といえます。
コードはGitHub(jinyangwu/Maestro)で公開されており、再現性も確保されています。一方で、評価対象のベンチマークは10種類に限られており、より広いタスク領域での検証やオーケストレータ訓練コストの詳細な分析は今後の課題として残ります。コスト効率を重視しながら高い性能を求めるAIシステムの設計指針として、実用的な価値を持つ研究です。
論文情報: "Maestro: Reinforcement Learning to Orchestrate Hierarchical Model-Skill Ensembles"(Jinyang Wu et al., 2026) arXiv:2605.22177
本記事の図(図1〜図4)は解説のため上記論文より引用しています。


