 AI-Papers
- ベンチマークの一部だけで全体スコアを推定する「ベンチマーク圧縮」の誤差分布が長い裾を持つことを解析的に導出した研究です
- 少数の探査モデルで候補部分集合を選び直すBestRandにより、高誤差リスクを平均50.2%、推定誤差を16.4%削減しました
- 構築コストは競合手法の平均51.3%で済み、分布シフト下でも誤差を21.8%削減しています
研究の背景
大規模言語モデル(Large Language Model、LLM)の評価は年々重くなっています。MMLUやGSM8K、HumanEvalといったベンチマークは数千から数万件の問題を含み、モデルを1つ評価するだけでも相当な推論コストがかかります。モデルの更新頻度が上がるほど、この負担は無視できません。
そこで広く使われているのがベンチマーク圧縮です。全問題のうち一部(例えば20%)だけを選んでモデルを解かせ、その得点から全体の得点を推定します。問題は、どの部分集合を選ぶかで推定の正確さが変わる点にあります。
この論文「Random Is Almost Enough? Stable and Low-Cost Benchmark Compression via BestRand」(arXiv:2611.00883)は、まず単純なランダム抽出がどのくらい当たるのかを理論的に解き、その上で弱点だけを補う手法を提案しています。
ランダム抽出の弱点
著者らはモデルごとの推定誤差ベクトルが近似的に多変量正規分布に従うと仮定し、平均絶対誤差(MAE)の分布を解析的に近似しました。得られた結論は直感に反します。大半の部分集合は誤差が小さく、ランダム抽出でも高い確率でうまくいくのです。
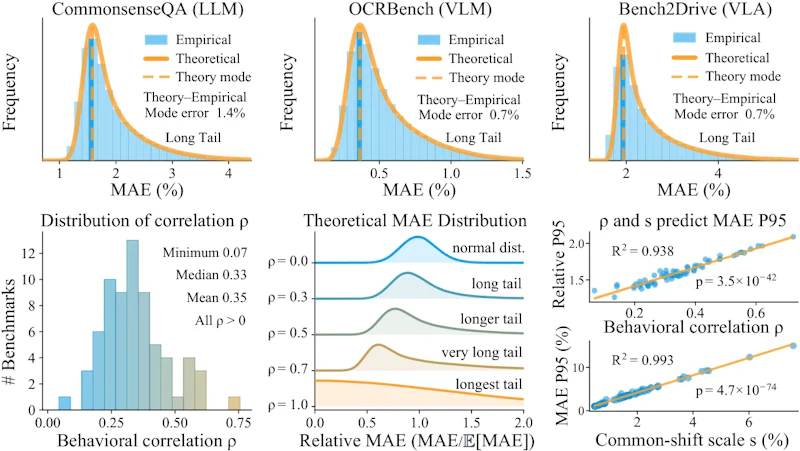
ただし分布には長い裾があり、ごく一部の部分集合が極端に大きな誤差を生みます。この裾の長さを支配するのが、モデル間の誤差の平均相関 ρ です。ρ が正だと、評価するモデル数を増やしても誤差の「共通ずれ」成分は消えません。言い換えると、多数のモデルを並べて平均化しても不安定さは残ります。
図1に示すように、代表的なLLM、視覚言語モデル(VLM)、Vision-Language-Action(VLA)のベンチマークで実測したMAEの分布と最頻値は、理論の予測とよく一致しました。ρ と共通ずれの尺度 s が、実測のMAEの95パーセンタイル(高誤差リスクの指標)をよく説明することも確認されています。
BestRandの仕組み
理論から導かれる処方はシンプルです。ランダム抽出をやめるのではなく、ランダムに引いた候補の中から「共通ずれが小さそうなもの」を選び直せばよい、ということになります。BestRandはこの発想を4つの手順で実装しています。
- 目標サイズの数倍の問題をランダムに抽出し、候補プールとする
- 少数の探査モデル(既定は5個)を候補プールだけで評価し、平均スコアを基準値とする
- プールから目標サイズの部分集合を複数(既定は128個)引き、基準値とのずれを測る
- ずれが最小の部分集合を採用し、本番の評価対象モデルはそこだけで評価する
探査モデルを動かすのは候補プールに限られるため、構築コストが抑えられます。履歴データから重みを学習する手法と違い、過去のモデル応答の蓄積も必要ありません。L1、L2、L∞のどのノルムでずれを測っても結果に大差はなく、探査モデルの選び方も一様抽出とランダム抽出で差は出ませんでした。ただし低スコアのモデルだけを探査に使うと性能は落ちます。
実験結果
検証はテキスト44件、マルチモーダル16件、エージェント10件の計70ベンチマークで行われ、保持率は2%から50%までの6水準を試しています。比較対象はRandom、SparseEval、Anchor Points、TinyBenchmarks、ZipBenchです。RandomとBestRandは1万シードで評価しているため、裾の挙動まで追えています。
手法 | テキスト | マルチモーダル | エージェント | 分布シフト時 |
|---|---|---|---|---|
BestRand | 1.73 | 1.71 | 3.14 | 1.69 |
Random | 2.11 | 1.96 | 3.65 | 1.95 |
ZipBench | 2.02 | 1.99 | 3.90 | 2.19 |
TinyBenchmarks | 2.26 | 2.11 | 3.80 | 2.36 |
上の数値は保持率20%でのMAE(低いほど良い)と、スコア帯・モデルファミリ・時系列のシフトを含む分布外設定での平均MAEです。BestRandは全設定で最小の誤差を記録し、分布外では平均21.8%の改善となりました。履歴データを学習する手法はAnchor Pointsが7.11、SparseEval(線形)が22.07と大きく崩れ、分布外ではRandomにも劣っています。
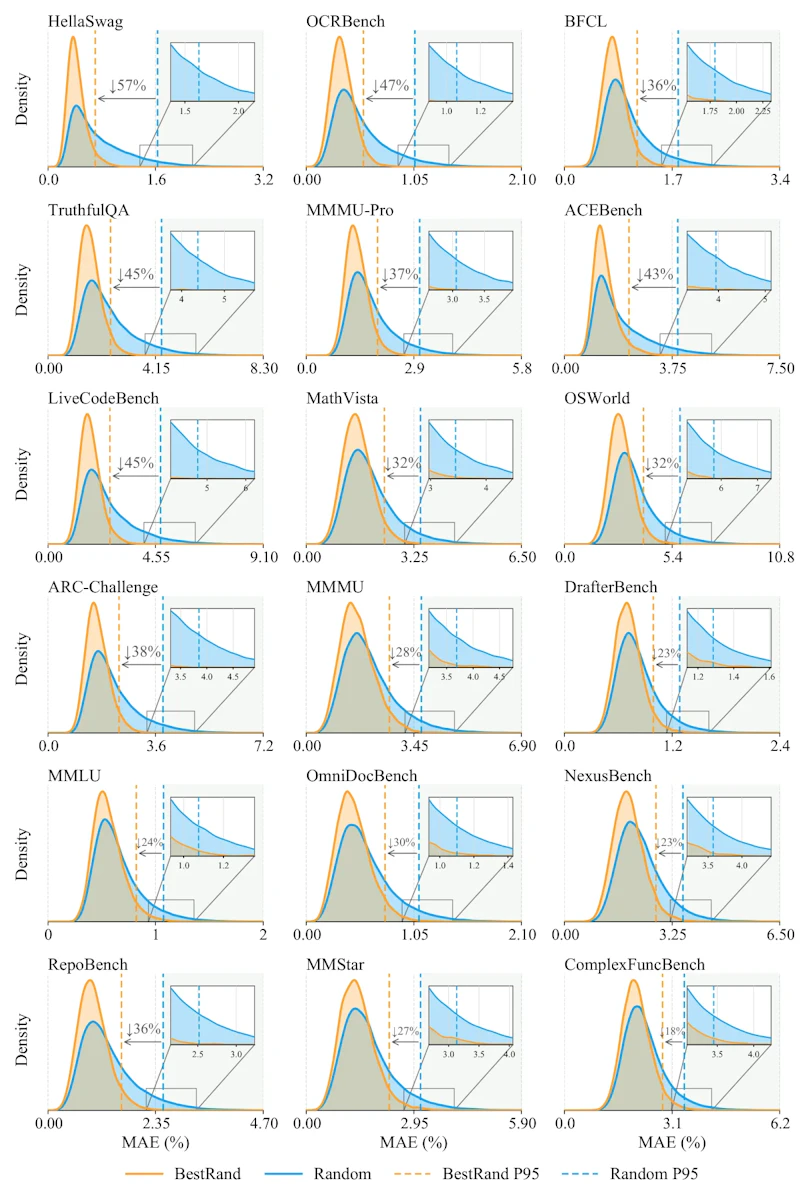
図8は18のベンチマークにおけるMAE分布の比較です。BestRandは誤差をゼロ付近に集め、Randomに見られる高誤差の外れ値を抑えています。狙いどおり、平均を押し下げるより裾を切る効果が出ていると言えます。
自動運転のVLA評価にも拡張されており、Bench2Driveで65%削減時の平均誤差はRandomの2.84に対しBestRandが2.46、評価指標を4つ使う構成では2.00まで下がりました。NEO-VLAのようなロボット制御モデルの評価は実行コストが特に高いため、こうした領域での圧縮は実利が大きい部分です。
課題と今後の展望
著者らは限界も明示しています。BestRandは推定誤差をゼロにはできず、最終的な評価では可能な限りベンチマーク全体のスコアを報告すべきだとしています。探査モデルの推論コストもゼロではなく、候補プール分の計算は必要です。
理論面でも、誤差ベクトルの正規性や項目レベルの仮定は厳密な記述ではなく有用な近似として位置づけられており、有限プールでの選択に収縮の保証があるわけでもありません。それでも、ランダム抽出がなぜ「ほぼ十分」なのかを定量的に説明し、残る不安定さだけを低コストで取り除くという設計は実務に乗せやすい形をしています。
コードとデータは再現性のために公開予定とされています。評価コストの増大はモデル開発の現場で共通する悩みであり、保持率を自分で選んで裾のリスクを見積もれる枠組みが整えば、小規模なチームでも信頼できる評価を回しやすくなるでしょう。
論文情報: "Random Is Almost Enough? Stable and Low-Cost Benchmark Compression via BestRand"(George Ling et al., 2026) arXiv:2611.00883
本記事の図(図1、図8)は解説のため上記論文より引用しています。


