 AI-Papers
- GraphRAGは文書から知識グラフとコミュニティ要約を先に作り、コーパス全体を見渡す質問に答えるRAG手法です
- Local、Global、DRIFT、Basicの4モードがあり、検索の起点と範囲、そしてコストが大きく変わります
- GraphRAG-Benchでは精度の改善幅が1〜3ポイント程度で、数学や多肢選択では通常のRAGに劣る手法もありました
GraphRAGとは何か
GraphRAG は Microsoft Research が公開しているオープンソースの RAG(Retrieval-Augmented Generation: 検索拡張生成)実装で、公式ドキュメントでは「RAG に対する構造化・階層化されたアプローチ」と説明されています。
通常の RAG は、文書を数百から千トークン程度のチャンクに割り、ベクトル化して保存します。質問が来たら意味の近いチャンクを上位 k 件取り出し、そのままプロンプトに貼って答えさせる仕組みです。
GraphRAG が加えるのは、その手前の「読みながら整理する」工程です。文書からエンティティ(人物、組織、概念などの個別の対象)と、エンティティ同士の関係を抽出して知識グラフを作り、さらに関係の濃いエンティティの集まりごとに要約レポートを書き溜めておきます。検索の対象が、生のテキスト断片から、あらかじめ構造化された知識に置き換わるのが本質的な違いです。
通常のRAGが苦手な質問
公式ドキュメントは、ベクトル類似度検索が苦手な質問を 2 種類挙げています。1 つは、共通の属性をたどって散らばった情報をつなぎ、新しい知見を導くこと。もう 1 つは、大量の文書や長い文書の全体にわたる意味的な概念を総合的に理解することです。
たとえば「この議事録群で繰り返し議題に上がったリスクは何か」という質問を考えてみます。ベクトル検索は「リスク」という語に似たチャンクを 5 件返すだけで、全体にどう分布しているかは答えられません。上位 k 件に入らなかった大多数の文書は、最初から視界の外にあります。
元論文「From Local to Global: A Graph RAG Approach to Query-Focused Summarization」は、こうした問いを検索タスクではなく QFS(Query-Focused Summarization: クエリ志向要約)タスクとして位置づけました。そして 100 万トークン規模のデータセットに対する全体把握型の質問で、従来の RAG より回答の包括性と多様性が大きく向上したと報告しています。
インデックス作成の4段階
GraphRAG のインデックス作成は、図1 のように大きく 4 段階で進みます。
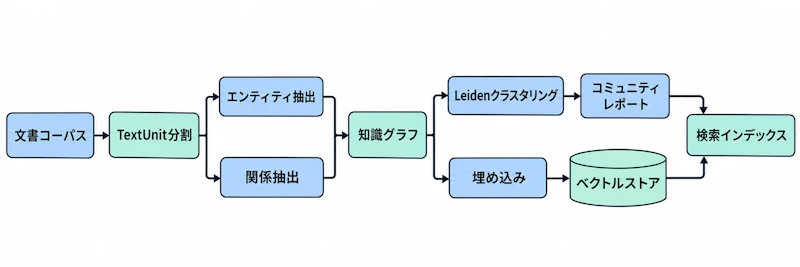
まず入力コーパスを TextUnit という分析単位に分割します。これは通常の RAG のチャンクに相当しますが、出力で引用元を示す細かい参照先としても使われます。
次に各 TextUnit から Large Language Model(LLM)がエンティティ、関係、主要な主張(claims)を抽出します。ここで知識グラフの骨格ができます。続いて Leiden 法でグラフを階層的にクラスタリングし、最後に各コミュニティの要約レポートを下位から上位へ順に生成していきます。
Leidenクラスタリングの役割
Leiden 法は、グラフの中で結びつきの強いノードのまとまり(コミュニティ)を見つけるアルゴリズムです。GraphRAG はこれを階層的に適用するため、数個のエンティティからなる細かい集まりと、コーパス全体のテーマに近い大きな集まりが、同時に手に入ります。
この階層があることで、質問の粒度に合わせて参照先を選べます。特定の人物について聞かれたら下位コミュニティ、全体傾向を聞かれたら上位コミュニティのレポートを使う、という切り替えが成立するわけです。
4つの検索モードの違い
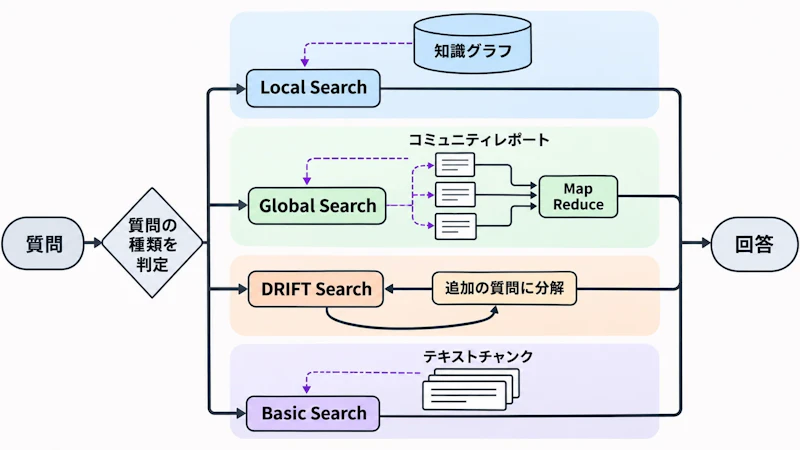
GraphRAG は作ったインデックスに対して 4 つの問い方を用意しています。導入時に最も誤解されやすいのがこの部分で、モードを間違えると「グラフを作ったのに精度が上がらない」という結果になります。
モード | 検索対象 | 得意な質問 | コスト |
|---|---|---|---|
Local Search | 知識グラフ + テキストチャンク | 特定のエンティティに関する質問 | 中 |
Global Search | コミュニティレポート全体 | データセット全体の傾向やテーマ | 高い |
DRIFT Search | コミュニティ情報 + Local Search | Local より広い範囲の探索 | 中〜高 |
Basic Search | テキストチャンク(ベクトル検索) | 単純な事実検索、比較用ベースライン | 低い |
Global Search は全コミュニティレポートを map-reduce 方式で処理するため、公式ドキュメントでも「リソースを多く使う方式」と明記されています。全体を俯瞰する質問にはこれが必要ですが、エンティティ 1 つを調べる質問に使うのは無駄です。
DRIFT Search は Local Search の拡張版で、コミュニティの情報を手がかりに元の質問をフォローアップ質問へ分解し、探索の起点を広げます。一方 Basic Search は通常のベクトル RAG そのもので、比較のベースラインとして最初に回しておく価値があります。
GraphRAGが負けるケース
導入判断で欠かせないのが、2025 年に公開されたベンチマーク GraphRAG-Bench の結果です。16 分野、教科書 20 冊(約 700 万語)から作った 1,018 問に対して、9 種類の GraphRAG 手法を評価しています。LLM は GPT-4o-mini、top-k は 5、チャンクサイズは 1,200 トークンに統一した条件です。
手法 | 生成精度(平均) | 推論スコア R |
|---|---|---|
RAPTOR | 73.58 | 60.81 |
HippoRAG | 72.64 | 60.90 |
GraphRAG | 72.50 | 59.43 |
TF-IDF(通常のRAG) | 71.71 | - |
BM25(通常のRAG) | 71.66 | 59.18 |
LightRAG | 71.22 | - |
GPT-4o-mini(検索なし) | 70.68 | 55.45 |
G-Retriever | 69.84 | - |
DALK | 69.30 | - |
読み取れることは 3 つあります。第 1 に、GraphRAG は BM25 などの通常の RAG を上回りますが、差は 1 ポイント弱です。論文全体を通じても改善幅は 1〜3 ポイント程度で、試行ごとの分散や信頼区間は示されていません。
第 2 に、DALK と G-Retriever は検索なしのベースラインすら下回りました。論文は、構造情報に依存しすぎて意味内容が損なわれ、ノイズが増えたためだと分析しています。LightRAG も TF-IDF や BM25 を下回っています。グラフにすれば勝てるわけではない、ということです。
第 3 に、分野と質問形式で向き不向きが明確に出ました。数学分野ではすべての GraphRAG 手法がベースラインより精度を落としています。記号的な計算が必要な問題に、検索した説明文が噛み合わないためです。質問形式では真偽判定と自由記述で改善が見られ、多肢選択では検索ノイズが判断を妨げて精度が下がりました。
構築コストをどう抑えるか
もう 1 つの現実的な制約がコストです。GraphRAG-Bench の計測では、GraphRAG のグラフ構築に約 7,993 万トークンと約 11,181 秒を要しました。LightRAG は約 8,391 万トークンでさらに多くかかっています。検索時間も、GraphRAG が平均約 44.87 秒、KGP が約 89.38 秒に対し、RAPTOR は約 0.02 秒です。
公式ドキュメントは、グラフ抽出がインデックス作成コストの約 75% を占めると見積もっています。そこで用意されているのが FastGraphRAG で、エンティティ抽出を LLM から NLTK や spaCy による名詞句抽出に置き換え、関係は同一チャンク内の共起で定義します。`graphrag index --method fast` で切り替えられますが、グラフはノイズが多くなるため、主に Global Search による全体要約を狙う場合向きです。
さらに踏み込んだのが LazyGraphRAG です。LLM の利用をクエリ時まで遅らせる設計で、インデックス作成コストは完全な GraphRAG の 0.1%、ベクトル RAG と同等まで下がると報告されています。Global 系のクエリでは、GraphRAG の Global Search と同程度の品質を 700 倍以上低いクエリコストで達成したとされます。評価は AP ニュース 5,590 件に対する合成クエリ 100 件で行われたものです。抽出処理を自前の環境で回してトークン課金を避ける設計も現実的で、その場合はオープンソースLLM比較2026で挙げたような、ライセンスと GPU 要件を基準にしたモデル選定が判断材料になります。
導入を判断する3つの問い
ここまでの材料を踏まえると、GraphRAG を採用すべきかは次の問いで整理できます。
- 答えたい質問に「全体で」「共通して」「傾向として」が含まれるか
- 答えが 1 つの文書に書かれておらず、複数文書の横断が必要か
- インデックス構築の初期コストと、文書更新時の再構築を許容できるか
3 つすべてが「はい」なら、Global Search を主眼にした GraphRAG が効きます。一方で、質問が特定の事実を引くだけのもの、計算や記号処理が中心のもの、文書が頻繁に差し替わるものなら、通常のベクトル RAG のままチャンク設計やリランカーを改善するほうが費用対効果は高いでしょう。
実務的には、まず Basic Search で通常の RAG と同じ条件のベースラインを取り、代表的な質問 20 問ほどで Local と Global を比較するのが安全な進め方です。公式ドキュメント自身も、最良の結果にはプロンプトのチューニングが必要だと述べています。グラフを作ること自体が目的になると、構築コストだけ払って精度が動かない、という事態になりかねません。


