AI-Papers
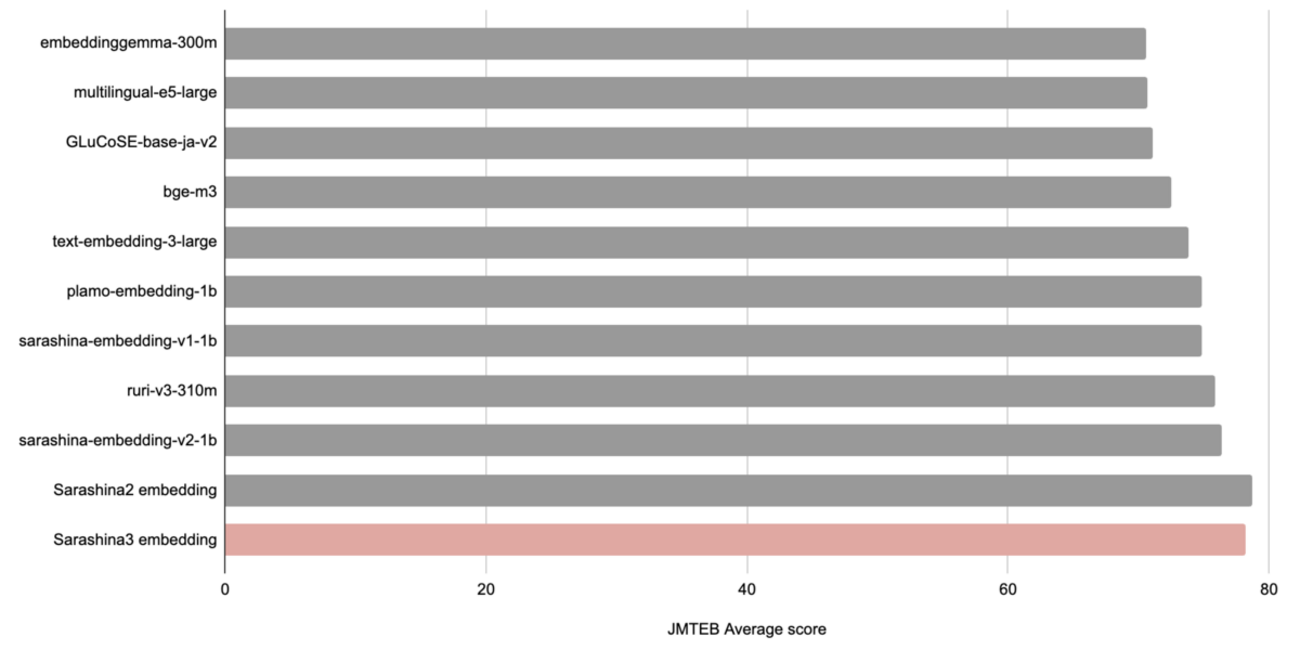
- 日本語特化の埋め込みモデルは Sarashina3 embedding が JMTEB 平均 78.22 で先行し、ローカル運用なら ruri-v3-310m が軽量さと精度のバランスで有力です
- Matryoshka 表現学習(MRL)に対応したモデルは次元を削ってもスコアが落ちにくく、ベクトルDBのストレージと検索コストを数分の1にできます
- ライセンス、コンテキスト長、タスク指示の有無、料金の4点を押さえた上で、最後は自社データの Recall@k で決めるのが実務的な選び方です
埋め込みモデルとは何か
埋め込みモデル(Embedding Model)は、文章を数百〜数千個の数値の並び、つまりベクトルに変換するモデルです。意味の近い文章は近いベクトルになるように学習されているため、「ベクトルの距離を測る」だけで意味の近さを比べられます。
RAG(Retrieval-Augmented Generation: 検索拡張生成)では、この性質を使って質問に関連する社内文書を引っ張ってきます。つまり埋め込みモデルの精度が低いと、どれほど優秀な大規模言語モデルを後ろに置いても、そもそも必要な文書が手元に届きません。RAG の品質は検索段階で上限が決まるため、埋め込みモデルの選定は後回しにできない工程です。
2026 年現在、日本語で使える選択肢は大きく2系統に分かれます。日本語データで集中的に学習された国産モデル群と、100言語以上をまとめて扱う多言語 API 群です。どちらが正解かは用途によって変わるので、まず比較の軸を揃えておきましょう。
JMTEBで何がわかるか
日本語埋め込みモデルの横並び比較に使われるのが JMTEB(Japanese Massive Text Embedding Benchmark)です。SB Intuitions が公開しているベンチマークで、v2.0 では国際的な MTEB(Massive Text Embedding Benchmark)のフレームワークと統合され、5種類のタスクにまたがる28個の日本語データセットで評価します。
- Classification(分類): 7データセット。Amazon レビューや WRIME など
- Clustering(クラスタリング): 3データセット。Livedoor ニュースなど
- STS(意味的類似度): 2データセット。JSTS、JSICK
- Retrieval(検索): 11データセット。JAQKET、JaGovFaqs、MIRACL など
- Reranking(再ランキング): 5データセット。JQaRA、JaCWIR など
RAG 用途で見るべきは平均スコアではなく Retrieval と Reranking の数値です。分類やクラスタリングが得意なモデルが検索でも強いとは限らないからです。
ここで一つ注意点があります。JMTEB はバージョンによってタスク構成が変わるため、公開元の違う表の数値をそのまま並べて比較してはいけません。たとえば plamo-embedding-1b は Hugging Face のモデルカードで平均 76.10 と記載されていますが、これは PairClassification を含む構成での値です。SB Intuitions が v1.4.0 で測り直した表では 74.85 になります。比較するなら同一バージョン・同一タスク構成の表を1枚選ぶのが前提です。なお全データセット版は重いので、コーパスを縮小した JMTEB-lite(約5倍高速)も用意されています。
日本語特化モデルの比較
以下は SB Intuitions が JMTEB v1.4.0 で統一評価した日本語モデルの結果です。同一条件なので、この表の中での比較は妥当です。
モデル | 次元 | 平均 | Retrieval | Reranking | 提供形態 |
|---|---|---|---|---|---|
Sarashina3 embedding | 1536 | 78.22 | 79.30 | 88.40 | 商用API |
Sarashina2 embedding | 2560 | 78.69 | 79.23 | 86.86 | 商用API |
sarashina-embedding-v2-1b | 1792 | 76.38 | 76.77 | 86.28 | ローカル(非商用) |
ruri-v3-310m | 768 | 75.85 | 76.44 | 85.84 | ローカル(Apache-2.0) |
plamo-embedding-1b | 2048 | 74.85 | 75.14 | 85.05 | ローカル(Apache-2.0) |
Sarashina3 embedding
2026年7月に発表された指示認識型(instruction-aware)モデルです。クエリにタスク固有の指示文を付けると、そのタスク向けのベクトルを返します。対応タスクは RETRIEVAL_DOCUMENT、RETRIEVAL_QUERY、SEMANTIC_SIMILARITY、QUESTION_ANSWERING、FACT_VERIFICATION、CLASSIFICATION、CLUSTERING の7種類です。
興味深いのは学習方法です。検索特化モデル(平均 77.62)と分類特化モデル(平均 77.81)を別々に学習し、DARE-TIES という手法でマージして 78.22 に到達しています。DARE は差分パラメータの大部分を落として残りを再スケールする手法、TIES-Merging はパラメータの大きさと符号を見てタスク間の干渉を抑える手法です。前世代の Sarashina2 embedding(2560次元)に対し、次元を40%削りながら Retrieval と Reranking では上回っているのがこのモデルの要点です。逆に Clustering は 51.56 対 56.94 で Sarashina2 のほうが高く、平均値だけ見ると Sarashina2 が勝ちます。RAG なら Sarashina3、文書の自動分類やトピック抽出が主目的なら Sarashina2 という読み方になります。
ruri-v3 と plamo-embedding-1b
自前ホストが条件なら、ruri-v3 シリーズ(名古屋大学)が現実的な第一候補です。30m / 70m / 130m / 310m の4サイズがあり、最大の 310m でも 315M パラメータ、768次元に収まります。Apache License 2.0 で商用利用可、最大 8192 トークン、SentencePiece のみでトークナイズするため MeCab などの外部分かち書きツールが不要という扱いやすさも利点です。「検索クエリ: 」「検索文書: 」「トピック: 」とプレフィックスを付け替える「1+3」方式で、用途ごとにベクトルを切り替えます。
plamo-embedding-1b(Preferred Networks)は 1B パラメータ、2048次元、Apache License 2.0 です。コンテキスト長が 4096 トークンで ruri-v3 より短く、API も encode_query と encode_document に分かれたシンプルな構成です。sarashina-embedding-v2-1b は 8192 トークンまで扱えてスコアも高いのですが、ライセンスが非商用のため、商用プロダクトでは別途問い合わせが必要です。この点は見落としやすい落とし穴です。
多言語API勢の比較
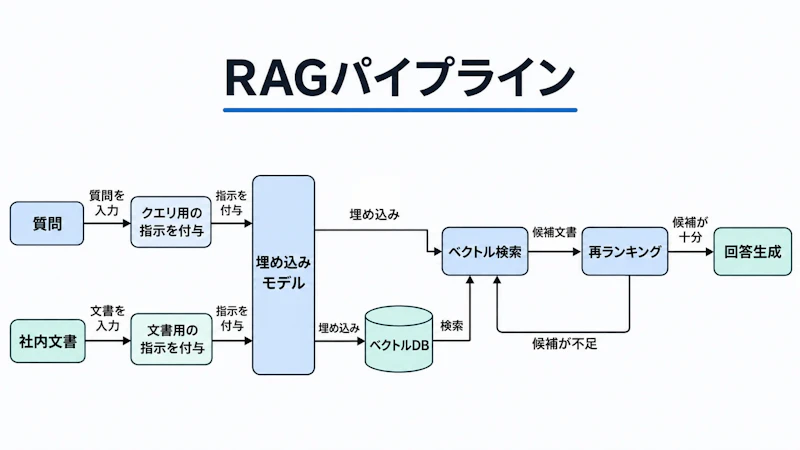
図1のようにクエリ側と文書側で指示を付け替える設計は、Gemini Embedding や Qwen3-Embedding でも共通しています。国産モデルだけが特別な作りをしているわけではありません。
モデル | 既定次元 | 次元削減 | 料金(100万トークン) | 運用 |
|---|---|---|---|---|
gemini-embedding-2 | 3072 | 128〜3072 | $0.20(Batch $0.10) | API |
gemini-embedding-001 | 3072 | 128〜3072 | $0.15(Batch $0.075) | API |
text-embedding-3-large | 3072 | dimensions指定 | 約$0.13 | API |
text-embedding-3-small | 1536 | dimensions指定 | 約$0.02 | API |
Qwen3-Embedding-0.6B | 1024 | 32〜1024 | 自前GPUコスト | ローカル |
Qwen3-Embedding-8B | 4096 | MRL対応 | 自前GPUコスト | ローカル |
gemini-embedding-2 はテキスト・画像・動画・音声・文書を同一のベクトル空間に写すマルチモーダル対応版です。入力上限は全モダリティ共通で 8192 トークン、切り詰めた次元は自動で正規化されます。一方 gemini-embedding-001 はテキスト専用で上限 2048 トークン、3072 以外の次元を使うときは自分で正規化する必要があります。タスク指定の方法も変わっており、001 が task_type パラメータを使うのに対し、2 は task: search result | query: ... のようにプロンプト内へ書き込みます。既存コードの移植時に引っかかりやすい差分です。
Qwen3-Embedding は 0.6B / 4B / 8B の3サイズで、コンテキスト長 32K、100言語以上対応、Apache License 2.0 です。MTEB 多言語の Mean (Task) は 0.6B が 64.33、4B が 69.45、8B が 70.58 と、サイズ差がそのままスコア差に出ます。長文をまとめて埋め込みたい場合や、日本語以外も混在するコーパスでは強い候補になります。
ただし日本語の検索精度では国産勢に届かない場面があります。SB Intuitions の定性評価では、チリとペルーの国境に関するクエリで正解文書が全880件中、Sarashina3 が6位、plamo-embedding-1b が12位、ruri-v3-310m が16位に対し、Qwen3-Embedding-0.6B は58位でした。開発元自身による評価という点は差し引くべきですが、最小サイズの多言語モデルを日本語コーパスにそのまま当てると苦戦しうる、という示唆としては妥当でしょう。
Matryoshkaで次元を削る
Matryoshka Representation Learning(MRL)は、1本のベクトルの先頭部分だけを取り出しても意味を保つように学習する手法です。入れ子人形のように、3072次元のベクトルの先頭 256 次元を切り出してもそれ単体で使えます。Sarashina3 embedding は 1536 / 1024 / 512 / 256 / 128 を対象に MRL 学習しており、次元削減時の劣化が小さくなっています。
次元 | Sarashina3 | Sarashina2 | 差 |
|---|---|---|---|
1536 | 78.22 | — | — |
1024 | 78.08 | 77.19 | +0.89 |
768 | 78.00 | 76.81 | +1.19 |
512 | 77.60 | 75.33 | +2.27 |
256 | 75.72 | 72.65 | +3.07 |
128 | 70.91 | 68.30 | +2.61 |
64 | 61.50 | 57.99 | +3.51 |
この表はコスト設計に直結します。100万件の文書を float32 で保存すると、1536次元なら約6.1GB、256次元なら約1.0GB です。しかも 256 次元の 75.72 は、768次元の ruri-v3-310m(75.85)とほぼ同じ水準です。精度 2.5 ポイントの低下でストレージと検索計算量を6分の1にできるなら、十分に検討価値のあるトレードオフです。
目安としては、512 次元までは劣化が 1 ポイント以内に収まるので安全圏、256 次元は許容範囲、128 次元以下は落差が大きいので慎重に、という線引きになります。なお 64 次元まで削ると 61.50 まで落ち、RAG の検索品質としては実用的とは言いにくい領域です。実運用では、低次元で粗く絞り込んでから高次元で精査する2段構えも組めます。
APIとローカルの選択
スコア表だけ見て決められないのが、運用形態の問題です。
観点 | API 利用 | ローカル運用 |
|---|---|---|
初期コスト | ほぼゼロ | GPU 調達・環境構築が必要 |
継続コスト | トークン従量課金 | インフラ固定費 |
データ所在 | 外部送信が発生 | 自社内で完結 |
モデル固定 | 提供終了・更新の影響を受ける | バージョンを固定できる |
大量バッチ | レート制限に当たりやすい | 自前の計算資源次第 |
再インデックス | 件数ぶん課金される | 追加課金なし |
見落としがちなのが最後の再インデックスです。埋め込みモデルを変えると、既存のベクトルは全て作り直しになります。数百万件規模のコーパスで API を使っていると、モデル更新のたびに相応の費用が発生します。この点ではローカル運用の固定費のほうが読みやすい、という判断もあり得ます。
また API 側のモデル提供期間も考慮点です。Sarashina3 シリーズは 2026年10月から Sarashina サービスの無償ベータ版で試せるようになりましたが、提供終了時期は未定とされ、入力データが改善に使われる場合があることとレート制限も明記されています。Gemini も無料枠では利用データが製品改善に使われる一方、有料枠では使われないと区別されています。機密文書を扱うなら、ベータや無料枠は検証用に限るのが無難です。
用途別の選び方
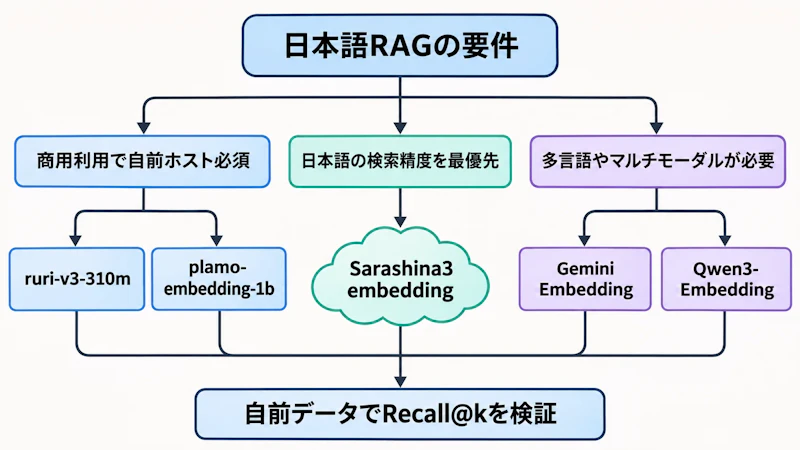
図2の分岐を言葉にすると、次のような整理になります。
- 日本語の社内文書検索で精度優先: Sarashina3 embedding または ruri-v3-310m
- 商用プロダクトで自前ホスト必須: ruri-v3-310m、plamo-embedding-1b
- GPU が貧弱・CPU 推論したい: ruri-v3-30m / 70m(256〜384次元)
- 多言語コーパスや長文が中心: Qwen3-Embedding-4B 以上
- 画像や音声も同じ空間で検索: gemini-embedding-2
- コスト最優先で日本語は妥協可: text-embedding-3-small
なお検索精度を上げる手段は埋め込みモデルの差し替えだけではありません。キーワード検索との併用(ハイブリッド検索)や再ランキングモデルの追加、文書の分割単位の見直しのほうが効く場面も多いです。文書間の関係性が重要なら GraphRAGとは?仕組み・通常のRAGとの違い・導入すべきケースをわかりやすく解説 で紹介した構成も検討の余地があります。
自前データで最終判断
ベンチマークはあくまで一般的な傾向です。JMTEB の検索データセットは Wikipedia や行政 FAQ、学術論文が中心で、自社の契約書や製品マニュアル、問い合わせ履歴とは語彙の分布がまるで違います。最後は自分のデータで測るほかありません。
必要なのは、質問と正解文書のペア 50〜100 組程度の小さな評価セットです。これだけあれば Recall@k の比較ができます。
import numpy as np
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("cl-nagoya/ruri-v3-310m")

# 文書側とクエリ側でプレフィックスを付け替える
docs = ["検索文書: " + d for d in documents]
queries = ["検索クエリ: " + q for q in questions]

doc_vecs = model.encode(docs, normalize_embeddings=True)
q_vecs = model.encode(queries, normalize_embeddings=True)

scores = q_vecs @ doc_vecs.T          # コサイン類似度
topk = np.argsort(-scores, axis=1)[:, :5]

hit = sum(gold[i] in topk[i] for i in range(len(queries)))
print(f"Recall@5: {hit / len(queries):.3f}")
比較するときの注意点が2つあります。1つ目はプレフィックスや指示文をモデルごとに正しく付けること。ruri-v3 の「検索クエリ: 」を付け忘れるだけで数ポイント落ちます。2つ目は次元を揃えて比べること。MRL 対応モデルは次元ごとにスコアが変わるため、本番で使う次元数で測らないと意味がありません。
選定で陥りやすい罠
ここまでを踏まえ、実務で問題になりやすい点をまとめます。まずライセンスの確認を最初にやることです。スコアが高いモデルを前提に設計を進めてから非商用ライセンスだと気づくと、やり直しの手戻りが大きくなります。sarashina-embedding-v2-1b がその典型例です。
次にコンテキスト長です。ruri-v3 と sarashina-embedding-v2-1b は 8192 トークン、plamo-embedding-1b は 4096 トークン、gemini-embedding-001 は 2048 トークン、Qwen3-Embedding は 32K と幅があります。文書を 1000 トークン前後のチャンクに分けるなら 2048 でも足りますが、長い章をまとめて1ベクトルにしたい設計では上限が効いてきます。
最後に、平均スコアの読み方です。Sarashina2 embedding が平均で Sarashina3 を上回るのは Clustering の差によるものでした。自分の用途に対応するタスクの数値を見ないと、判断を誤ります。RAG なら Retrieval と Reranking、タグ付けなら Classification、重複検出なら STS です。ベンチマークは候補を5つに絞るための道具で、1つに決めるのは自社データの役目だと割り切るのが、結局いちばん速い進め方になります。