 AI-Papers
- 事前学習済み動画拡散モデルを画像生成に転用する際、条件画像と目標画像の「仮想的な時間間隔」を入力ごとに適応させる枠組みを提案
- 時間位置エンコーディングを切り替えるMoTEと、中間状態を経由させるCoTRにより、1つのLoRAで3タスクを統合
- GEdit-BenchのMotion Changeで総合6.84を記録し、オープンソース手法の中で最高、GPT-4oに迫る水準を達成
研究の背景
被写体駆動生成(参照画像の被写体を別の場面に描き直す)、Canny条件生成(輪郭線から画像を描く)、指示に基づく画像編集は、いずれも「入力画像の一部を保ちながら、テキストに従って別の画像を作る」という共通の構造を持っています。これらを1つのモデルで扱う統合条件付き画像生成が、近年の研究テーマになっています。
ここで有望な出発点とされてきたのが、事前学習済みの動画生成モデルです。動画モデルはフレーム間の見た目の変化、つまり視覚的な変換そのものを時間方向に学習しているため、条件画像から目標画像への変換を「フレーム予測」として定式化できます。実際にRealGeneralやDRA-Ctrl、ChronoEditなど、動画モデルを画像タスクに転用する手法が提案されてきました。
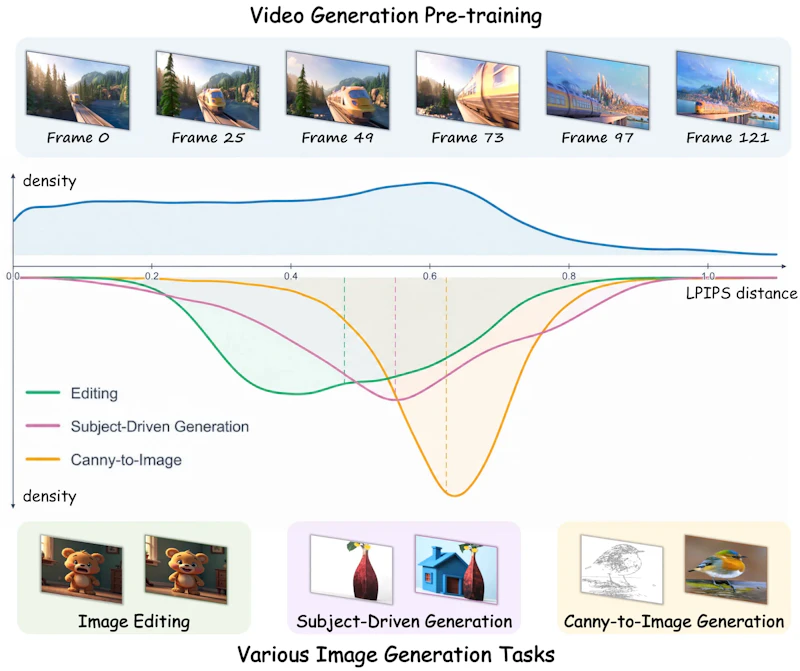
しかし従来手法は、条件画像を先頭フレーム、目標画像を末尾フレームのように固定の時間位置へ割り当てるという前提を置いていました。FrameForgeの著者らは、この前提が実態に合わないと指摘します。論文の分析では、自然動画から異なる時間間隔で取り出したフレーム対のLPIPS距離(知覚的な見た目の差)と、各タスクの条件画像と目標画像の距離を比較しています。
図1に示すように、編集タスクは変化が小さく、被写体駆動生成やCanny条件生成は変化が大きい傾向にあります。ただし各タスクの分布は幅広く重なり合うため、タスク名だけで変換の大きさは決まりません。同じタスクでも入力次第で「どれだけ遠いフレームか」が変わるという観察が、本研究の出発点です。
提案手法
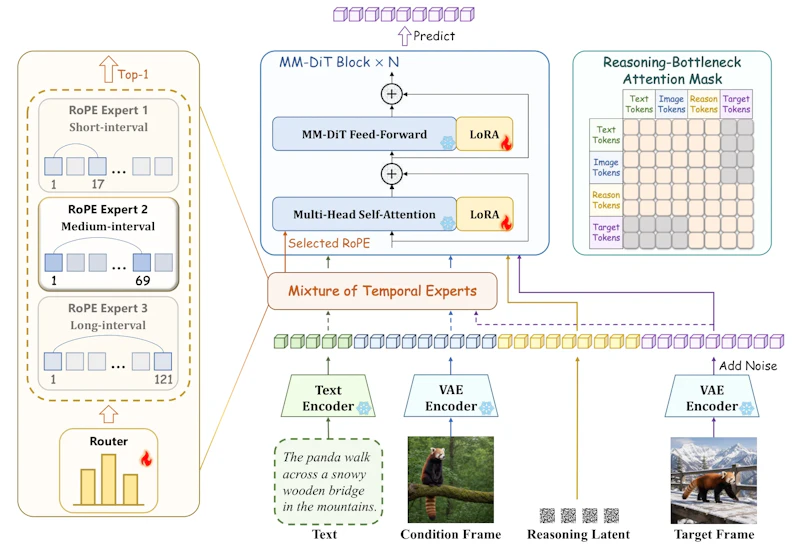
FrameForgeは、条件と目標の関係を固定せず、入力に応じた仮想的な時間関係としてモデル化します。基盤にはHunyuanVideo1.5の第1段階の動画拡散モデルを用い、MM-DiTバックボーンは凍結したまま、全タスクで共有する単一のLoRA(追加学習パラメータ1.82億、rank 32)だけを学習します。
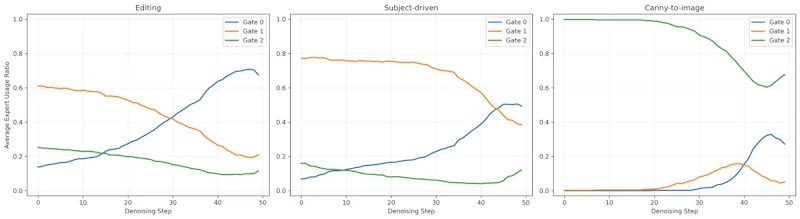
1つ目の仕組みがMixture of Temporal Experts(MoTE)です。時間方向の位置エンコーディング(RoPE)について、仮想フレーム数が17、69、121に相当する短・中・長の3種類の専門家を用意し、テキスト・条件・ノイズ付き目標のトークンを見るルータがサンプル単位でTop-1選択を行います。選択はノイズ除去の各ステップで行われるため、生成の進行に合わせて「目標がどれだけ先のフレームか」という想定が動的に変わります。
2つ目がChain of Temporal Reasoning(CoTR)です。条件と目標の間にノイズから初期化した中間潜在表現を1つ挿入し、Attentionを通じてその内部表現を更新していきます。この中間状態に明示的な教師信号は与えません。代わりに中間学習段階で確率0.5の「推論ボトルネックマスク」を適用し、目標トークンがテキストや条件トークンへ直接Attentionできないようにすることで、情報が中間経路を通るよう促します。
学習は3段階に分かれます。まずMoTEのルータのみを学習し、次に中間潜在とマスクを加えてルータとLoRAを同時に学習し、最後にマスクを外した完全なAttentionで推論時と同じ条件に揃えます。学習データは3タスクそれぞれ17万件、合計51万件で、A800を2枚使い約6日、12000イテレーションという比較的小規模な構成です。テキストから画像を作る側の効率化研究としてはHalcyonのように学習コスト自体を削る方向もありますが、FrameForgeは既存の動画モデルの事前知識を使い切る方向を選んでいます。
実験結果
評価は被写体駆動生成をDreamBench(VIEScoreのSC・PQ・総合O)、Canny条件生成をCOCO2017(FID・SSIM・CLIP-T)、画像編集をGEdit-Benchの英語サブセット(GPT-4.1による採点)で行っています。主な比較結果は次の通りです。
手法 | 基盤モデル | DreamBench O↑ | COCO SSIM↑ | COCO FID↓ | GEdit 総合 G-O↑ |
|---|---|---|---|---|---|
OmniGen | Native | 0.652 | 0.352 | 22.51 | 5.01 |
EasyControl | FLUX.1-dev | 0.679 | 0.417 | 22.82 | ー |
RealGeneral | CogVideoX-1.5 | 0.669 | 0.414 | 24.63 | ー |
DRA-Ctrl | HunyuanVideo-I2V | 0.656 | 0.408 | 23.27 | ー |
ChronoEdit | Wan2.1-I2V-14B | 0.729 | ー | ー | 5.08 |
FrameForge | HunyuanVideo1.5 | 0.739 | 0.447 | 23.47 | 6.12 |
DreamBenchでは総合0.739で比較手法を上回り、COCO2017では構造の忠実さを測るSSIMが0.447で最良でした。FIDはControlNetの20.42に及びませんが、著者らはFIDが基盤モデル固有の見た目の統計に依存し知覚品質と一致しにくい点を挙げ、SSIMやCLIP-T、定性結果と併せて判断すべきだと述べています。
編集タスクでは、被写体の動きを変えるMotion Changeの総合スコアが6.84で、Gemini 2.5の6.72やSeedream 4.0の5.53を上回り、GPT-4oの7.81に次ぐ結果でした。全体平均ではGPT-4oやGemini 2.5にまだ差がありますが、オープンソース手法の中では最も高い水準にあります。
構成要素の寄与を調べたアブレーションでは、タスクごとに別のLoRAを使う構成(被写体0.676、Canny 25.22、編集5.99)や、共有LoRAのみの構成(0.722、25.78、4.94)に対し、MoTEとCoTRの両方を加えた完全版が3タスクすべてで最良(0.739、23.47、6.12)になりました。片方だけでは編集性能が伸びきらず、2つの仕組みが補完的に働くことが示されています。
専門家の数は3個が最適で、5個や7個に増やすとCanny条件生成と編集が悪化しました。学習信号が分散しすぎることが原因と説明されています。中間潜在も1個が最良で、2個以上では制約の乏しい探索空間が広がり性能が落ちています。仮想間隔の設定では長めの{17, 69, 121}が編集に効き、短めの設定は被写体駆動生成にわずかに有利という傾向が出ました。
ルータの振る舞いも分析されています。図6のとおり、Canny条件生成はノイズ除去の初期から長間隔の専門家を選び続け、被写体駆動生成と編集は中間隔から始まって目標の内容が現れるにつれ短間隔へ移ります。編集ではこの移行がより早く強く起こり、タスクの性質に応じた選択が自動的に学ばれたことが読み取れます。
まとめと今後の展望
FrameForgeは、動画モデルの時間的事前知識を画像生成へ持ち込む際の「固定された時間位置」という制約を外し、入力ごとに適応する仮想時間関係として扱い直した研究です。基盤モデルを凍結したまま単一のLoRAで3タスクを統合でき、HunyuanVideo1.0に差し替えた実験でも共有LoRAのみの構成を上回ったことから、特定の基盤モデルに依存しない設計であることも示されています。
一方で課題も残ります。評価された3タスクはいずれも単一の条件画像を入力とするもので、複数参照や長い指示系列への拡張は検討されていません。中間潜在に教師信号がないため、何が表現されているのかは解釈しにくく、個数を増やすと性能が落ちる理由も経験的な説明にとどまります。全体平均の編集性能では商用モデルとの差が残っており、学習データ量や規模を拡大したときの伸び方も今後の検証対象でしょう。
論文情報: "FrameForge: Harnessing Priors of Video Foundation Models for Unified Image Generation"(Yijing Lin et al., 2026) arXiv:2610.36545
本記事の図(図1、図2、図6)は解説のため上記論文より引用しています。


