 AI-Papers
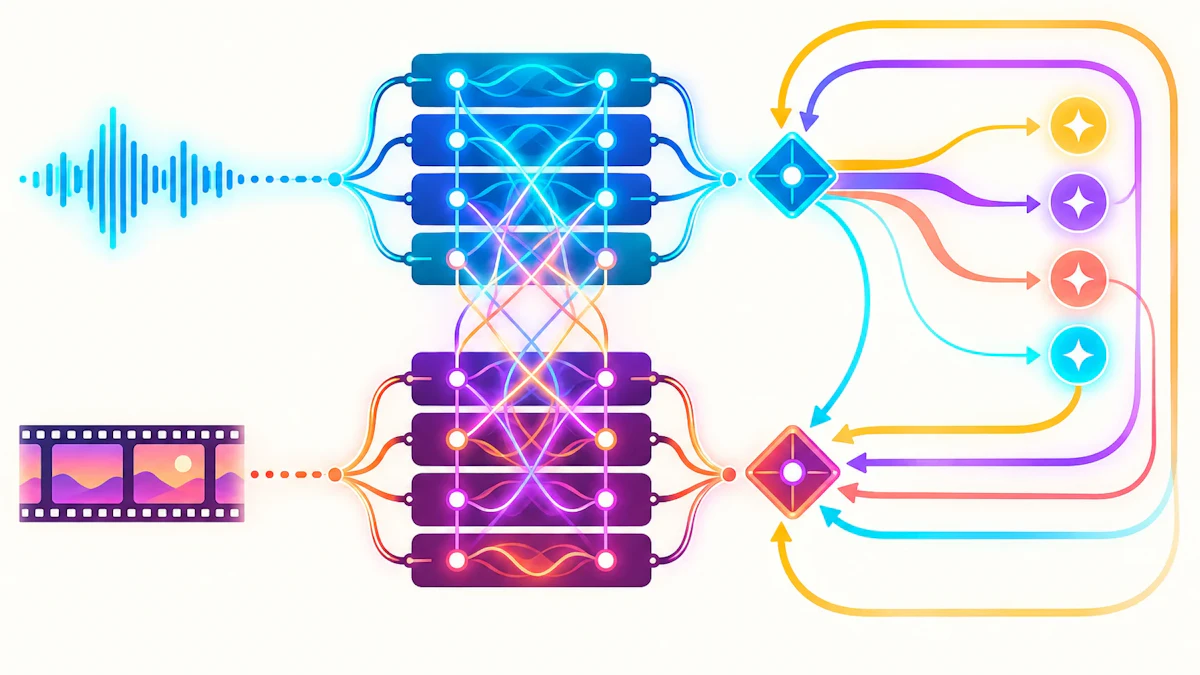
- 音声と動画を同時に生成する拡散モデルを、複数の報酬で強化学習する際の「更新箇所」と「報酬の衝突」を動的に調整する手法です
- クロスアテンションの応答強度を手がかりに、層ごと・トークンごとに勾配の流れを配分し、追加のモデル改変なしで適用できます
- JavisBench での評価で10指標のうち9指標が最良となり、音声動画の同期ずれ(DeSync)は OmniNFT 比で約13%低減しました
研究の背景
テキストから動画と音声をまとめて生成するモデルが実用域に入りつつあります。ただ、生成結果を人の好みに寄せる後処理の学習(ポストトレーニング)には固有の難しさがあります。動画の見栄え、音の品質、テキストとの意味的な一致、そして口の動きと声のような音声動画の同期、これら複数の目標を同時に満たす必要があるためです。
強化学習(RL)で複数の報酬モデルを組み合わせる方法はすでに使われていますが、既存手法はどの層を更新するか、どの報酬をどれだけ重視するかを事前に固定しています。本論文「Adaptive Reward Routing」は、この固定的な設計が学習の進行とともに実態から外れていく点を問題視し、動的に配分し直す枠組みを提案しました。著者は Songlin Yang 氏らで、HuggingFace Daily Papers でも注目を集めた論文です。
固定設計が崩れる理由
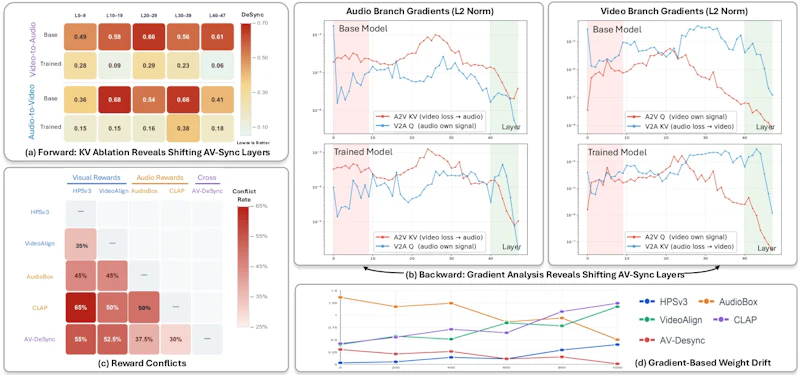
著者はまず、固定設計が成り立たないことを4つの分析で示しています。1つ目は順方向の切除実験で、クロスモーダルな Key/Value 出力を層ごとに無効化すると、同期に効く層が学習前と学習後でずれることが分かりました。2つ目は勾配のノルム分析で、こちらも勾配が集中する層の位置が学習中に移動します。
3つ目は報酬同士の衝突です。プロンプト単位で正規化した選好の符号が逆になる組み合わせが実際に多く、報酬を特定の分岐(音声側か動画側か)に固定割り当てするだけでは足りません。4つ目は、勾配の幾何だけから重みを決めると AV-DeSync の重みがほぼゼロに潰れてしまう現象で、必要な目標が黙って捨てられる危険を示しています。図1の4つのパネルがこれらの根拠にあたります。
提案手法の4階層
Adaptive Reward Routing は、報酬にもとづく最適化を4つの階層で適応させます。上から順に、報酬の重み付け、報酬を音声分岐と動画分岐のどちらに割り当てるか、トークン単位での寄与の配分、そして層ごとのクロスモーダル勾配の経路制御です。図2がこの全体像を示しています。
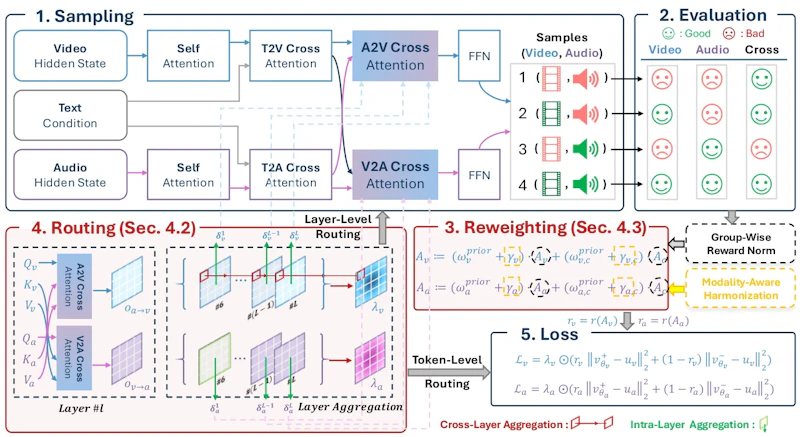
層とトークンの配分を担うのが Cross-Modal Influence-Guided Routing です。双方向クロスアテンションの応答強度を影響度の代理指標として使い、応答が強い層・トークンほど損失の重みを大きくします。層をまたぐ勾配はソフトな切り離し(soft detachment)で調整するため、モデル構造そのものを書き換える必要がありません。
報酬の統合を担うのが Preference-Preserving Modality-Aware Reweighting です。学習の序盤はユーザーが指定した事前重みだけを使い、ウォームアップ後に報酬勾配の相互作用から求めた補正項を残差として少しずつ混ぜます。事前重みが非ゼロの下限として残るため、強い報酬が弱い報酬を押し潰す事態を避けられます。
実験結果
評価には VGGSound 由来の1万9487件のプロンプトで学習し、JavisBench の1万140件のプロンプトで検証しています。出力は4秒・24FPS・16kHz 音声に揃え、各手法を3つの乱数シードで独立に学習させました。基盤モデルは LTX-2(19B)と LTX-2.3(22B)です。
LTX-2 を用いた主要な結果は次の通りで、DeSync は値が小さいほど同期が良いことを意味します。
手法 | VQ(映像品質) | AQ(音声品質) | DeSync(低い方が良い) |
|---|---|---|---|
Base(LTX-2) | 1.883 | 5.201 | 0.604 |
GDPO | 2.722 | 5.450 | 0.671 |
MARBLE | 2.384 | 5.100 | 0.618 |
OmniNFT | 3.136 | 5.614 | 0.390 |
Ours | 3.336 | 5.868 | 0.341 |
最も近い競合である OmniNFT と比べると、音声品質は約4.5%向上し、DeSync は 0.390 から 0.341 へと約13%改善しました。テキストと音声の整合を測る CLAP は 0.416 から 0.425、HPSv3 は 0.312 から 0.314、VideoAlign は 0.265 から 0.268 と、伸び幅は小さいものの一貫して上回っています。両方の基盤モデルで10指標中9指標が最良という結果でした。
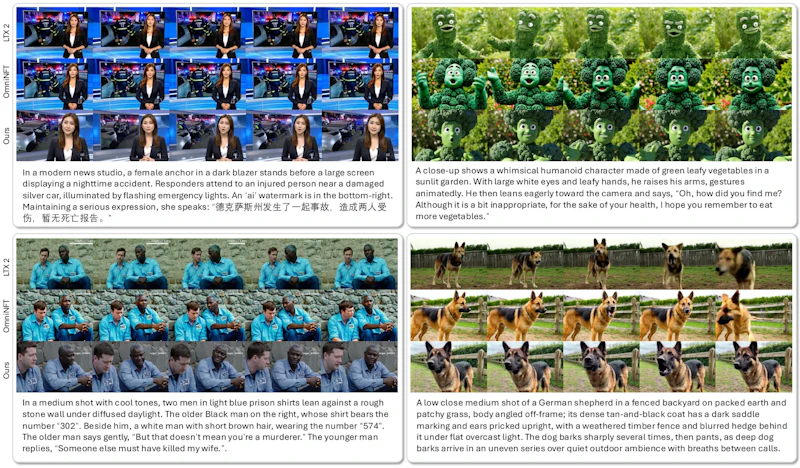
興味深いのは GDPO の挙動で、映像品質は Base から大きく伸びているのに DeSync は 0.604 から 0.671 へ悪化しています。固定重みでの多報酬最適化が、見栄えの改善と引き換えに同期を犠牲にしていたことの裏返しと言えます。図3の定性比較では、提案手法が生成シーケンス全体を通じて被写体の同一性や外観のぶれを抑えられていることが確認できます。
代理指標の妥当性も個別に検証されています。48層それぞれについて、クロスアテンション応答の強さと、その層を無効化したときの最終速度予測の変化量がよく対応していました。学習開始時点の応答で固定した代理指標は学習が進むと精度を落とす一方、現在のモデルから都度求める代理指標は精度を保ちます。また、スコア上位10%のトークンのクロスモーダル情報を遮断すると予測変化が最も大きくなり、重要なトークンを正しく拾えていることが示されました。
限界と今後
著者は適用範囲の制約を率直に挙げています。
- モダリティ品質・意味整合性・同期を一括で捉える統一報酬モデルが存在しない
- 手法はモダリティごとのトークンが識別できることを前提とする
- クロスモーダルな相互作用の応答に外からアクセスできる必要がある
つまり、音声と映像の表現が分離できないアーキテクチャには、そのままでは持ち込めません。報酬モデル側の限界は多報酬 RL 全体の課題でもあり、本手法はそれを前提として受け入れた上で重みの配分を工夫した設計だと見るのが妥当でしょう。
とはいえ、学習の進行に合わせて更新先と報酬の比重を測り直すという考え方自体は、音声動画生成に限らず応用が利きます。複数のモダリティを扱うモデルの設計では、OneStreamer のようにモダリティ間の情報の流れを明示的に扱う研究も進んでおり、RLHF とマルチモーダル生成の接点は今後も広がりそうです。
論文情報: "Adaptive Reward Routing: Dynamic Multi-Reward Optimization for Joint Audio-Video Diffusion via Forward-Process RL"(Songlin Yang et al., 2026) arXiv:2609.37200
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


