 AI-Papers
- 遅延の実測により、VAEデコードとKVキャッシュ更新が1フレーム生成時間の半分以上を占めることを特定
- 重いVAEを1msの軽量ピクセルデコーダに、追加DiT評価を約2msのKV精緻化ネットワークに置換
- 1.3Bモデルが単一B200で36ms/フレーム(約28フレーム毎秒)、最速の既存手法比で約7.6倍の高速化
研究の背景
自己回帰型の動画拡散モデルは、1フレームずつ順番に生成していく仕組みを持ちます。そのため生成途中でユーザーの操作や新しい入力を受け取れる余地があり、ゲームのような対話的な映像体験に向いた技術として期待されています。
ところが現状のモデルは、対話に必要な応答速度にまったく届いていません。Apple の研究チーム(Gene Chou 氏ら)が発表した本論文は、この速度の壁をどこで崩すべきかを実測から突き止めたうえで、具体的な置換案を提示しています。
これまでの高速化研究は、拡散モデルのノイズ除去ステップ数を減らすことに集中してきました。数十ステップを4ステップ程度まで圧縮する蒸留技術が進み、サンプリング自体はかなり軽くなっています。その結果、むしろサンプリング以外の処理が遅延の主役に入れ替わっていたという点が、本研究の出発点です。
遅延の内訳を測る
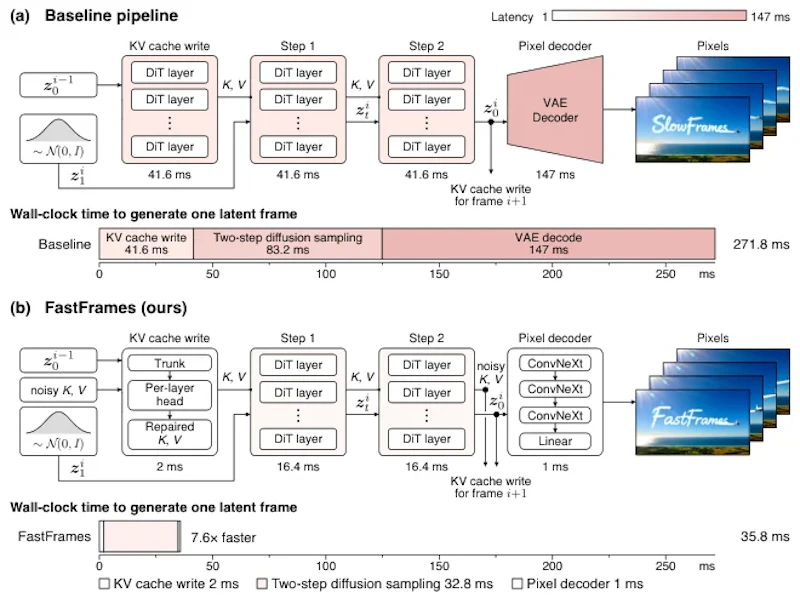
著者らは最速の既存手法である Causal Forcing++(1.3B)を単一の NVIDIA B200 GPU 上で計測しました。480p で1フレームを生成するのに271.8msかかりますが、その内訳を見ると拡散サンプリングは全体の約30%にすぎません。
最も重いのは潜在表現をピクセルに戻す VAE デコードで147msを消費します。これは DiT(拡散に使う Transformer)1回の評価(41.6ms)の3.5倍に相当します。さらに、前フレームの結果をKVキャッシュ(過去の文脈を保持しておく記憶領域)に反映させるために DiT をもう1回走らせており、ここでも41.6msが消えていました。
図2はこの内訳と、FastFrames が各部品をどう置き換えたかを並べて示したものです。固定費として扱われてきた2つの「付属処理」が、実は削減余地の大きい部分だったことがわかります。
提案手法
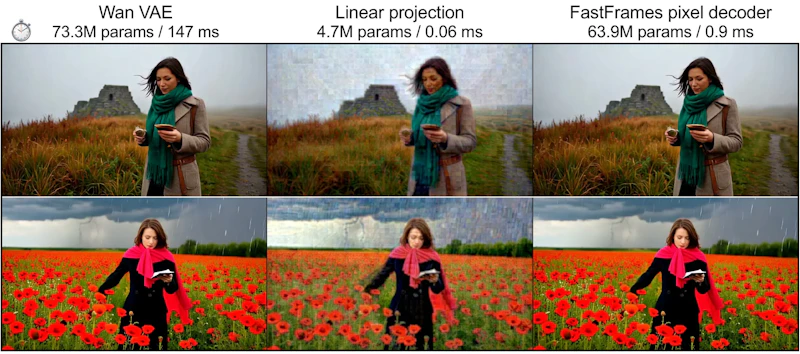
FastFrames の中核は2つの軽量ネットワークです。1つ目はピクセルデコーダで、Transformer が扱う低解像度のトークン格子の上に因果的な3次元 ConvNeXt ブロックを3つ重ね、最後の線形層で RGB のパッチを出力します。パラメータ数は63.9Mで Wan の VAE(73.3M)とほぼ同規模ですが、処理時間は147msから1msへと2桁縮みました。学習メモリも約68GBから約5GBに下がっています。
学習は、凍結した VAE の出力を教師とする再構成損失(L1、MSE、勾配、時間方向、動き重み付けの各項)で行い、その後 DINOv3 ViT-S/16 を識別器に用いた敵対的学習で仕上げています。図3を見ると、単純な線形射影ではシーンの判別はできても輪郭がぼやけるのに対し、提案デコーダは髪の毛や雨粒のような細い構造まで描けています。
2つ目は KV 精緻化ネットワークです。1,536から768チャネルへ落とす共通ステムに軽量な Transformer ブロックを4つ置き、層ごとの修復ヘッドがノイズを含むキーとバリューへの残差補正を予測します。残差はゼロ初期化され、DiT と VAE は凍結したまま、KV の再構成損失とアテンション出力の損失で学習します。所要時間は1.3Bで約2ms、14Bで約6msとなり、従来の DiT 追加評価に対して12〜20倍高速です。
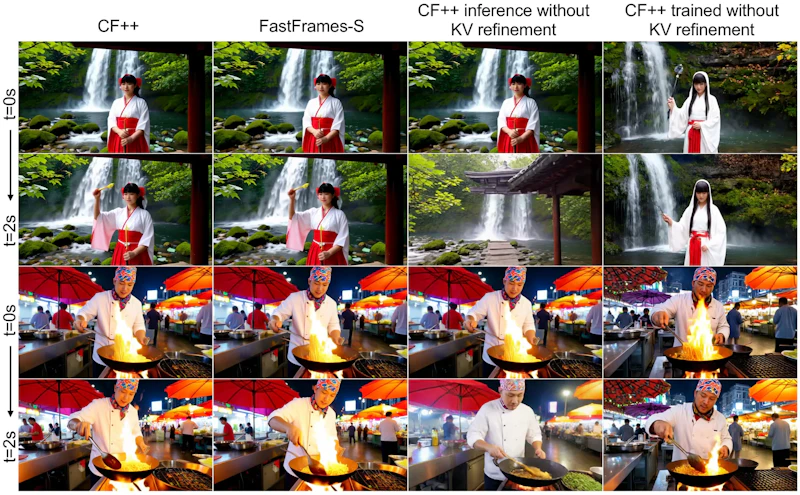
この精緻化を単に省くとどうなるかを示したのが図6です。削除するとシーン内の物体が時間とともに入れ替わり、精緻化なしで学習し直しても人物の顔が変化したり衣服や指に破綻が現れます。提案ネットワークは品質を保ったまま、この工程だけを軽くしています。
加えて、DiT 評価そのものにもシステム面の最適化を施しました。KV バッファの永続化、RoPE と条件付けの事前計算、QKV の融合、split-KV アテンション、CUDA グラフの利用により、1.3Bでは41.6msから16.4msへ短縮されています。8枚の GPU でコンテキスト並列を使えば5.8msまで下がります。
実験結果
480p の text-to-video を VBench で評価した結果が以下です。品質指標をほぼ維持したまま、遅延が大きく下がっていることが読み取れます。
モデル | パラメータ数 | 遅延 | VBench総合 |
|---|---|---|---|
Causal Forcing++ | 1.3B | 272ms | 84.11 |
Self-Forcing | 1.3B | 717ms | 84.10 |
Krea-Realtime | 14.3B | 1,675ms | 84.42 |
FastFrames-S(1GPU) | 1.3B | 36ms | 84.23 |
FastFrames-S(8GPU) | 1.3B | 14ms | 84.23 |
FastFrames-L(8GPU) | 14.3B | 45ms | 84.44 |
FastFrames-S は単一 GPU で毎秒27.8フレームの応答に達し、著者らが目標に掲げた毎秒20応答を超えました。DiT の重みは Causal Forcing++ と同じであるため、わずかな品質向上はピクセル空間での敵対的な一貫学習によるものと説明されています。
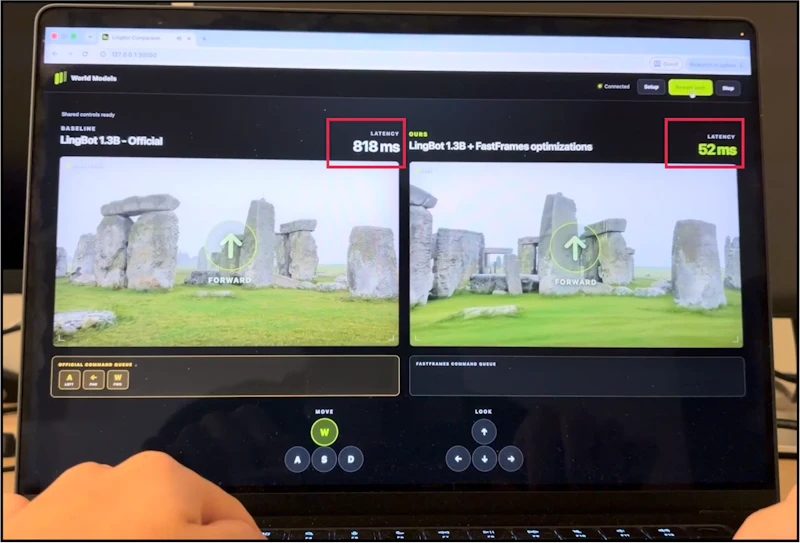
同じ最適化は対話型のモデルにも適用できます。カメラ操作に応じて映像を生成する LingBot の1.3Bモデルでは、公式実装の1,085msが8GPU構成で52msになり、約16倍の高速化を示しました。物理的なドラッグ操作に対応する RealWonder では1,141msが51msへと約22倍縮んでいます。操作に対する応答という観点では、Google DeepMindがGenie 4を提供開始、会話で世界を書き換えのような対話型の世界生成と同じ方向を向いた成果です。
まとめと今後の展望
本研究の価値は、新しい生成アルゴリズムではなく、遅延の実測によってボトルネックの所在を入れ替えた点にあります。削るべき場所が変われば、打ち手も変わるという示唆は動画生成以外にも通じるでしょう。コードは GitHub(apple-aiml-research/ml-fastframes)で公開されています。
一方で制約もはっきり書かれています。評価は480p の text-to-video に限られ、ハードウェアは高価な B200 を前提としています。720p では FastFrames-S が127msまで伸び、H100 では25〜50%遅くなるため、軽量な環境や端末上での動作は未解決です。
また対話型モデル側は、もともと低遅延を狙って設計されていません。サンプリングステップ数や1回に生成する潜在フレーム数が多いため、対話的な速度を出すには依然8枚程度の GPU が必要です。著者らはカメラ姿勢をチャネル方向に連結するなど、行動条件付けの設計自体を低遅延向けに見直す方向を示唆しています。ピクセル空間で直接生成する研究など、デコーダの扱いを再考する流れと合わせて追うと理解が深まります。
論文情報: "FastFrames: Video Generation at Interactive Latency"(Gene Chou et al., 2026) arXiv:2611.23226
本記事の図(図2、図3、図5、図6)は解説のため上記論文より引用しています。


