 AI-Papers
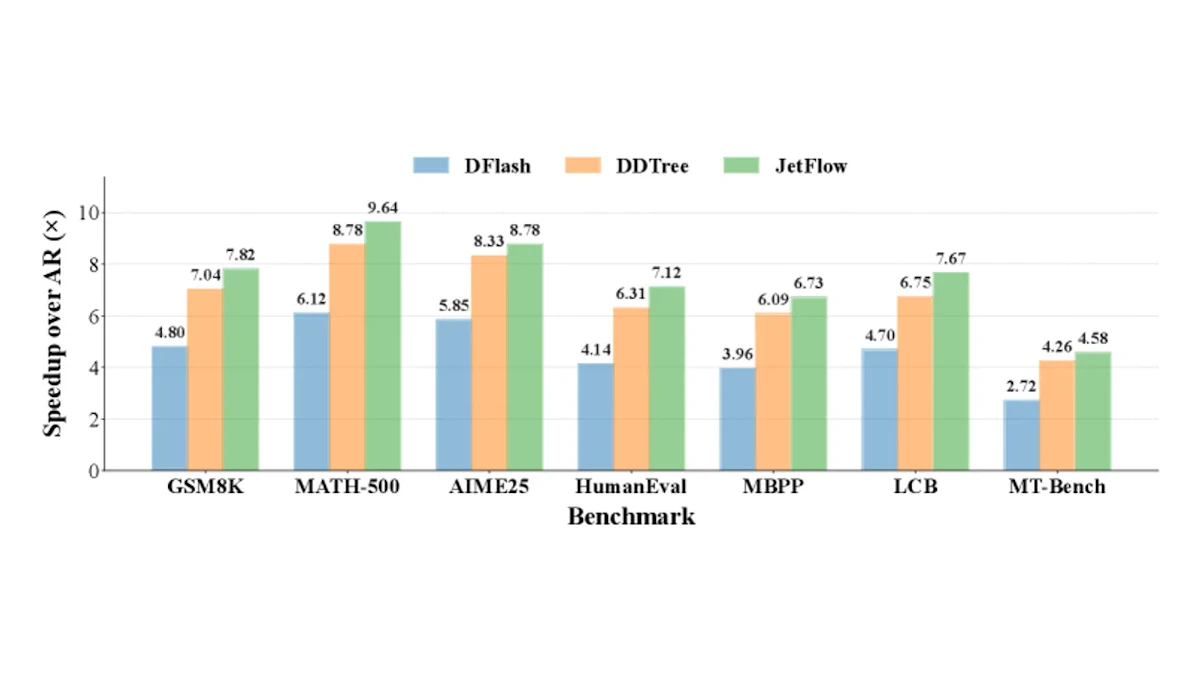
- 並列ツリードラフトに因果的依存構造を組み合わせ、「ドラフト予算を増やすと受理率が下がる」という投機的デコーディングの根本課題を解消した
- MATH-500で最大9.64倍、MT-Benchで4.58倍の推論高速化をH100 GPU上で実証し、vLLM統合でのサービス環境でも6.75倍の高速化を確認
- コードはGitHub(hao-ai-lab/JetSpec)で公開済み。Qwen3モデルで評価されており、再現性が高く実務への導入障壁が低い
研究の背景
投機的デコーディング(Speculative Decoding)は、LLMの推論を高速化する手法として広く研究されています。軽量な「ドラフトモデル」が複数のトークン候補を先読みで生成し、本体の「ターゲットモデル」がその候補をまとめて検証することで、1トークンずつ自己回帰的に生成するより速い出力を実現します。
しかし、この手法には「スケーリングの壁」が存在します。高速化の期待値はドラフト長(N)と受理率(α)のバランスで決まりますが、候補トークンの数を増やすほど検証で却下されるものも増え、受理率が下がります。結果として、ドラフト予算を増やしても期待されるスピードアップは頭打ちになります。
DFlashなどのブロック並列ドラフティング手法はこの限界を打破しようとしましたが、各トークンを独立した分布から生成するため、枝の中で文脈を考慮しない矛盾した列(たとえば「given told that」のような文法的に成立しない組み合わせ)が生まれやすいという問題を抱えていました。高予算では受理率がさらに悪化し、スケーリング効果が得られないままでした。
提案手法 JetFlow
hao-ai-labの研究チームが提案したJetFlowは、「因果並列ドラフトヘッド(causal-parallel draft head)」という新しい設計でこの問題を解決します。凍結されたターゲットモデルの隠れ状態から融合特徴量を抽出し、そこから一度の前向き計算(forward pass)で候補ツリー全体を生成します。
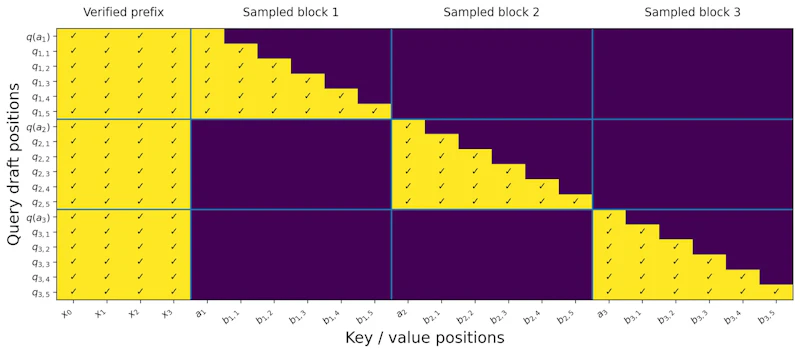
核心となるのは「ツリー因果注意マスク(tree causal attention mask)」の導入です。このマスクにより、各候補トークンは自分の祖先にあたるトークンにのみ注目でき、兄弟の枝や子孫への参照は遮断されます。枝の中では先行トークンが後続トークンを条件づける自己回帰的な依存構造を保ちながら、複数の枝を並列に展開できます。
従来のDFlashが「枝ごとの文脈を無視した独立サンプリング」だったのに対し、JetFlowは「枝の中では文脈を考慮しつつ、枝どうしは並列に処理する」という両立を実現しています。これが高予算設定でも受理率が維持される理由です。
学習面では、ソフトラベル情報を保持できる順方向KL発散を採用しました。逆KL発散と比較した実験では受理率が36〜46%改善することが確認されており、損失関数の選択が性能に大きく影響することも示されています。
実験結果
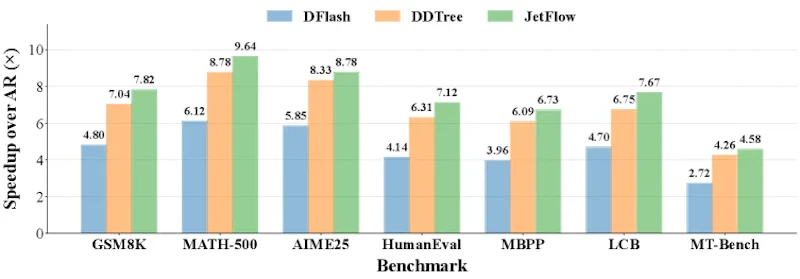
Qwen3モデルを対象にH100 GPU上で評価を実施しました。ドラフト予算256トークンの設定では、JetFlowはMATH-500で最大9.64倍のスピードアップを達成し、平均受理長(τ)は10.76トークンに達しています。コーディングタスク(HumanEval)では7.12倍、会話タスク(MT-Bench)では4.58倍の高速化を実現しました。
ツリー型の競合手法であるDDTreeと比較しても、20〜30%の相対的な改善を達成しています。低予算領域(16〜32トークン)では既存手法との差は比較的小さく、JetFlowの強みは高予算設定での安定した受理率維持にある点は留意が必要です。
実務的なサービング環境での有効性も検証されました。vLLM統合下のバッチサイズ1・予算128トークンの条件では6.75倍のスピードアップを確認しており、バッチサイズ32でも4.51倍の高速化が得られています。低〜中程度のサービス負荷であれば十分な効果が期待できます。KVキャッシュ圧縮など他の推論最適化手法との組み合わせも、今後の活用として検討できます。
まとめと今後の展望
JetFlowは、投機的デコーディングの「予算を増やしても効果が頭打ちになる」という本質的な制約を、ツリー因果注意マスクという設計の工夫で解決した手法です。並列処理の速度を保ちながら枝内の自己回帰的依存を担保することで、高ドラフト予算での高速化を実用的に活用できるようにした点が、従来手法との大きな違いです。
コードはGitHub(hao-ai-lab/JetSpec)で公開されており、vLLM統合も実証済みです。既存のLLMサービングインフラに組み込める形での公開であるため、LLM推論コストの削減を検討している開発者にとって試しやすい選択肢となっています。
課題としては、バッチサイズが大きくなると高速化効果が縮小することや、より多様なモデルアーキテクチャへの適用可能性の検証が挙げられます。投機的デコーディングの理論的な上限にどこまで近づいているかという観点での分析も、今後の研究として期待されます。
論文情報: "JetSpec: Breaking the Scaling Ceiling of Speculative Decoding with Parallel Tree Drafting"(Lanxiang Hu et al., 2026) arXiv:2606.18394, CC BY 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


