AI-Papers
- Artificial Analysis の知能指数では MiMo-V2.6-Pro が46、DeepSeek V4.1 Flash と GLM-5.3 が45で上位に並び、オープンウェイト勢の中央値19を大きく離しています
- ライセンスは MIT、Apache 2.0、独自ライセンスの3系統に分かれ、商用利用の可否と制限の有無が選定の最初の分岐点になります
- セルフホストの可否は総パラメータ数でほぼ決まり、320B クラスなら H200 を4枚、2.8T クラスなら B200 を8枚規模が目安になります
2026年の勢力図
オープンウェイトの大規模言語モデル(Large Language Model、LLM)は、2026年に入ってから上位の顔ぶれがほぼ総入れ替えになりました。かつて定番だった Llama 系はベンチマークの上位から姿を消し、代わりに中国系の研究所と Xiaomi、Meta の新系列が入れ替わり立ち替わり首位を争っています。
独立評価サイトの Artificial Analysis が公開している知能指数(Intelligence Index v4.3.2)を見ると、1位は Xiaomi の MiMo-V2.6-Pro で46点。2位に DeepSeek V4.1 Flash 1017、3位に Z AI の GLM-5.3 が45点で続き、Moonshot AI の Kimi K3 と StepFun の Step 5 Preview が44点で並びます。同じ土俵で比較されるオープンウェイトモデルの中央値が19点なので、上位勢は明確に別のレイヤーにいると言えます。
ここで重要なのは、点差がもはや選定の決め手になっていないことです。上位5モデルは46点から44点の範囲に収まっており、この差は実務のタスクではほとんど体感できません。差が出るのはライセンス、推論速度、そして自前で動かすときのハードウェア要件のほうです。
主要モデルの比較表
まずは数値を並べて全体像を押さえます。価格はいずれも各社の公式 API のもので、1M トークンあたりのドル建てです。
モデル | 開発元 | 知能指数 | 総/活性パラメータ | 文脈長 | ライセンス | 入力/出力価格 | 出力速度 |
|---|---|---|---|---|---|---|---|
MiMo-V2.6-Pro | Xiaomi | 46 | 1.0T / 42B | 1M | MIT | $0.43 / $0.87 | 52.3 tok/s |
DeepSeek V4.1 Flash 1017 | DeepSeek | 45 | 552B / 16B | 1M | MIT | $0.30 / $1.20 | 209.4 tok/s |
GLM-5.3 | Z AI | 45 | 753B / 40B | 1M | GLM-5.3 License | $1.40 / $4.40 | 77.7 tok/s |
Step 5 Preview | StepFun | 44 | 600B / 27B | 1M | 独自 | 混合 $0.5 | 138 tok/s |
Kimi K3 | Moonshot AI | 44 | 2.8T / 104B | 1M | Kimi K3 License | 混合 $2.3 | 37 tok/s |
GLM-5.3-Flash | Z AI | 42 | 320B / 18B | 1M | MIT | $0.15 / $0.50 | 67.0 tok/s |
Muse Spark Open | Meta | 39 | 816B / 42B | 1M | 独自 | 混合 $0.8 | 142 tok/s |
Qwen3.8 27B | Alibaba | 34 | 27B(密) | 256k | Apache 2.0 | $0.50 / $3.00 | 42.1 tok/s |
表で目を引くのは DeepSeek V4.1 Flash の組み合わせでしょう。知能指数45を維持しながら活性パラメータは16B しかなく、出力速度は209 tok/s と上位勢で突出しています。MIT ライセンスで商用利用に制約がない点も含めて、現時点でもっとも扱いやすい選択肢です。詳細はDeepSeekがV4.1-FlashをMITライセンスで公開、コード成功率77%でも取り上げています。
逆に Kimi K3 は2.8T パラメータと桁違いの規模で知能指数44、出力速度は37 tok/s と最も遅く、混合単価も $2.3 と割高です。規模が性能にそのまま比例しない段階に入ったことがよくわかります。
知能指数は何を測るか
Artificial Analysis の知能指数は単一のテストではなく、10種類の評価を合成したスコアです。構成要素には AA-Briefcase v1.1、GDPval-AA v2.1、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity's Last Exam、CritPt、AA-Omniscience、長文脈推論の AA-LCR v1.1 などが含まれます。
つまり「業務文書の処理」「ターミナル操作を伴うエージェント的作業」「科学コード生成」「知識の正確さ」といった異なる性質のタスクを平均した値です。自社の用途が特定の領域に偏っているなら、総合点ではなく個別評価のスコアを見るべきです。コード生成しか使わないのに知識系の配点に引っ張られた総合点で選ぶと、判断を誤ります。
もう1つ注意したいのが冗長性です。GLM-5.3 と DeepSeek V4.1 Flash は知能指数の全評価を通すのに210M トークンを出力しており、中央値の140M を5割上回ります。推論モデルは思考過程を長く出すため、表面上の出力単価が安くても実際の請求額は想定より膨らみます。タスクあたりのコストで見ると、GLM-5.3 は $2.01、DeepSeek V4.1 Flash は $0.26、MiMo-V2.6-Pro は $0.13 と10倍以上の開きがあります。
ライセンスの落とし穴
「オープンソース LLM」と一括りにされますが、実際のライセンスは3系統に分かれます。ここを確認せずに検証を進めると、本番投入の直前で差し戻しになります。
MIT と Apache 2.0
MiMo-V2.6-Pro、DeepSeek V4.1 Flash、GLM-5.3-Flash は MIT ライセンス、Qwen3.8 27B は Apache 2.0 です。いずれも商用利用、改変、再配布に実質的な制限がなく、著作権表示を残すだけで足ります。法務確認の負担が最も軽い選択肢で、ファインチューニングした派生モデルを自社製品に組み込む場合もここから選ぶのが無難です。
独自ライセンスの制限
一方、GLM-5.3 は「GLM-5.3 License」、Kimi K3 は「Kimi K3 License」という独自の条項を持ちます。どちらも商用利用自体は認められていますが制限条項が付くため、ライセンス本文を読む工程が必須です。同じ Z AI の製品でも GLM-5.3 が独自ライセンス、GLM-5.3-Flash が MIT と分かれている点には気をつけてください。モデル名が似ているからといって条件を推測してはいけません。
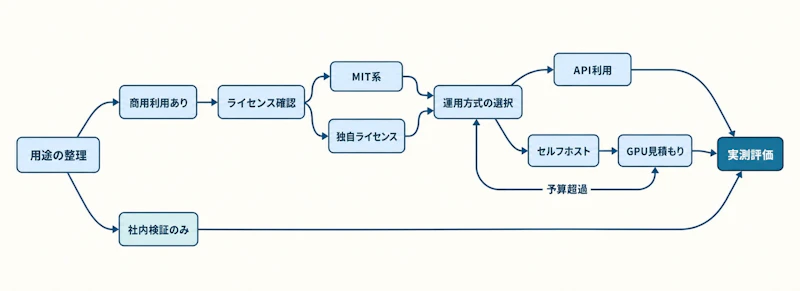
図1のように、商用利用の有無からライセンス系統を確定させ、そのあとで運用方式とハードウェア予算を検討する順番にすると手戻りが減ります。
必要なGPUを見積もる
活性パラメータの罠
上位モデルはすべて Mixture of Experts(MoE)構成です。MoE はネットワークを多数の専門家(エキスパート)に分割し、トークンごとにごく一部だけを呼び出す仕組みで、計算量を抑えながら総パラメータを増やせます。Kimi K3 は896個のエキスパートから16個を選び、共有エキスパート2個を常時使う構成です。
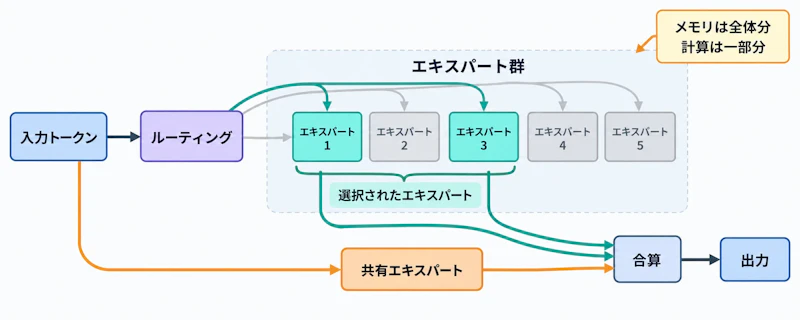
ここで誤解しやすいのが、図2にあるとおりメモリには総パラメータ分が必要という点です。活性16B だから小さい GPU で動く、とはなりません。どのエキスパートが呼ばれるかは事前に決まらないため、重みはすべてメモリ上に置く必要があります。
構成別の目安
必要メモリの概算は「総パラメータ数 × 1パラメータあたりのバイト数」に KV キャッシュと実行時オーバーヘッドを足した値です。FP8 なら1パラメータ1バイト、4bit 量子化なら0.5バイトで計算します。
モデル | 総パラメータ | FP8換算の重み | 現実的な構成の目安 |
|---|---|---|---|
Qwen3.8 27B | 27B | 約27GB | H100 80GB × 1 |
GLM-5.3-Flash | 320B | 約320GB | H200 141GB × 4 |
DeepSeek V4.1 Flash | 552B | 約552GB | H100 80GB × 8 |
GLM-5.3 | 753B | 約753GB | H200 141GB × 8 |
MiMo-V2.6-Pro | 1.0T | 約1.0TB | H200 141GB × 8 |
Kimi K3 | 2.8T | MXFP4で約1.4TB | B200 192GB × 8 以上 |
DeepSeek V4.1 Flash を H100 8枚(合計640GB)に載せると、重みだけで552GB を占めて残りは88GB です。1M トークンの文脈を複数同時に処理するには足りず、実運用では H200 構成か4bit 量子化が前提になります。Kimi K3 は MXFP4 ネイティブ重みでも1.4TB 前後で、Unsloth が配布する GGUF は4bit 版で1.51TB、1bit 版でも466GB あります。個人の環境で動かせる規模ではありません。
単一 GPU で完結させたいなら、現実的な選択肢は Qwen3.8 27B のような密モデルです。知能指数は34と上位勢に劣りますが、4bit 量子化なら16GB 前後に収まり、コンシューマ向け GPU 1枚でも動きます。
自分で検証する手順
公開ベンチマークは出発点であって結論ではありません。自社データで実測するのが結局いちばん早い判断材料になります。vLLM を使う場合、量子化済みの重みを指定してテンソル並列で起動します。
# GLM-5.3-Flash を H200 4枚で起動する例
vllm serve zai-org/GLM-5.3-Flash \
  --tensor-parallel-size 4 \
  --max-model-len 131072 \
  --gpu-memory-utilization 0.90 \
  --port 8000
起動したら OpenAI 互換のエンドポイントとして叩けます。文脈長はいきなり1M を指定せず、実際に使う長さに絞るのがコツです。KV キャッシュの確保量が減り、同時処理できるリクエスト数が増えます。
import openai

client = openai.OpenAI(base_url="http://localhost:8000/v1", api_key="dummy")
resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    messages=[{"role": "user", "content": "自社の実タスクのプロンプト"}],
    extra_body={"reasoning_effort": "high"},
)
print(resp.usage)
検証では応答の質だけでなく usage の出力トークン数を必ず記録してください。推論モデルは reasoning_effort の設定で思考量が変わり、GLM-5.3 系では low / high / max を選べます。既定値は max なので、そのまま使うと無駄に長い思考を生成しがちです。
選定時に見落としがちな点
最後に、比較表だけでは見えない観点を挙げておきます。
- 提供事業者数。DeepSeek V4.1 Flash は18社、GLM-5.3-Flash は26社が API を提供しており、乗り換え先が多いほど単一障害点を避けられます
- 最初のトークンまでの時間。上位勢は3秒前後かかるものが多く、対話用途では体感が悪くなります
- 対応する推論エンジン。vLLM と SGLang はほぼ共通ですが、Ascend NPU や KTransformers への対応はモデルごとに差があります
- 量子化版の入手性。GLM-5.3 には87種の量子化派生が公開されており、llama.cpp や Ollama での動作確認が取りやすい状態です
結論としては、商用で迷ったら MIT ライセンスで速度と単価のバランスが良い DeepSeek V4.1 Flash、コスト重視なら GLM-5.3-Flash、総合力を取るなら MiMo-V2.6-Pro という並びになります。知能指数の1点差を追うより、ライセンスと GPU 予算という動かしにくい制約から逆算するほうが、実際には良い結果につながります。