 AI-Papers
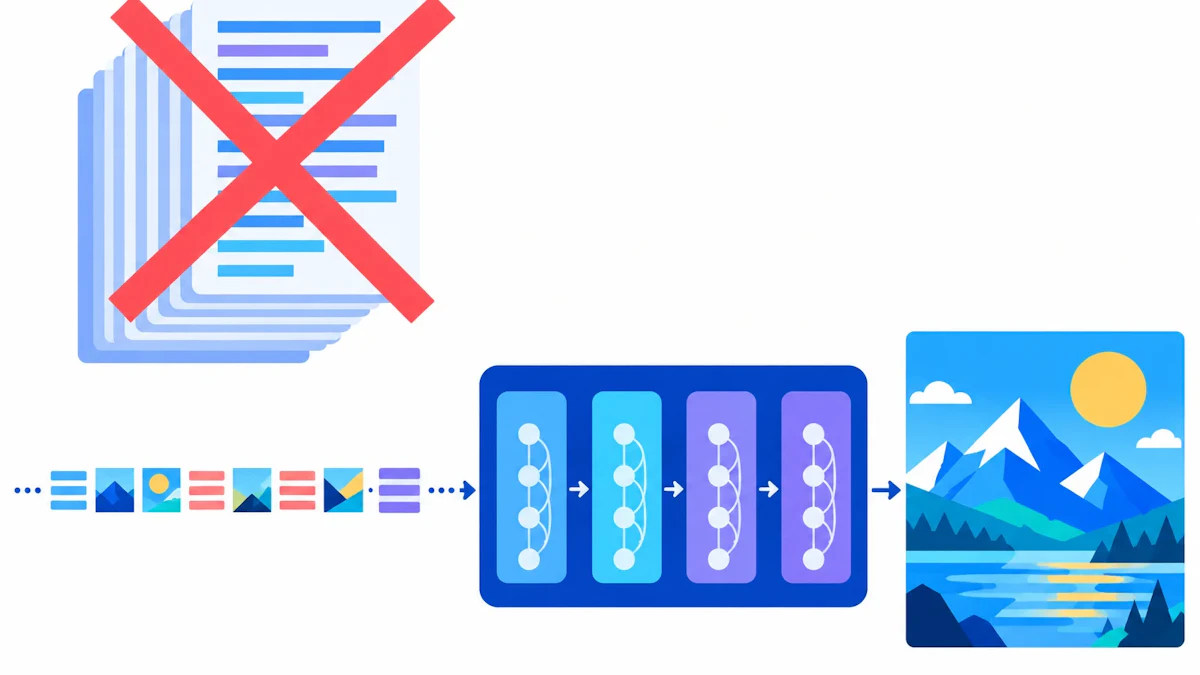
- Stanford大学などの研究チームが、巨大な言語モデルの事前学習を一切使わずゼロから学習したテキスト画像生成モデル「Halcyon」を発表しました
- 画像テキスト1億組のデータセットGPICのみで学習したHalcyon-1.6Bは、JiT-T2I-XXL/8++をgFD 35.3対41.0で上回り、事前学習の総計算量は約275分の1です
- 対照実験では、テキストのみの事前学習を追加しても画像生成品質は改善せず、むしろ悪化する結果が示されました
研究の背景
現在のテキストから画像を生成するモデル(Text-to-Image、以下T2I)は、ほぼ例外なく巨大な言語モデルや言語エンコーダを部品として使っています。FLAN-T5やQwen3のような、インターネット規模のテキストで事前学習された重みを凍結し、その出力を条件として画像生成器に渡す構成です。この設計は「言語の意味理解はテキストの大規模学習からしか得られない」という前提に立っています。
Stanford大学のKeshigeyan Chandrasegaran氏らのチーム(Li Fei-Fei氏、Michael Poli氏も著者に名を連ねています)は、この前提そのものを検証対象にしました。論文タイトルは「Text-to-Image Generative Modeling Without Language Pretraining」で、問いはシンプルです。T2Iの性能に、テキストのみの事前学習は本当に必要なのでしょうか。
この問いが重要なのは、計算資源の配分に直結するためです。言語モデルの事前学習には膨大な計算が必要で、T2Iシステム全体の計算コストの大半を占めることも珍しくありません。もし画像テキストの対データだけで同等以上の品質に届くなら、研究開発の入り口は大きく広がります。
Halcyonの構成
提案されたHalcyonは、テキストトークンと画像トークンを1本の系列に並べ、次のトークンを予測するだけのデコーダのみTransformerです。言語モデルと画像生成器を分けて接続する従来の遅延融合(late-fusion)ではなく、最初から両方のモダリティを同じ系列で扱うearly-fusion(早期融合)の自己回帰モデルで、すべての重みをランダム初期化から学習します。
画像トークナイザはCosmos系のエンコーダデコーダ構成で、有限スカラー量子化(Finite Scalar Quantization、連続値を決まった格子点に丸めて離散化する手法)を使います。8倍のダウンサンプリングにより256×256画像が1,024トークンになり、コードブックは64,000エントリです。テキスト側はGPICのキャプションとOpenWebTextで訓練したバイトレベルBPEで、語彙は16,384。両者を合わせた統合語彙は80,640エントリになります。
学習データは画像テキスト約1億組のGPIC(256×256解像度)で、1エポック(約97.6Kステップ)のみ、バッチサイズ1,024、AdamWとウォームアップ、一定、クールダウンの学習率スケジュールという素直なレシピです。モデルサイズは0.1Bから4Bまで5種類が用意されました。
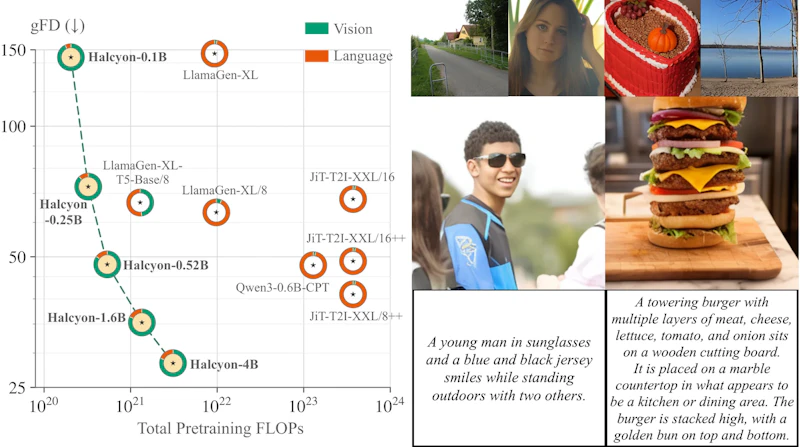
図1の左側が本研究の主張を端的に表しています。横軸が各T2Iシステムを構築するのに要した事前学習の総FLOPs、縦軸がgFD(生成画像と実画像の分布の隔たりを測る指標で、低いほど良い)です。Halcyonは大きく左下、つまり少ない計算でより良い品質という領域に位置しています。ドーナツ図を見ると、ベースライン側では言語の事前学習が計算の大部分を占めていることがわかります。
言語事前学習は効いたか
興味深いのは、著者らが「使わなくてもできる」で止めず、「使うと良くなるのか」を対照実験で確かめた点です。検証は2通りで行われました。
1つ目は、36兆トークンのテキストで事前学習済みのQwen3-0.6B-Baseから継続事前学習する方法です。同じアーキテクチャをランダム初期化から学習した場合のgFD 46.6に対し、継続事前学習は47.8でわずかに劣りました。2つ目は、固定された計算予算のうち10%、20%、50%をテキストのみの事前学習に割り当てる方法で、結果はそれぞれ51.6、52.8、65.1。全額を画像テキスト対に使った48.0より一貫して悪化しています。
テキスト学習に予算を振るほど画像生成が悪くなるという傾向は、少なくとも今回の設定では、外部のテキスト事前学習がT2Iに寄与しないことを示します。離散表現を用いた画像生成の効率化という方向性はIntern Lumina U2など他の研究でも進んでいますが、Halcyonは言語側の前提に切り込んだ点で立ち位置が異なります。
実験結果
GPIC Test-50Kでの主要な結果を、事前学習の総FLOPsとあわせて整理します。ベースラインのLlamaGenはFLAN-T5エンコーダを併用する遅延融合の自己回帰モデル、JiT-T2IはQwen3-1.7Bを併用する遅延融合の拡散モデルです。
モデル | gFD(低いほど良い) | 事前学習総FLOPs |
|---|---|---|
Halcyon-0.1B | 144.16 | 2.05×10²⁰ |
Halcyon-0.25B | 72.55 | 3.21×10²⁰ |
Halcyon-0.52B | 48.02 | 5.33×10²⁰ |
Halcyon-1.6B | 35.28 | 1.34×10²¹ |
Halcyon-4B | 28.43 | 3.08×10²¹ |
LlamaGen-XL/8 | 63.29 | 9.68×10²¹ |
JiT-T2I-XXL/8++ | 40.97 | 3.68×10²³ |
Halcyon-0.52BはLlamaGen-XL/8を約18.2分の1の計算量で上回り、Halcyon-1.6BはJiT-T2I-XXL/8++を約275分の1で上回りました。モデルを大きくするほどgFDは単調に下がり、スケーリングの素直さも確認されています。最適なClassifier-Free Guidance(条件なし生成との差分を強調して忠実度を高める手法)のスケールは、0.1Bの7.5から4Bの4.5へと小さくなっていきました。
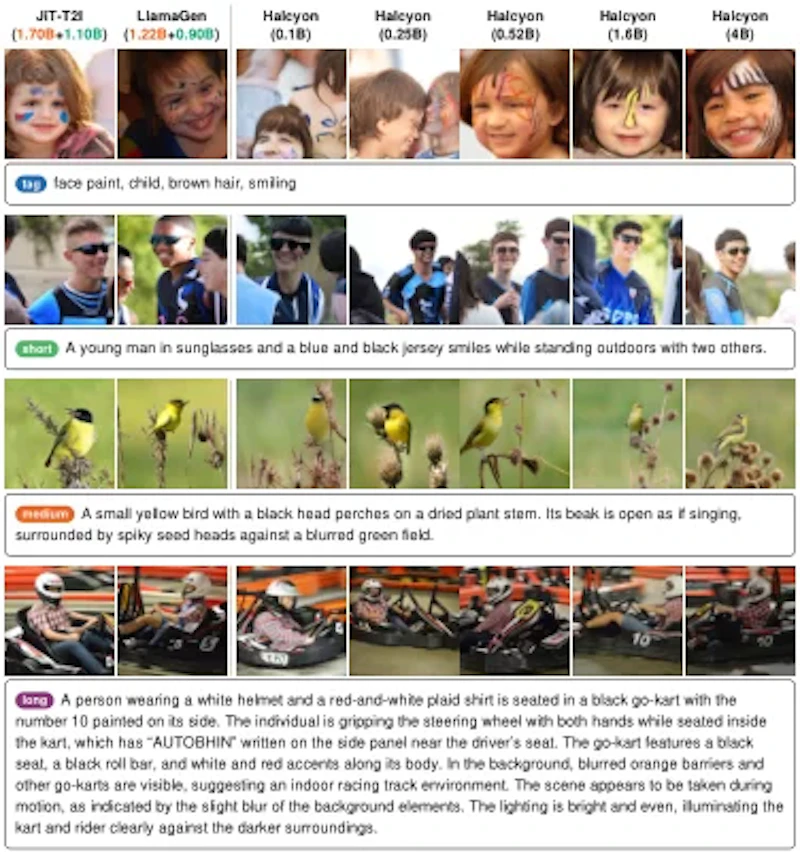
図5は同じプロンプトでの生成画像を並べたもので、Halcyonのサイズが上がるにつれて構造の破綻が減っていく様子が見て取れます。キャプションの長さの影響も調べられており、4Bモデルでは短いキャプション(gFD 31.48)より中程度(27.91)や長いキャプション(27.77)のほうが良い結果でした。
画像キャプションへの拡張
early-fusionの構成は、逆方向のタスクにもそのまま使えます。著者らはClassifier-Free Guidance用のキャプション脱落(caption dropout)の一部を画像からテキストを生成するI2T教師信号に置き換えました。事前学習予算の10%をキャプション生成に充てるだけで、T2Iの品質をほぼ維持したまま画像説明文の生成が可能になります。
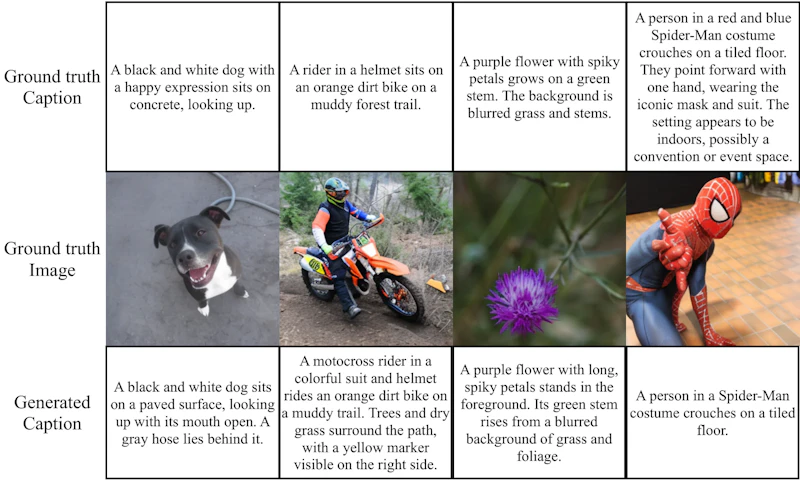
図6の例では、画像の内容を捉えた説明文が生成されています。0.52Bモデルでは条件付きテキストのNLL(負の対数尤度)が約18.4から1.1まで下がり、キャプションの整合性スコアも0.1Bの0.090から4Bの0.559へ改善しました。ただし正解キャプションの0.891には届いておらず、専用のキャプションモデルと肩を並べる水準ではありません。
まとめと今後の展望
Halcyonが示したのは、T2Iに不可欠と考えられてきた大規模言語事前学習が、少なくとも特定の条件下では必須ではないという対照実験の結果です。コードとモデルのチェックポイントは公開され、GPICデータセットとベンチマークも利用できるため、限られた計算資源でも追試の余地があります。
一方で著者ら自身が複数の限界を挙げています。検証は単一データセットかつ256×256解像度のみで、データ混合の対照実験は0.52Bモデルに限られます。介入の対象は自己回帰モデルで、拡散モデルについては同じ結論が成り立つかはわかりません。動画生成も未検証で、画像テキスト対からの同時学習が利得の源泉だと特定できたわけでもありません。
とはいえ、言語理解の獲得経路が複数ありうること、そして画像テキスト対という「言語と視覚が結びついたデータ」自体が言語能力の供給源になりうることを実証的に示した点は、マルチモーダルモデルの設計思想に対する具体的な反証材料になります。より高い解像度や他の生成方式での再現が、次の焦点になるでしょう。
論文情報: "Text-to-Image Generative Modeling Without Language Pretraining"(Keshigeyan Chandrasegaran et al., 2026) arXiv:2610.26863
本記事の図(図1、図5、図6)は解説のため上記論文より引用しています。


