 AI-Papers
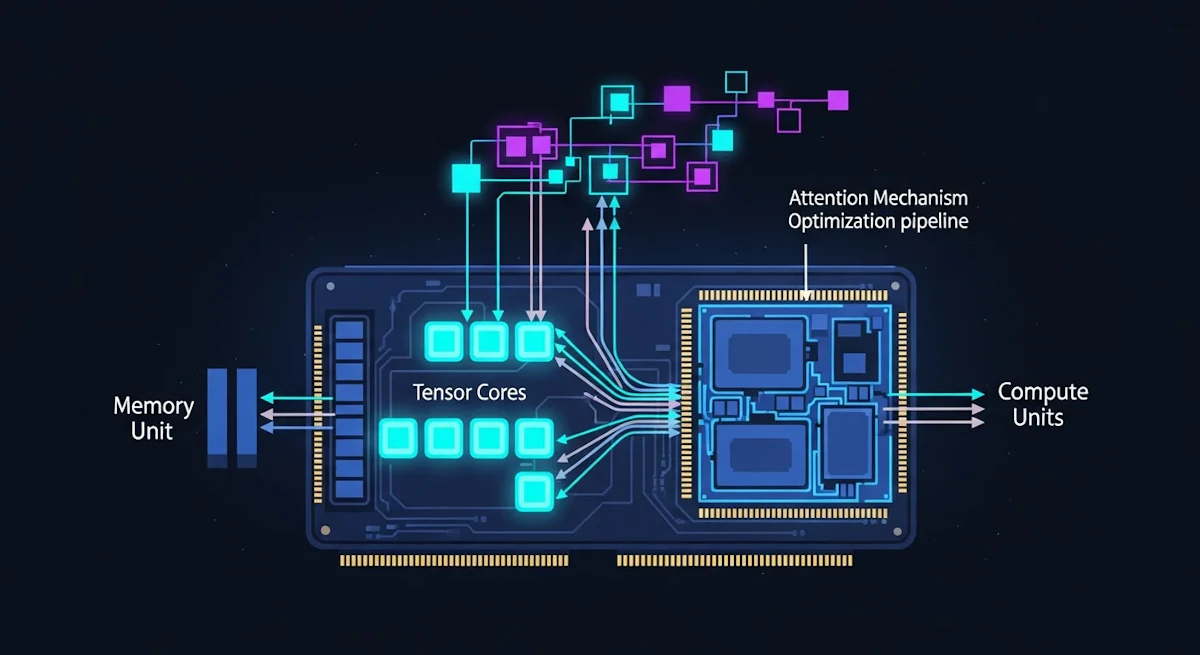
- NVIDIA Blackwellの非対称ハードウェアスケーリングに対応し、cuDNN比1.3倍・Triton比2.7倍の高速化を実現
- 完全非同期MMA操作とsoftmax再スケーリングの最適化でBF16精度で1613 TFLOPs/sを達成
- CuTe-DSLによるPython実装でコンパイル時間を従来比20〜30倍短縮し、開発効率も向上
研究の背景:非対称スケーリングという壁
大規模言語モデル(LLM)の推論・学習において、Attention(注意機構)はボトルネックの一つです。入力トークン数の2乗に比例して計算量が増えるため、長文処理では特に顕著なコストになります。
FlashAttention-2、FlashAttention-3と進化してきたこのシリーズは、メモリ効率と演算効率を両立する手法として広く普及しています。しかし、NVIDIAが2024年末から展開しているBlackwellアーキテクチャ(B200、GB200)は、従来世代とは異なる特性を持ちます。
Blackwellではテンソルコアの演算性能が前世代比2倍に強化されています。ところが共有メモリ(SRAM)の帯域幅や指数関数演算ユニットの強化は相対的に緩やかであり、この非対称な性能バランスが新たな最適化の課題を生みました。FlashAttention-4は、この「非対称ハードウェアスケーリング」に正面から向き合うことをコンセプトに設計されています。
提案手法:3つの協調最適化
本研究はアルゴリズムとカーネルパイプラインを一体で設計する「協調設計(co-design)」という方針を採り、3つの主要な最適化を組み合わせています。それぞれが、Blackwellのどの性能上の偏りに対応するのかを順に見ていきます。
なお、後述するCuTe-DSLはこの3つの協調最適化には含まれず、カーネルをどう記述するかという実装面での別の貢献です。
1つ目は完全非同期MMA操作とタイルサイズの拡大です。行列乗算演算(MMA)を完全に非同期化し、処理パイプラインを再設計することで、テンソルコアの演算が他の処理に待たされる時間を最小化します。またBlackwellの大きなレジスタファイルを活かしてタイルサイズを拡大し、1回の演算で処理できるデータ量を増やしています。
2つ目は指数関数演算とsoftmaxの再スケーリング最適化です。Attentionの核心にあるsoftmax計算には多くの指数関数演算が含まれますが、テンソルコア以外で処理されるこれらの「非matmul演算」がボトルネックになりやすい部分です。FlashAttention-4では条件付きsoftmax再スケーリングのアルゴリズムを改良し、指数関数の呼び出し回数を削減することでこの非対称性に対処しました。
3つ目は逆伝播(バックワードパス)の効率化です。テンソルメモリと2-CTA(Cooperative Thread Array)MMAモードを活用して共有メモリのトラフィックを削減し、アトミック演算のオーバーヘッドも抑えています。学習時に必要な勾配計算の効率が上がることで、ファインチューニングや事前学習での恩恵も大きくなります。
実験結果:BF16で1613 TFLOPs/sを達成
B200 GPUでの評価において、FlashAttention-4はBF16精度で最大1613 TFLOPs/sを記録しました。既存の最適化ライブラリとの比較も含め、主な結果は次の表のとおりです。
比較対象 | FlashAttention-4の結果 |
|---|---|
理論性能比(BF16) | 71%(1613 TFLOPs/s) |
cuDNN 9.13比 | 最大1.3倍 |
Triton比 | 最大2.7倍 |
コンパイル時間(従来のC++実装比) | 20〜30倍短縮 |
理論性能の71%という到達度は、現実的なワークロードで高い演算効率を保てていることを意味します。比較対象のcuDNNはNVIDIAが提供する最適化ライブラリ、TritonはPythonベースのGPUカーネル記述言語で、どちらもAttentionの実装で広く使われています。
同様の課題に取り組む研究として、強化学習でGPUカーネルを自動最適化するCUDA Agentも注目されていますが、FlashAttention-4はAttentionという特定演算に特化した手動設計により、より高い性能を引き出しています。
CuTe-DSLによる開発効率の革新
FlashAttention-4のもう一つの貢献が、実装方法の刷新です。従来のFlashAttentionシリーズはC++テンプレートを駆使した実装でしたが、FlashAttention-4ではCuTe-DSL(Domain-Specific Language)をPythonに組み込む形で実装しています。
CuTe-DSLはNVIDIAが開発したテンソル操作の記述言語で、低レベルのGPUカーネル最適化をより抽象的な記述で行えます。Python上での実装に切り替えた結果が、先の表に挙げたコンパイル時間の20〜30倍短縮です。
C++テンプレートのビルドには数十分かかるケースもありましたが、Python実装ではその障壁が大幅に低くなります。完全な表現力(expressiveness)は維持しつつ開発サイクルが速くなるため、研究者や実装者がアルゴリズムの改良を素早く試せる環境が整います。
まとめと今後の展望
FlashAttention-4はFlashAttention-2、3の系譜を継ぎながら、Blackwellという新世代ハードウェアに対してアルゴリズムとカーネルを一体的に再設計した論文です。性能面での数値改善だけでなく、CuTe-DSLを用いたPython実装によって開発効率も大きく高めました。
NVIDIAのBlackwell GPUはデータセンターへの実導入が進みつつある段階であり、LLMの学習・推論インフラにFlashAttention-4が組み込まれれば、スループットの改善が直接コスト削減や長文処理能力の向上につながります。一方で、本手法はBlackwellの特性に特化した設計であるため、将来の新アーキテクチャへの対応には再設計が必要になる可能性があります。


