 AI-Papers
- ルーティングインデックスをクロスデコーダ全16層で共有することで、128Kコンテキストにおける全体スループットを標準Transformerの17.1倍に向上
- トークンレベルの精密な疎アテンションを維持しながらデコーディングを7.6倍高速化し、言語モデリングの損失劣化はほぼゼロ
- YOCO(You Only Cache Once)アーキテクチャを基盤に構築され、プリフィル・KVキャッシュ・デコーディングという推論の3大ボトルネックを同時に解決
研究の背景と課題
LLMが長いテキストを処理するとき、主に3つのボトルネックが生じます。入力全体を一度に処理する「プリフィル」の計算コスト、過去の計算結果をメモリに保持する「KVキャッシュ」のサイズ、そして新しいトークンを生成するたびに全履歴を参照する「デコーディング」の繰り返しコストです。
特にデコーディングは文脈長に比例してコストが増大するため、128Kトークンのような超長文脈では推論速度が著しく低下します。根本的な原因は、GPUメモリの帯域幅がKVキャッシュ全体の読み出しで飽和してしまう点にある。
これを解決するアプローチとして「疎アテンション(Sparse Attention)」があります。全トークンを参照するのではなく、重要なトークンだけを選んで計算する手法です。
ただし、従来の疎アテンションにはブロック単位での選択(高速だが粗い粒度)とトークン単位での選択(精密だが各層でのルーティング計算が重い)というトレードオフがありました。各層で独立してtop-k計算(スコアの高い上位k個のトークンを選び出す処理)を行う手法では、128Kスケールになるとそのルーティングコスト自体が密なアテンションに匹敵するほど大きくなってしまいます。
CLSAの仕組み
CLSA(Cross-Layer Sparse Attention with Shared Routing)は、「You Only Cache Once(YOCO)」という既存アーキテクチャを土台として構築されます。YOCOはモデルを2段構成にしており、前半の「自己デコーダ(self-decoder)」がKVキャッシュを1度生成し、後半の「クロスデコーダ(cross-decoder)」がそれを共有・再利用します。
CLSAはここに「ルーティングインデックスも1度だけ計算して共有する」という発想を加えます。自己デコーダがKVキャッシュを生成する際、同時に「各クエリトークンに対してどのKVペアが重要か」を示すtop-kインデックスを計算します。このインデックスが後続の全クロスデコーダ層でそのまま再利用されるため、各層でのルーティング計算コストはほぼゼロになる。
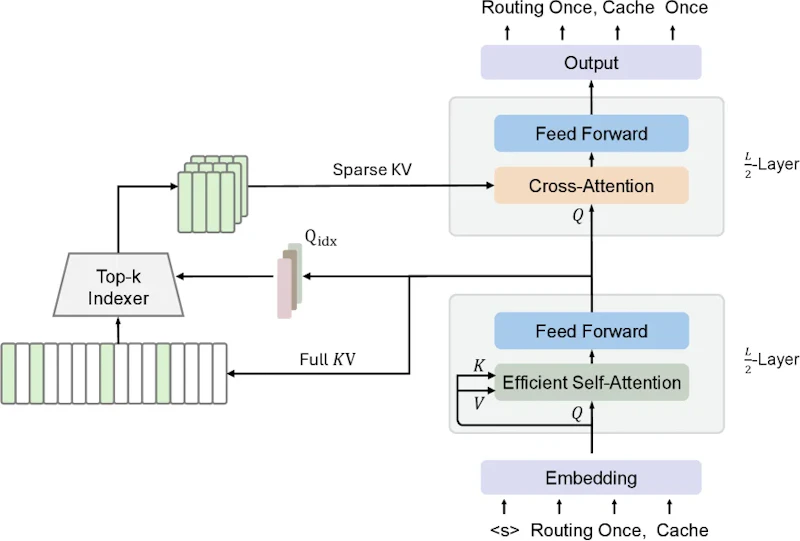
この設計が成立する根拠は「重要なトークンはレイヤーをまたいで比較的安定している」という観察です。ある層で重要とみなされたトークンは、隣の層でも重要である確率が高い。だからこそルーティング結果を共有しても精度が保たれます。実験では2048トークンを選択することで注意スコア全体の約80%をカバーできることが示されています。
計算コストの削減効果
論文の計算量分析によると、従来のトークン疎アテンション(DSA)ではデコーディング時のルーティングコストが「ηLN」(ηはtop-k比率、Lはレイヤー数、Nは文脈長)と全レイヤーに比例します。CLSAでは「ηN」(1度だけ計算)に抑えられます。128Kのような長文脈では、この差が推論速度の数十倍の開きに直結します。
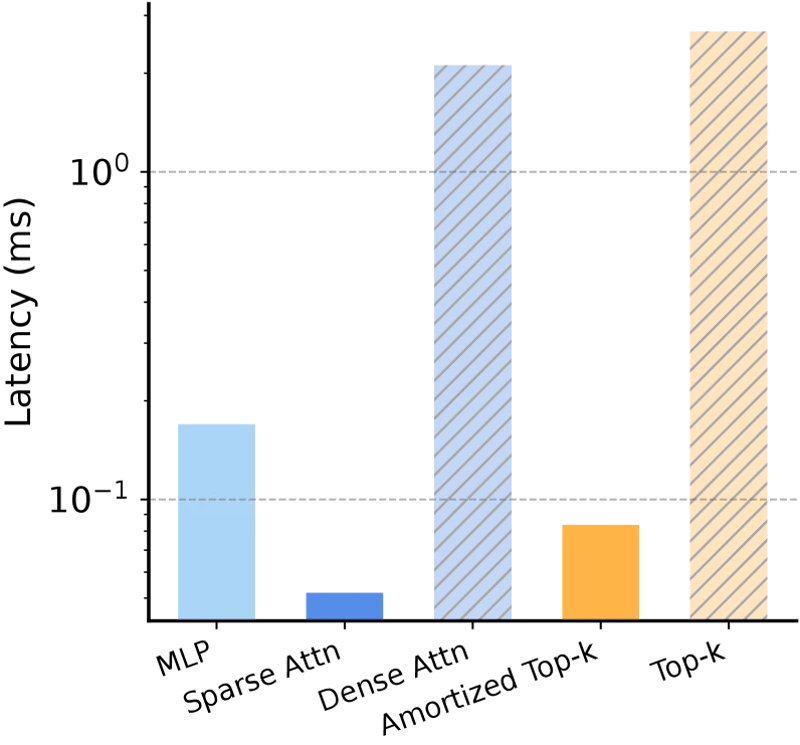
精度への影響
疎化によって出力品質が劣化しないかどうかは重要な問いです。論文ではBooks、ArXiv、StarCoderの3データセットで、密なアテンションとCLSAの損失値を8Kから32Kトークンの範囲で比較しています。
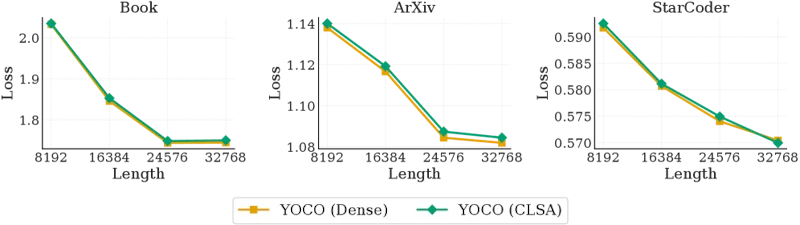
損失の差は最大でも0.0054(Booksデータセット)と無視できる水準で、StarCoderではむしろ疎の方がわずかに損失が低いケースもありました。下流タスクでもARC-Challenge、GSM8K、DROPで同等以上の性能が確認されており、実用上の品質劣化はほぼないと評価できます。
推論速度の改善結果
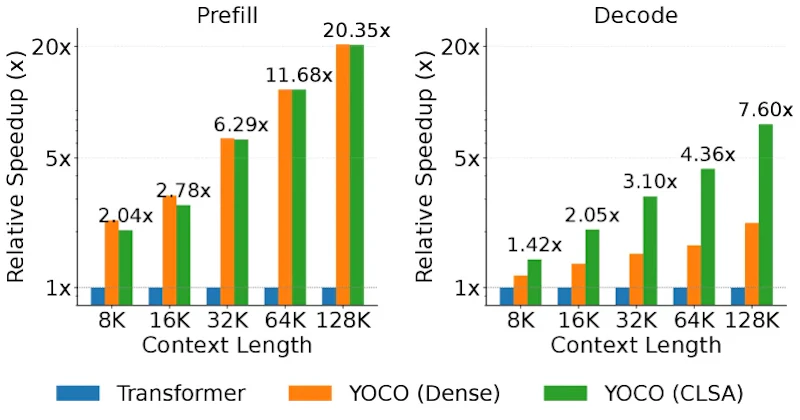
NVIDIA B200 GPUを使用した実験では、128Kコンテキストにおいて標準Transformerと比較して全体スループットが17.1倍、デコーディングスループットが7.6倍に向上しました。プリフィルにおいてもYOCOアーキテクチャの恩恵により大幅な高速化が得られています。
項目 | 標準Transformer | CLSA | 倍率 |
|---|---|---|---|
全体スループット | 62.53トークン/秒 | 1,068.06トークン/秒 | 17.1倍 |
デコーディングスループット | 431.16トークン/秒 | 3,276.80トークン/秒 | 7.6倍 |
文脈長が長くなるほど、この差は拡大する傾向にあります。
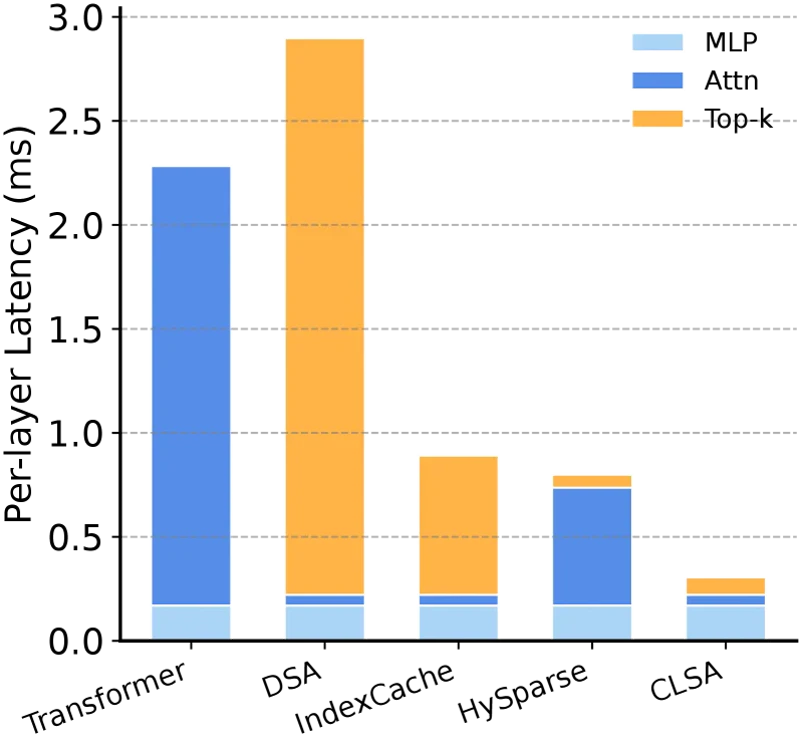
他の疎アテンション手法との比較では、CLSAが最も低いレイヤーあたりレイテンシを達成しています。IndexCacheが4層にしかインデックス共有を適用しない部分的な実装にとどまるのに対し、CLSAは全クロスデコーダ層にわたって完全に計算を償却している。
LLMの推論高速化はDominoのような投機的デコーディング手法など複数のアプローチで研究が進んでいますが、CLSAはアーキテクチャ設計の段階で効率を作り込む補完的なアプローチです。
まとめと今後の展望
CLSAは「ルーティング計算を1度だけ行い、複数層で共有する」という原則によって、トークンレベルの精密な疎アテンションを維持しながら推論コストを大幅に削減しました。プリフィル・KVキャッシュ・デコーディングという長文脈推論の3大ボトルネックを同時に解決した点が最大の貢献です。
今後の課題として、YOCO以外のKV共有アーキテクチャへの適用、512Kを超えるさらに長い文脈での検証、そして学習済みモデルへの事後的な疎化適用手法の整備などが挙げられます。128Kコンテキストで全体スループット17.1倍・デコーディング7.6倍という速度向上を、損失差0.0054以内という品質で達成した点が、本手法の到達点である。
論文情報: "You Only Index Once: Cross-Layer Sparse Attention with Shared Routing"(Yutao Sun et al., 2026) arXiv:2606.06467
本記事の図(図1〜図5)は解説のため上記論文より引用しています。


